RAG不是终点:开发者正转向什么样的AI架构

拆解AI Agent与RAG的生产现实:定义混乱、切块缺陷与框架噪音背后,真正重要的是系统设计能力。
这篇文章直面AI Agent与RAG在生产环境中的真实处境,指出"Agent"概念的泛滥导致了实际工程决策的混乱。作者给出的核心定义是:Agent应拥有目标而非仅有指令,能自主决策、处理失败并判断任务完成。在实际落地中,成功的部署往往是窄而专的流水线,团队的精力应集中在工具设计、失败处理和可观测性上,而非不断追逐新模型。对于RAG,作者指出切块边界错误是核心问题,修复方向在于重新思考信息的存储结构。框架之争被认为是干扰,真正持续奏效的是先规划后执行、检索与推理分离、显式交接等架构模式。文章最终指向一个判断:未来最有价值的AI工程师擅长的是治理、可观测性与可靠工具使用,这是一套接近系统设计而非模型研究的能力。
在AI领域工作久了,你会发现一个没人愿意完全说破的真相:Demo里展示的东西,和生产环境中真正跑起来的系统之间,存在巨大的鸿沟。这篇文章试图诚实地谈谈——AI Agent和RAG到底处在什么阶段,以及真正在交付产品的工程师们正在转向什么。
我们谈论AI Agent的方式出了问题
现在所有东西都被叫做"Agent"。一个调用工具的函数?Agent。带记忆的聊天机器人?Agent。一个带循环的脚本?也是Agent。
这种概念稀释不只是语义问题,它正在导致实实在在的工程错误。当你对自己正在构建的东西没有精确定义时,你会对简单的流水线过度工程化,又对真正复杂的系统投入不足。原文作者提到,他见过团队花费数周给本可以用一个结构良好的Prompt解决的工作流,强行加上"Agentic"编排逻辑。
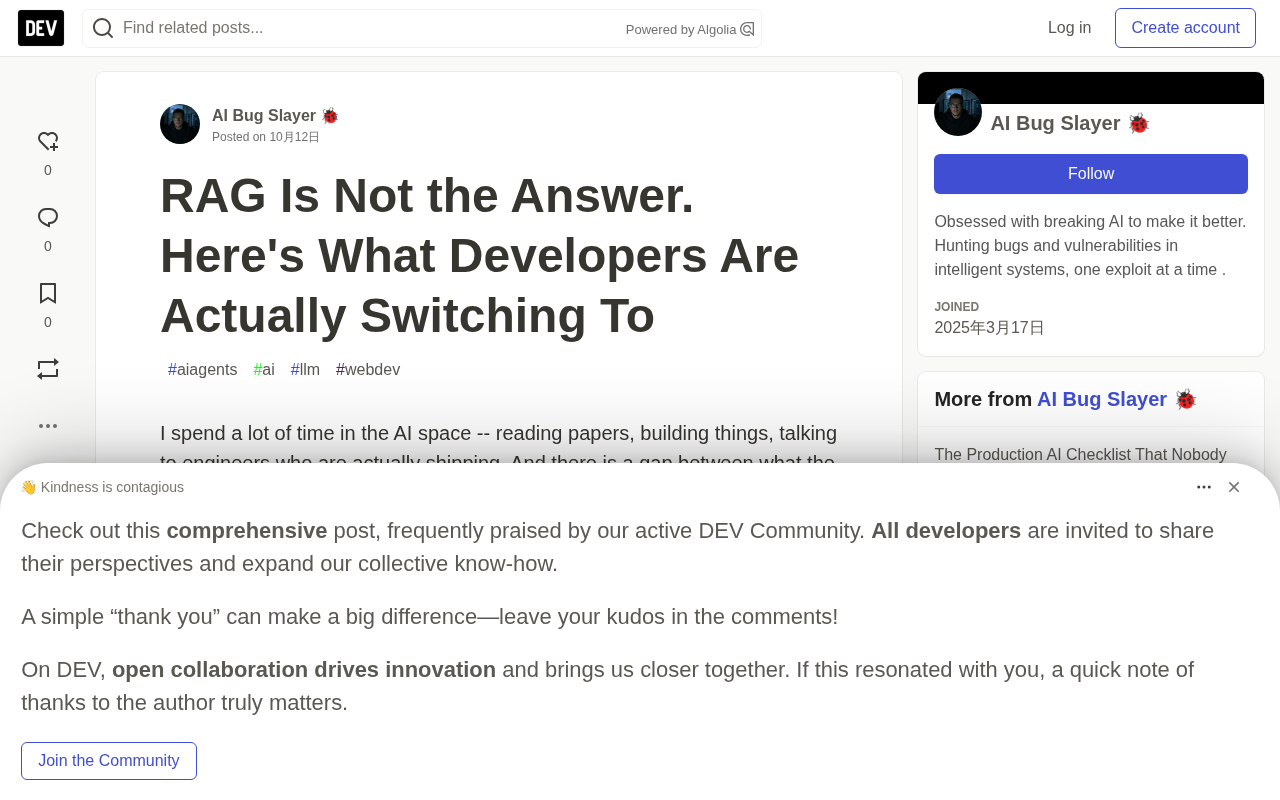
作者给出的定义值得记住:Agent是一个拥有目标(objective)而非仅仅是指令(instruction)的系统。它自己决定下一步做什么,它处理失败,它知道任务何时完成。除此之外的一切,不过是花哨的函数调用。
判断标准可以这样拆解:
- 如果你的系统需要人类告诉它每一步该做什么,那它不是Agent,而是一个聊天界面。
- 如果你的系统能从失败的工具调用中恢复、尝试另一种方法,你开始接近Agent了。
- 如果你的系统能把一个目标分解成子任务并进行委派,那才是真正的Agent。
生产环境里真正发生的事
从作者接触和跟踪的团队来看,真实情况是这样的:绝大多数真正落地的Agent部署都很窄。它们只做一件事,但做得很好——客服工单分类、文档信息抽取、针对特定代码库的代码审查。它们不是通用推理引擎,而是在决策层嵌入了一点智能的专用流水线。
真正拿到好结果的团队,不是在追逐最新的模型发布,而是在死磕三件事:
- 工具设计:Agent究竟能调用什么,接口是否干净。
- 失败处理:当工具返回无用结果时会发生什么。
- 可观测性:你能否精确追溯Agent为何做出某个决策。
而拿到糟糕结果的团队,往往是那些把GPT-4换成最新的前沿模型,却不改动其他任何东西,就指望行为变好的人。
这一点与业界近期的讨论相互印证。TechCrunch报道中,有高管认为语音AI还没迎来它的"ChatGPT时刻",原因之一正是语音系统经常在上下文层遗漏关键信息,导致整条流水线崩溃——这恰好呼应了作者强调的"失败处理"的重要性。微软CEO Satya Nadella也公开表示,AI模型需要一个"紧急刹车",是时候"退一步重新评估AI的信任架构"了。信任与可靠性,正成为行业共识。
框架之争是一种干扰
LangChain、LangGraph、CrewAI、AutoGen、Semantic Kernel——每个月都会冒出一个新框架,然后有人写文章论证旧的那个"已死"。
作者的观点很直接:框架远不如模式(patterns)重要。无论你用哪个框架,真正持续奏效的是这些架构模式:
- 先规划后执行(Plan-then-execute):用一个推理步骤产出计划,再用一个独立的执行步骤去遵循它。不要把两者混在一起。
- 把检索与推理分离:获取上下文和使用上下文是两件不同的工作,把它们混为一谈的系统会陷入混乱。
- 显式交接(Explicit handoffs):当一个Agent把工作传递给另一个时,交接应当是结构化、可记录的,而不是通过Prompt传递的一个字符串。
作者说他曾用三个不同的框架重建同一套架构,每次结果都差不多。框架是脚手架,架构才是建筑本身。
这里提到的几个框架在定位上存在明显差异,了解这些差异有助于理解为何"框架之争"容易让人迷失。LangChain是最早普及"链式调用"概念的框架,提供大量预制的工具集成和检索管道,适合快速原型;LangGraph是其衍生项目,专门用有向图(DAG)描述多步骤、有条件分支的Agent工作流,更接近状态机模型。CrewAI和AutoGen则聚焦于多Agent协作,前者以"角色扮演"隐喻组织Agent团队,后者来自微软研究院,强调Agent之间通过对话协商完成任务。Semantic Kernel是微软面向企业的SDK,与Azure生态深度绑定。这些框架解决的是不同层次的问题,但它们共同的局限在于:框架能降低搭建成本,却无法替代对架构模式的理解。一个用LangChain堆砌的系统,如果把检索与推理混在同一步骤里,换成任何框架都无法变得可靠。
没人真正解决的检索问题
RAG如今已是标配,几乎每个接触专有数据的生产AI系统都在用某种形式的检索增强。但有一个教程里很少讲清楚的问题:切块边界是错的(chunk boundaries are wrong)。
当你把文档切成块并做向量化时,你实际上是在假设哪些上下文片段应该归属在一起。而这些假设往往是错的。一个只有结合上一段才有意义的段落,被孤立地检索出来,模型只能幻觉出缺失的上下文。
改进的路径有几层:
- 更好的切块策略会有帮助——重叠窗口、语义切块、父文档检索。
- 但真正的修复方向是重新思考你到底在存储什么。有时候正确的做法不是存储原始文本,而是存储信息的结构化表示。
作者的经验法则很实用:如果你的RAG流水线返回的是"技术上正确但语境上无用"的结果,问题几乎一定出在切块或元数据上,而不是嵌入模型。换句话说,RAG本身不是答案——围绕检索的信息组织方式才是开发者正在重新审视和转向的重点。
理解这个问题需要先了解RAG(检索增强生成)的基本工作方式。RAG流水线通常分三步:首先将文档切割成若干文本块(chunk),对每块做向量嵌入(embedding)并存入向量数据库;用户提问时,将问题也做向量化,通过余弦相似度等方式检索出最接近的若干块;最后把检索到的块拼入Prompt,交给语言模型生成答案。整个机制的隐含前提是:每个块在语义上是自洽的——模型只看这一块就能理解它的含义。然而现实中文档的信息结构往往跨段落甚至跨章节存在依赖关系,例如"如上表所示"、定义在第一节而使用在第三节的术语、以及需要结合前文假设才有意义的结论句。固定大小的切块策略(如每500 token一刀切)完全无视这种结构,导致检索到的片段缺失关键上下文,模型只能用幻觉填补空白。这正是作者所说的"切块边界是错的"的根本原因。
这一切将走向何方
模型会继续变强,上下文窗口会继续扩大,每Token的成本会继续下降。但这些都不会改变那个根本的工程挑战:构建你在不盯着的时候也能信任其行为正确的系统。
这才是值得解决的问题——治理(Governance)、可观测性(Observability)和可靠的工具使用,而不是追逐Benchmark排名。
作者给出了一个颇具分量的判断:未来真正重要的工程师,是那些能构建出"其他工程师可以维护和信任"的AI系统的人。这是一套与微调或Prompt工程截然不同的技能,它更接近系统设计,而非模型研究。
对于正在构建AI系统的团队来说,这或许是最值得记住的一句话:最有价值的讨论不在那些发布会的主题演讲里,而在人们诚实交流"什么真正有效"的技术讨论串中。
可观测性(Observability)在AI系统语境下有特定含义,值得单独说明。在传统软件工程中,可观测性指通过日志、指标和追踪三类信号来理解系统内部状态。迁移到AI Agent场景后,这一概念面临新的挑战:一次Agent运行可能涉及数十次LLM调用、工具调用和中间推理步骤,任何一环出错都可能导致最终答案偏差,而错误原因极难从输入输出直接推断。目前业界正在发展的AI可观测性实践包括:对每次LLM调用记录完整的Prompt与响应(prompt tracing)、追踪工具调用的入参和返回值、记录Agent的"思考链"(chain-of-thought)以便事后审计,以及对检索步骤记录哪些文档块被召回、相似度得分是多少。LangSmith、Langfuse、Arize Phoenix等工具正在填补这一空白。没有这层可观测性,工程团队面对生产环境中的异常行为几乎只能靠猜测,这也是为何作者将其列为与工具设计、失败处理并列的核心能力。
相关推荐
Underdog Saluki 27B:2-Bit量化下的工具调用实战指南
深入解读 Underdog Saluki 27B 基于 GSQ-RCO 的 2-bit 量化方案,涵盖 GGUF 头部结构、内存占用分析与原生 llama.cpp 下的 BFCL 工具调用实测要点,助你评估低比特量化模型的实用边界。
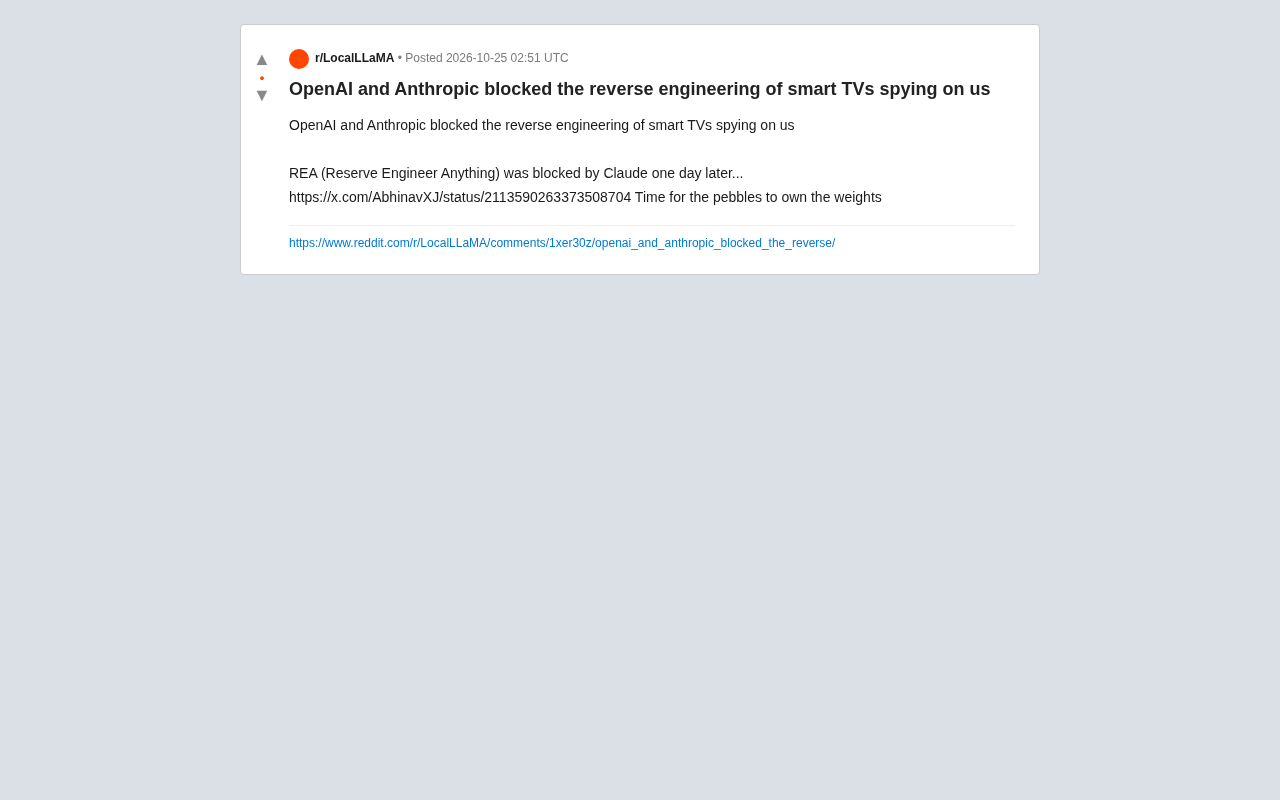
OpenAI与Anthropic限制智能电视逆向工程,引发AI伦理争议
OpenAI与Anthropic限制智能电视逆向工程项目REA,引发AI安全与开放研究争议。本文分析事件背景、隐私隐患及AI公司的使用政策,探讨平衡之道。

GPU-unlock:解锁 Nvidia 3000 系显卡的 FP/BF16 指令发射率
gpu-unlock 项目探索 Nvidia 3000 系显卡在 FP16/BF16 计算上的指令发射率限制,本文解读其测量方法、解锁思路、社区争议以及对 GPU 性能优化的实际意义。