RAG还是微调?先诊断故障再决定是否换模型
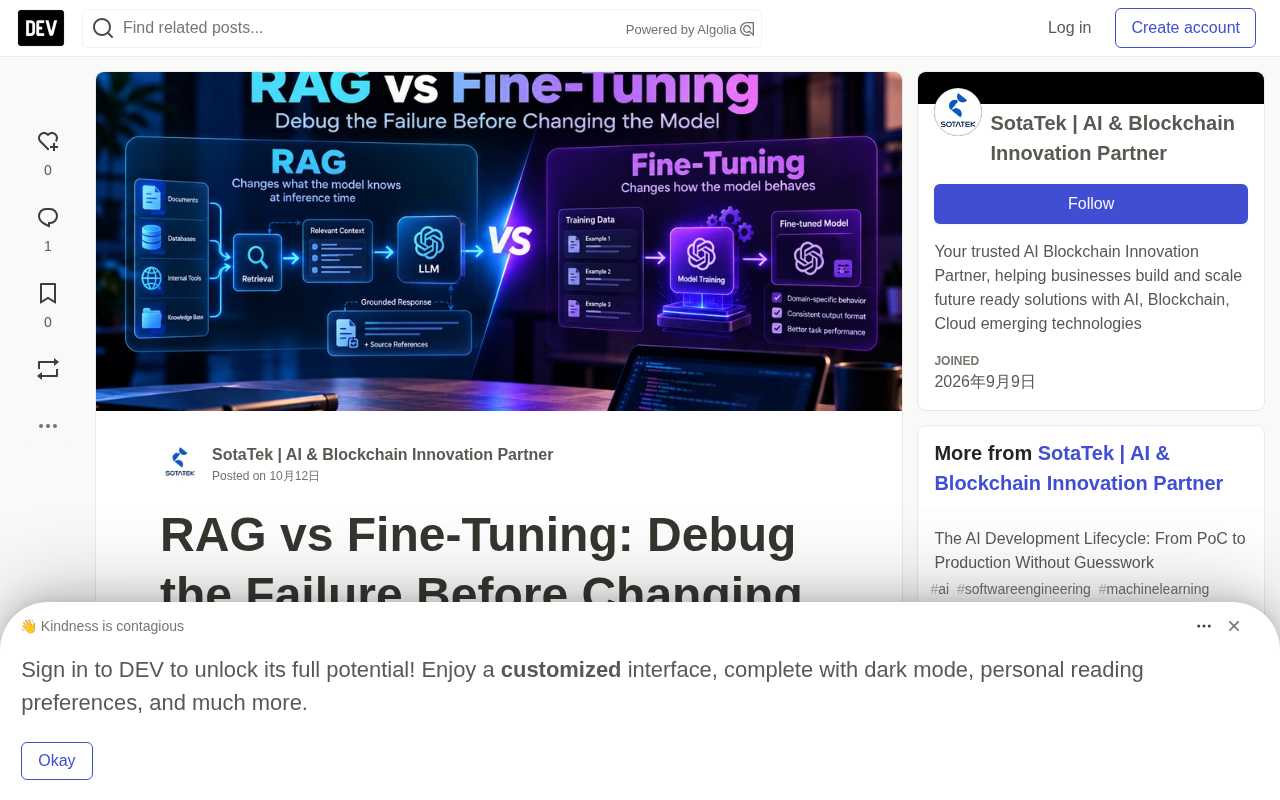
诊断LLM应用失败的关键:先分清是检索失败还是行为失败,再选RAG或微调。
本文提出一个工程实践核心原则:LLM应用出现问题时,不要急于更换模型或引入复杂技术,而应先定位失败发生在哪一层。文章将问题分为两类——知识访问失败(模型拿不到正确信息)和行为失败(模型拿到信息却输出不符合要求),分别对应RAG和微调两种不同的解法。通过"检索→上下文→生成"三层诊断框架,结合Recall@K与可溯源性等独立指标建立基线,工程师可以精准定位问题根源。文章还指出生产级RAG涉及权限过滤、重排序、引用映射等多个组件,微调则需防止能力回退并控制数据集泄漏。最终的决策准则是比较每个成功业务任务的总系统成本,而非单次推理成本,只有当提升足以抵消复杂度时才保留相应方案。
当一个大语言模型(LLM)应用给出糟糕的答案时,工程师的第一反应往往是——换个更大的模型、往提示词里塞更多示例、用领域数据微调,或者干脆接入一个向量数据库。
但这些干预手段解决的是不同的问题。用错了方法,只会在不改善结果的前提下徒增成本与复杂度。SotaTek 的这篇工程实践文章提出了一个清晰的核心观点:在改模型之前,先定位失败发生在哪一层。
两类失败,两种本质
文章用两个典型案例切开了问题。第一个场景:一个企业助手给出了过时的答案,因为最新的政策文档从未送达模型。第二个场景:一个分类系统拥有所需的全部信息,却反复输出格式不一致的结果。
这两者有本质区别。前者是知识访问问题——模型根本拿不到正确信息;后者是行为问题——模型拿到了信息却不会按要求处理。
对应地,两种技术改变的东西也完全不同:
- RAG(检索增强生成) 改变的是模型在推理时能访问到的信息,模型权重保持不变。
- 微调(Fine-Tuning) 改变的是模型学到的行为,通过额外训练样本强化期望的输出模式。
理解这个差异,是避免南辕北辙的前提。用微调去解决一个检索失败的问题,就像给送不到货的物流系统换一个更聪明的收货员。
三层诊断:找到真正失败的那一层
文章给出的最实用框架,是把问题拆成三个层次来排查:
检索层(Retrieval)
诊断问题:系统有没有找到正确的证据?若没有,应改进搜索、元数据、分块(chunking)或重排序(reranking)。
分块(Chunking) 是 RAG 系统中将文档切割为可检索单元的过程,直接影响检索质量。切块过小会丢失上下文语义,切块过大会导致向量相似度被稀释、无关内容混入。常见策略包括:按固定 token 数切割(Fixed-size)、按句子或段落切割(Semantic)、以及为保留上下文而设置重叠窗口(Sliding Window)。重排序(Reranking) 则是在初步向量检索召回若干候选片段后,用另一个专门的排序模型(如 Cross-Encoder)对候选集重新打分,以提升最终进入上下文的片段精度。两步架构之所以优于一步检索,是因为向量相似度擅长快速粗筛大规模语料库,而 Cross-Encoder 虽然计算开销更大,但能更细致地理解查询与段落的语义匹配程度。当 Recall@5 等检索指标偏低时,优化分块策略和引入重排序往往比更换更大的生成模型更有效。
上下文层(Context)
诊断问题:相关证据有没有真正进入模型的上下文窗口?若没有,应优化上下文选择和提示词构造。
生成层(Generation)
诊断问题:模型有没有正确使用这些证据?若没有,才考虑改进提示词、增加校验,或评估是否需要微调。
这个区分能避免一个极其常见的错误。设想一个必须回答内部安全政策的企业助手,正确的政策明明存在于知识库中,但检索始终把它排在前五名之外。此时换一个更大的 LLM 或许能生成更有说服力的回答,却无法可靠地使用一份根本没进入上下文的证据。正确的修复点在检索管线,而非模型训练。
先建立基线,再谈改变
在引入 RAG 或微调之前,文章强调必须用具有代表性的测试用例建立基线。作者给出了一组示意性指标:
| 指标 | 基线 |
|---|---|
| 回答准确率 | 71% |
| 可溯源性(Groundedness) | 68% |
| 格式合规率 | 91% |
| 检索召回率 Recall@5 | 62% |
即便是这样一组小样本数据,也已经指明了方向:检索召回率偏弱,而格式合规率已经不错。这意味着系统更可能是因为检索不到所需信息而失败,而非行为问题。在没有进一步证据前,微调不该是第一个干预手段。
关键原则是:对检索层和生成层分别评估。 文章提供了一段简化的评估代码,先计算 recall_at_5,再独立生成答案。否则,单一的答案质量分数只能告诉你"失败了",却无法指出该去哪里排查。
Recall@K 是衡量检索质量的核心指标,表示在系统返回的前 K 个结果中,有多少比例的"真正相关"文档被成功找到。例如 Recall@5 = 62% 意味着在 100 次查询中,有 62 次的正确答案出现在了前 5 条检索结果里。这个指标与生成答案的质量评估相互独立——即使生成层表现完美,若相关文档根本未进入前 K 名,系统也注定失败。可溯源性(Groundedness) 则衡量模型生成的答案有多少比例能被检索到的上下文文档所支撑,用于发现模型"凭空编造"(幻觉)的情况。将这两个指标分开追踪,才能准确定位问题究竟出在检索管线还是生成模型,而不是用一个综合的"答案准确率"把两类失败混在一起。
生产级 RAG 远不止一个向量数据库
一个基础的 RAG 实现常被描绘成:文档 → 向量化 → 向量库 → LLM。这足以演示概念,但生产环境的检索通常还需要文档解析、分块与元数据富化、向量/词法/混合检索、查询改写、权限感知过滤、重排序、上下文选择、引用映射以及检索与可溯源性评估等一系列组件。
文章特别点出多租户企业应用的安全要点:检索必须在文档进入模型之前就强制执行用户权限。事后再对答案做过滤,并不能替代"从源头阻止未授权上下文进入生成管线"。而且授权应由可信的应用层强制实施,绝不能委托给模型或一句提示词指令。
换句话说,如果正确信息本已可得但检索质量很差,应先优化检索系统,再去假设模型需要微调。
混合检索(Hybrid Search) 结合了向量检索(基于语义相似度)和词法检索(如 BM25,基于关键词匹配)的优势。纯向量检索在语义理解上表现出色,但对精确术语、产品编号、专有名词等可能出现"语义漂移";BM25 等词法检索对精确匹配更敏感,但无法捕捉同义词或语义近似。生产系统通常通过 RRF(倒排序融合)或加权求和等方式将两类检索结果合并,以兼顾语义理解与精确匹配。查询改写(Query Rewriting) 则是在检索前对用户原始问题进行扩展或转化,例如将口语化问题改写为更接近文档用语的形式,或拆分复合问题为多个子查询分别检索,从而提升召回率。这两项技术都作用于检索阶段,是在动用微调之前值得优先尝试的优化手段。
什么时候才轮到微调
微调真正值得评估的场景,是模型已经获得了充分信息,却反复无法按要求完成任务。典型信号包括:
- 尽管指令清晰,输出 schema 仍不一致;
- 同一专业分类任务结果不稳定;
- 领域术语反复被误解;
- few-shot 示例让提示词变得过于臃肿;
- 需要让一个更小的模型复现大模型此前的行为。
但微调绝非自动成为下一步。训练之前,先检查这个失败能否用更清晰的指令、结构化输出约束、更好的示例或更简单的应用逻辑来解决。
如果确实有必要微调,务必保持训练集、验证集和最终评估集相互隔离(文章给出约 70/10/20 的切分示例)。对生产数据,还应按客户、文档、时间段或来源记录等合适的单位切分,避免近似重复样本在数据集间泄漏。训练后更要同时评估目标行为的提升和原有能力的回退——一个改善了格式却丧失通用能力的模型,可能并不划算。
比的是系统总成本,不是模型成本
文章提醒:RAG 和微调只是把工程与运营成本转移到了不同的地方。
- RAG 增加的是检索基础设施和运行时开销(检索、重排序增加步骤,检索上下文可能很大),但天然支持知识更新和来源溯源。
- 微调增加的是数据集准备、训练、验证、产物管理和模型版本维护,知识更新可能需要再跑一轮训练,且模型权重本身不提供溯源能力。
正确的比较口径是每个成功业务任务的总成本,包含重试、人工审核、基础设施与运维。单次请求的推理成本更低,并不必然等于单次成功结果的成本更低。
当两种技术都有必要
有些应用确实两个问题都存在。比如一个企业合规助手,既要检索最新法规和内部政策(RAG 提供当前、可溯源的知识),又要套用组织特定的分类方案输出结构化结论(若评估证明仅靠提示词不够,微调可以帮上忙)。
它们作用在不同的层次,可以组合。但组合必须是基于证据的决策——即使模型已微调成功,不相关的检索上下文仍可能引入噪声。作者建议把基线、仅 RAG、仅微调、混合方案放在同一套留出评估集上对比,只有当提升足以抵消额外复杂度时,才保留混合架构。
一个可落地的决策序列
文章最后给出了清晰的决策路径:
- 从基础模型开始。若提示词和输出约束就能达到评估目标,直接上线。
- 若不能,先诊断失败:是知识缺失/过时,还是行为不一致?
- 知识问题 → 优先评估 RAG;行为问题 → 评估微调。
- 两个问题都存在 → 独立评估两种干预后再考虑组合。
- 若基础模型已满足验收标准,不要在没有可量化理由时增加任何基础设施。
归根结底,RAG 和微调并不是让 LLM "更聪明"的两种竞争方案,它们应对的是不同的失败模式:RAG 改变模型可用的证据,微调改变模型学到的行为。真正的工程挑战,是判断哪一层正在失败,并用数据证明你的干预确实改善了结果——这需要代表性评估数据、明确指标、可靠检索、受控访问、回归测试和生产监控,而不只是挑一个模型或一个向量数据库。
相关推荐

恒星究竟能有多大?最大恒星的物理极限
红超巨星是宇宙中体积最大的恒星,半径可达太阳的2000倍,吞没内太阳系。但恒星尺寸没有精确上限,模型预测可达15000倍太阳半径。质量最大的蓝色恒星体积远小于红超巨星——最大和最重是两回事。

苹果HomeView智能屏全功能解析:墙挂桌面两用,299美元
苹果发布299美元智能显示屏HomeView,支持壁挂和桌面两种安装方式,配备1200万像素摄像头实现面部识别,可控制智能家居、播放音乐、发送食谱到屏幕逐步跟做。本文全面解析HomeView的表盘、应用扩展、隐私保护和烹饪集成等核心功能。

承诺的新工作室去哪了?Craft Computing用五年时间给出答案
Craft Computing主理人回应观众质疑:承诺五年的新工作室因建设成本从3万暴涨至7.5万美元而搁浅,最终改为168平方英尺车库改造空间。频道收入因算法变化下滑,内容方向也将转向更务实的项目制作。