让LLM变笨?性能节流与可信降智的实证研究
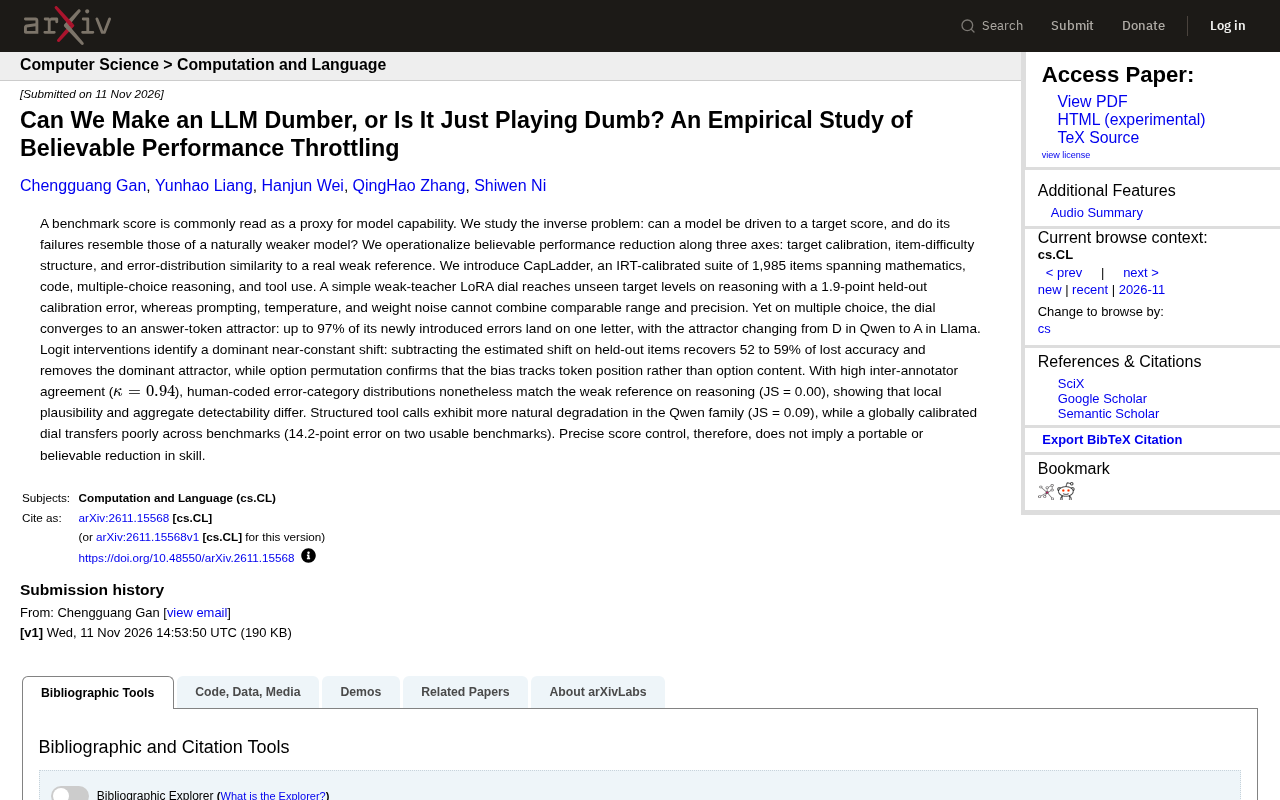
研究用弱教师LoRA实现精确降智,但发现局部可信、全局可检测且跨任务不可移植。
该研究系统探讨了“可信性能节流”的可行性,即主动将LLM能力降低到指定水平,并检验其错误是否像真实弱模型。团队构建了IRT校准的CapLadder测试套件(1,985项),提出弱教师LoRA方法,在推理任务上留出集校准误差仅1.9个百分点,优于提示、温度和权重噪声。然而,多项选择任务暴露出“答案token吸引子”:97%的新增错误集中在一个字母上,且因模型族而异,logit干预可恢复52%–59%的丢失准确率。推理任务的错误类别分布与真实弱模型高度一致(JS=0.00),但跨基准迁移出现14.2个百分点误差。结论是精确分数控制不等于可移植或可信的技能降低,基准分数作为能力代理的可靠性需重新审视。
引言:当基准分数成为可操控的目标
在AI领域,基准测试分数常被视为模型能力的直接代理。但一个反向问题正引发研究者的兴趣:我们能否主动将模型性能降低到指定水平?更重要的是,这种人为的"变笨"过程,其失败模式是否与真正较弱的模型相似?一篇题为《Can We Make an LLM Dumber, or Is It Just Playing Dumb?》的实证研究,首次系统性地探讨了"可信性能节流"(believable performance throttling)的可行性与边界。
研究者提出了三个评估维度:目标校准(能否精确达到目标分数)、项目难度结构(错误是否集中在合理难度的题目上)、以及与真实弱参考模型的错误分布相似性。基于此,他们构建了CapLadder——一个包含1,985个项目的IRT校准测试套件,覆盖数学、代码、多项选择推理和工具调用。

IRT(项目反应理论) 是一种用于教育测量和心理测量的统计框架,其核心假设是:被试在题目上的正确概率由被试的潜在能力参数与题目的难度、区分度等参数共同决定。在本研究中,IRT校准意味着CapLadder中每个项目的难度参数是经过IRT模型估计的,而非简单按主观难度或通过率排序。这使得研究者能够将模型能力映射到一个连续的潜在特质尺度上,从而精确设定“目标分数”对应的能力水平,并据此选择合适难度的题目来评估模型是否真正达到了该水平。IRT的价值在于,它提供了题目难度与模型能力之间的可比较标尺,使得“把模型调到某个分数”这一操作具有统计上的可解释性,而非仅仅是在某个固定测试集上凑出目标正确率。
方法:弱教师LoRA旋钮与多干预对比
研究团队设计了一种"弱教师LoRA"方法,通过在模型上添加一个轻量级的LoRA适配器,将强模型的能力"调低"到指定水平。在推理任务上,该方法能够达到未见过的目标水平,留出集校准误差仅为1.9个百分点。
相比之下,提示工程(prompting)、温度调整(temperature)和权重噪声(weight noise)都无法同时实现可比的调节范围和精度。这意味着,通过微调实现的性能节流在可控性上远优于推理时的启发式干预。
但研究者并未止步于此。他们进一步检验了这种节流的"可信度"——即它产生的错误是否像真实弱模型那样自然分布。
LoRA(低秩适配,Low-Rank Adaptation) 是一种参数高效微调技术,它不修改原模型的全部权重,而是在Transformer层的特定线性变换旁注入两个低秩矩阵的乘积作为增量更新。训练时只更新这两个小矩阵,参数量通常仅为原模型的0.01%–1%。本研究所称的“弱教师LoRA”是指:以一个能力被刻意限制的“弱教师”模型(或弱化后的信号)为目标,训练一个LoRA适配器,使其叠加到强模型上后,将强模型的输出行为拉低到指定能力水平。由于LoRA只改变一个低秩子空间,它比全参数微调更轻量、更易切换,但这也意味着其调节能力存在子空间约束——这可能是跨基准迁移失败的原因之一。理解LoRA的低秩瓶颈,有助于解释为何旋钮在特定基准上校准良好,却在另一基准上出现较大偏差。
关键发现:答案token吸引子与错误分布
在多项选择任务上,弱教师LoRA旋钮暴露出一个严重问题:它收敛到一个"答案token吸引子"(answer-token attractor)。高达97%的新增错误集中在一个字母上,且该吸引子因模型族而异——在Qwen中为D,在Llama中为A。
通过logit干预,研究者识别出一个主导的近似常数偏移。在留出集上减去该估计偏移后,可以恢复52%至59%的丢失准确率,并消除主导吸引子。选项排列实验进一步证实,这种偏差追踪的是token位置而非选项内容——模型只是倾向于输出某个位置的字母,而非真正理解题目。
这一发现揭示了局部合理性与全局可检测性之间的张力:在单项题目层面,错误看起来可能合理;但在聚合分布上,异常模式清晰可见。
logit干预 指在模型输出层对未归一化的logits向量进行直接修改,例如加上或减去某个偏移向量,再经softmax得到概率分布。研究者通过对比节流模型与原始强模型在多项选择各选项token上的logit差异,估计出一个近似常数的偏移方向——它系统性地抬高某个字母token(如D或A)的logit。在留出集上减去该估计偏移,相当于对输出分布做一次校正,从而恢复了52%–59%的丢失准确率并消除了主导吸引子。这一操作的意义在于:如果节流导致的错误仅仅源于一个可估计的常数logit偏移,那么该“变笨”过程在机制上是高度机械化的,而非真正模拟了能力下降。logit干预因此成为一种诊断工具,用于区分“表面错误分布合理”与“底层存在系统性token偏见”两种情形。
错误类别分布:推理任务上的表面可信
有趣的是,在推理任务上,人类标注的错误类别分布与真实弱参考模型几乎一致(JS散度=0.00),且标注者间一致性很高(κ=0.94)。这表明,在推理任务上,弱教师LoRA产生的错误在类别层面是"可信"的——至少从人类标注者的视角看,它们与真正弱模型的错误难以区分。
然而,工具调用任务的表现则更为自然,Qwen系列在结构化工具调用上的JS散度为0.09,显示出更平滑的退化曲线。但全局校准的旋钮在跨基准迁移时表现糟糕——在两个可用基准上出现了14.2个百分点的误差。
JS散度(Jensen-Shannon散度) 是一种衡量两个概率分布之间差异的对称指标,取值在0到1之间(以2为底时),0表示分布完全相同。在本研究中,研究者将节流模型产生的错误按人类标注的错误类别(如计算错误、逻辑跳跃、单位遗漏等)统计为分布,再与真实弱参考模型的错误类别分布比较,计算JS散度。推理任务上JS=0.00意味着两个分布在类别比例上几乎无法区分,这是“表面可信”的强证据。然而,JS散度只捕捉类别比例层面的相似性,对错误内部的具体模式(如token位置偏见)不敏感,因此它无法单独证明节流模型在机制上真正像弱模型。工具调用任务上JS=0.09则表明存在一定但不大的分布差异,退化相对更平滑。
启示:精确控制不等于可移植的可信降智
这项研究的核心结论是:精确的分数控制并不意味着可移植或可信的技能降低。一个在特定基准上校准良好的"变笨旋钮",换到另一个基准上可能完全失效;它在某些任务上能产生以假乱真的错误分布,在另一些任务上却暴露明显的token位置偏见。
对于AI安全与评估领域,这意味着基准分数作为能力代理的可靠性需要更细致的审视。如果模型可以被精确地"调"到任意分数,那么分数本身作为能力信号的价值就会削弱。同时,检测模型是否被人为节流,可能需要超越聚合分数,深入到错误分布和token级模式的分析。
研究者也指出,可信的性能节流在工具调用等结构化任务上更具可行性,而在开放式推理任务上,虽然错误类别分布匹配,但多项选择中的token吸引子问题提醒我们:表面的可信可能掩盖底层的机械性。
结语
"让LLM变笨"不只是一个技术噱头,它触及了模型评估的根本假设。CapLadder和弱教师LoRA提供了一个受控的实验平台,但研究结果提醒我们:真正的"可信降智"远比调低一个旋钮复杂。局部合理、全局可检测、跨任务不可移植——这些特征共同勾勒出当前性能节流技术的边界。对于构建更鲁棒的评估体系和检测方法,这项研究提供了重要的实证基础。
相关推荐
Gemini 4 Hydrogen发布:速度提升2.5倍的日常AI模型
Google发布Gemini 4 Hydrogen,宣称比Gemini 3.8 Flash快2.5倍,支持四级思考控制、百万token上下文和Orchestrator多模型协作,API定价每百万输入token 1.50美元。
Gemini 4 Hydrogen实测:谷歌最快最便宜AI模型
谷歌 Gemini 4 Hydrogen 实测:Gemini 4 家族中最快最便宜的模型,解析 Carbon/Argon/Hydrogen 分工、API 定价陷阱、免费层限制与四档思考等级的成本取舍,附真实 bug 调试演示。

Gemini 4 Hydrogen 对比测试:仅耗1%周配额,表现不输Sonnet
实测Gemini 4 Hydrogen与Sonnet完成同一CRUD任务:Hydrogen仅耗1%周配额,表现相当且UI细节更优,而Anthropic模型耗7%。开发者建议日常任务不必迷信高价模型。