用强化学习打造平衡机器人:一次工程与AI的结合实践
开发者用强化学习训练出能在真实硬件上站立的平衡机器人,打通了算法、仿真到实机部署的完整链路。
一位开发者在 Reddit 分享了用强化学习(RL)驱动实体平衡机器人的实践项目,引发社区关注。文章以此为切入点,系统介绍了 RL 适合平衡控制的原因——平衡问题本质是连续决策问题,可自然建模为状态-动作-奖励框架,让机器人通过试错自主学出控制策略,无需像 PID 或 LQR 那样手工建立精确动力学模型。文章还着重讲解了"仿真到现实迁移"(Sim-to-Real)这一核心挑战:仿真与真实世界之间的"现实差距"常导致策略失效,域随机化是主流应对手段。最后,文章指出开源仿真工具和算法库的普及,使个人开发者也能复现过去仅限于实验室的机器人学习研究。
当强化学习走进现实世界的机器人
在机器人控制领域,平衡问题是一个经典挑战。无论是倒立摆、两轮自平衡车,还是双足行走机器人,核心都要解决一个难题:如何在不稳定的物理状态下,通过持续调整维持系统平衡。一位开发者在 Reddit 上分享了自己使用**强化学习(Reinforcement Learning, RL)**打造平衡机器人的实践,引发了社区关注。
传统上,平衡控制往往依赖经典控制理论,比如 PID 控制器或 LQR(线性二次调节器)。这些方法需要工程师对系统动力学建立精确的数学模型并手动调参。而强化学习提供了另一条路径:让机器人通过与环境的反复交互,自主学习出一套控制策略。
强化学习为什么适合平衡控制
平衡控制本质上是一个连续决策问题——机器人需要在每一时刻根据当前姿态(倾角、角速度、位置等状态)输出相应的电机动作,目标是让系统长期保持直立。这与强化学习的框架高度契合。
在 RL 的建模中,机器人的传感器读数构成状态空间(state),电机的控制指令构成动作空间(action),而**奖励函数(reward)**通常设计为:机器人越接近直立、偏离越小,获得的奖励越高;一旦倾倒则给予惩罚或终止回合。通过成千上万次的试错,算法会逐渐收敛出一套能够维持平衡的策略。
相比手工调参的控制器,RL 的优势在于它能处理非线性、难以建模的复杂动力学,并且在面对扰动时可能表现出更强的鲁棒性。
从仿真到实机的关键环节
这类项目通常遵循一个成熟的技术路线。开发者会先在物理仿真环境(如 Isaac Gym、MuJoCo、PyBullet 等)中训练模型,因为真实机器人训练成本高、容易损坏硬件,而仿真可以并行运行大量实验、快速积累数据。
训练完成后,最大的挑战是仿真到现实的迁移(Sim-to-Real Transfer)。仿真环境与真实世界之间总存在差异——摩擦系数、电机延迟、传感器噪声等因素都可能导致在仿真中表现完美的策略在实机上失效,这被称为"现实差距(reality gap)"。常见的应对手段包括域随机化(Domain Randomization),即在训练时随机扰动物理参数,迫使策略学会适应各种情况,从而提升在真实硬件上的泛化能力。
能够让一个 RL 策略真正驱动实体机器人稳定站立,意味着开发者打通了从算法、仿真到硬件部署的完整链路,这本身就是一项不小的工程成就。
域随机化(Domain Randomization)的核心思想是:与其精确建模真实世界,不如让策略在足够多样的"假设世界"中训练,使真实环境只是众多随机变体之一。具体做法是在仿真中随机采样地板摩擦系数、连杆质量、电机增益、传感器延迟乃至视觉纹理等参数,每个训练回合都在不同的参数组合下运行。OpenAI 早年用此方法训练机械手解魔方的工作(Dactyl)是该技术的经典范例。除域随机化外,另一种思路是系统辨识(System Identification),即通过在真实机器人上收集少量数据来校准仿真参数,从而缩小现实差距。两种方法也可结合使用:先用域随机化覆盖不确定性范围,再用系统辨识将参数分布中心对准真实硬件,进一步提升迁移成功率。
这类项目的价值与启示
对于想入门机器人学习的爱好者来说,自平衡机器人是一个性价比极高的练手项目。它涉及的硬件相对简单(通常是电机、IMU 惯性测量单元、微控制器),但完整覆盖了状态估计、控制策略、算法训练与硬件通信等核心技能。
这也反映出近年来一个明显趋势:随着开源仿真工具和成熟 RL 算法库(如 Stable-Baselines3、RLlib)的普及,个人开发者如今也有能力复现过去只属于实验室的研究成果。强化学习不再是停留在论文和游戏 AI 中的概念,而是正在走向真实的物理世界。
不过需要客观看待的是,当前这条 Reddit 分享提供的技术细节有限,我们无法得知作者具体采用的算法、硬件配置和训练参数。对于想复现的读者,建议关注项目的完整开源代码(如有)以获取更多实现细节。
Stable-Baselines3 是基于 PyTorch 的强化学习算法库,封装了 PPO(近端策略优化)、SAC(软演员-评论员)、TD3 等主流算法,提供统一的 API 接口,极大降低了算法实现门槛。PPO 因其训练稳定、超参数不敏感,是连续控制任务(包括机器人平衡)中最常用的起点算法;SAC 则因样本效率更高而适合真实机器人上的在线微调。RLlib 由 Ray 框架提供,侧重分布式大规模训练,适合需要并行仿真的场景。对于个人开发者,Stable-Baselines3 配合 PyBullet 或 MuJoCo 的免费版本(MuJoCo 自 2022 年已开源)是成本最低的完整实验路径。
相关推荐

MCP工具投毒:被忽视的AI智能体攻击面与防御之道
MCP工具投毒正成为智能体AI的新攻击面。本文解析工具描述为何可被恶意利用,剖析信息鸿沟与数据外泄链条,并给出白名单注册表、哈希固定、最小权限与链路策略等分层防御方案。
MCP联合创造者:智能体需要的是连接性,而非更强模型
MCP联合创造者David Soria Parra在演讲中指出,决定智能体未来的是连接性与开放标准,而非更强的模型。本文梳理模型能力演进、编程Agent落地逻辑、MCP的无状态改造及Tasks、Skills、身份授权等未来路线图。
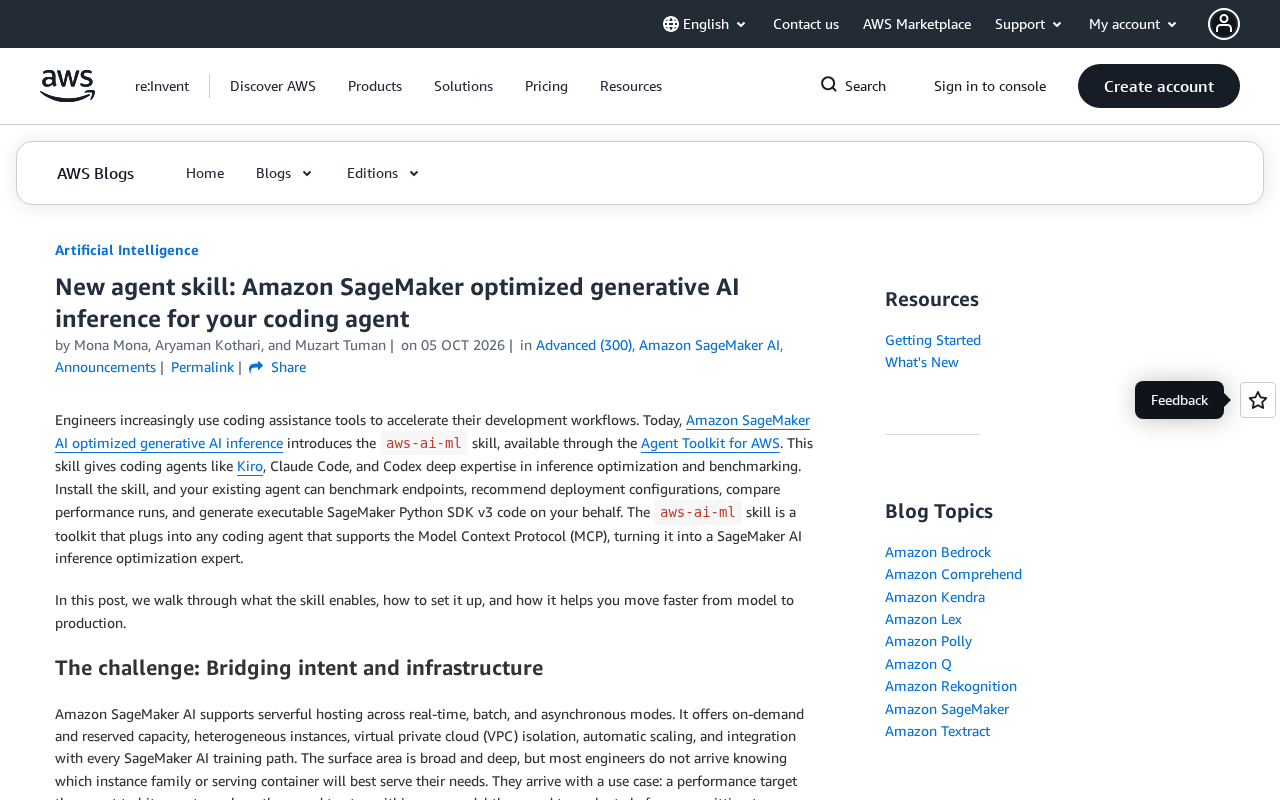
SageMaker新技能上线:为编码智能体赋能生成式AI推理优化
Amazon SageMaker 推出 aws-ai-ml 新技能,通过 Agent Toolkit for AWS 为 Kiro、Claude Code、Codex 等编码智能体注入生成式AI推理优化专长,支持自然语言生成可执行的 SageMaker Python SDK v3 代码完成基准测试、推荐与对比。