深度
AI 领域长篇解读、行业观察、技术分析 —— 慢下来读一篇。
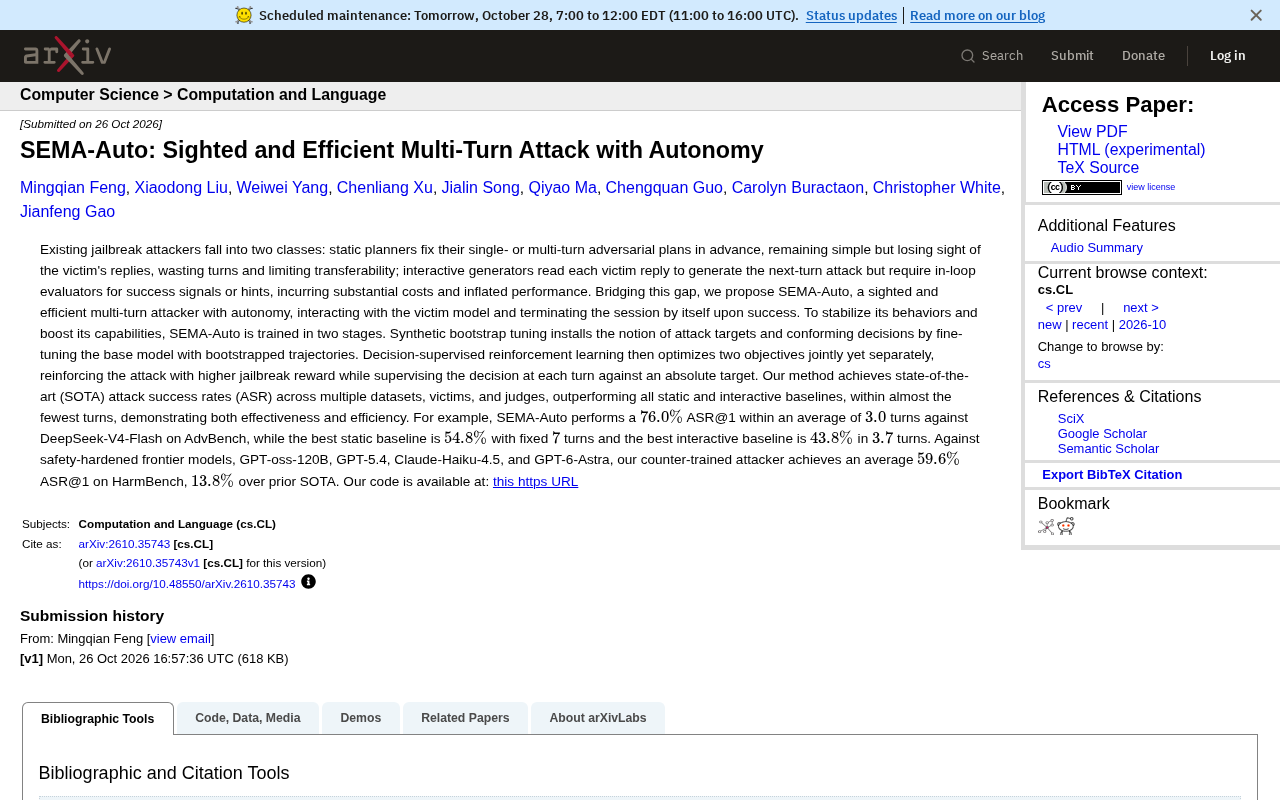
SEMA-Auto:自主多轮越狱攻击效率与成功率双突破
微软提出 SEMA-Auto 自主多轮越狱攻击方法,通过两阶段训练实现自主终止与高效攻击,在 AdvBench 上以 3 回合达 76% 成功率,超越静态与交互式基线。
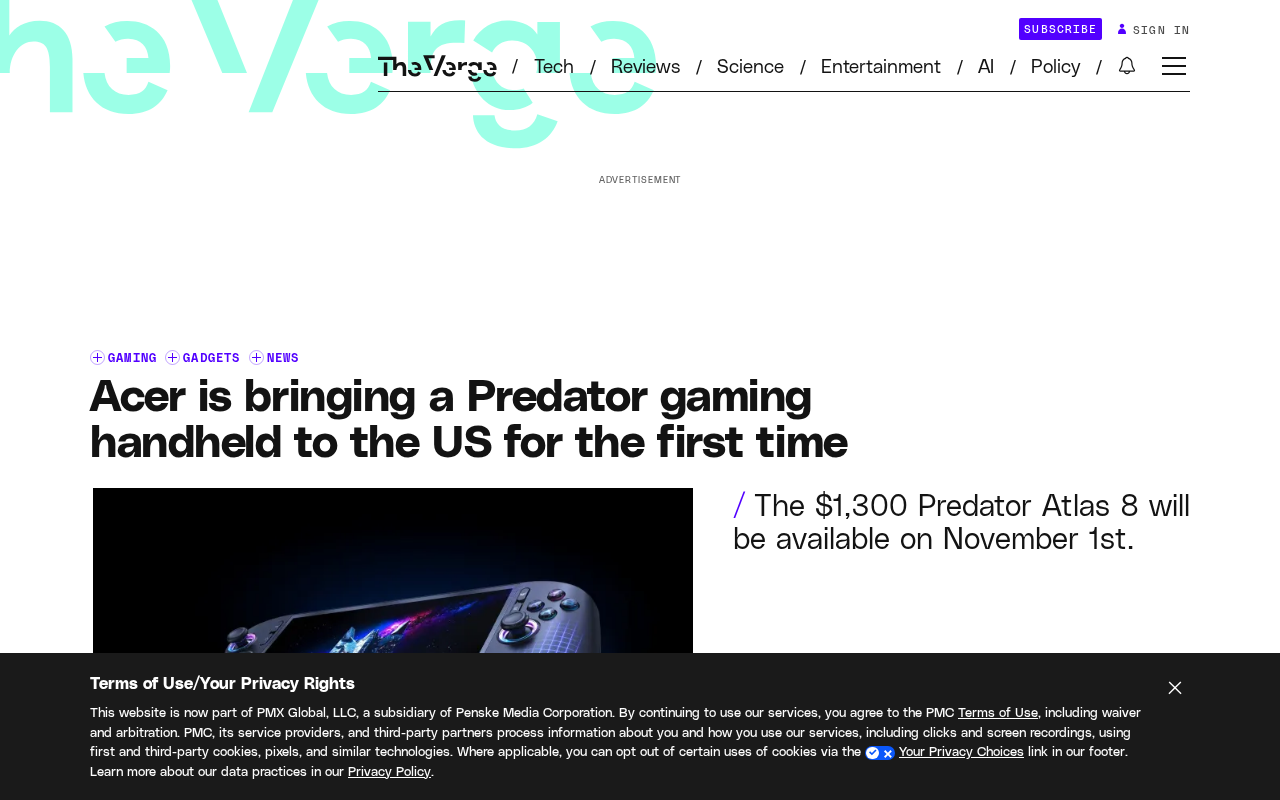
宏碁Predator Atlas 8游戏掌机首次登陆美国,独家首发Best Buy
宏碁Predator Atlas 8游戏掌机首次登陆美国市场,Intel Arc G3 Extreme版本将在Best Buy独家销售。本文梳理型号选择、渠道策略与市场竞争格局。
WorkBuddy怎么用?本地AI智能体安装与工作台搭建指南
WorkBuddy是什么?本文整理B站保姆级教程要点,讲清这款本地AI智能体的完整工作流:从官网下载安装、连接器绑定办公软件,到多智能体并行处理文档与数据分析,并对比Codex说明新手选它的理由。
671B开源大模型+11万条数据:AI落地门槛真降了?
671B参数顶级开源大模型开放权重与训练配方,连同11万条调优数据全部公开。本文分析这次开源对AI落地门槛的真实影响,以及转行者如何从应用层切入大模型赛道。
免费Agentic编程工具实战:让Java Web开发效率翻倍
Vodden agentic编程工具包完全免费,包含MCP文档服务器、Skills规范库、Agent Tools确定性检查和DevLoop构建验证闭环。实测显示全套工具可让AI编码代理通过基准测试,耗时减少约30%,token减少约20%。本文拆解各组件功能、实测数据与安装方式。

大模型Agent科研指南:智能体原理拆解与落地思路
从B站UP主的通俗讲解出发,拆解Agent智能体的核心原理:理解命令、任务拆分、逐步调用大模型。分析Agent依赖规则设计的现实局限,为科研选题提供从规则设计切入的实验落地思路。
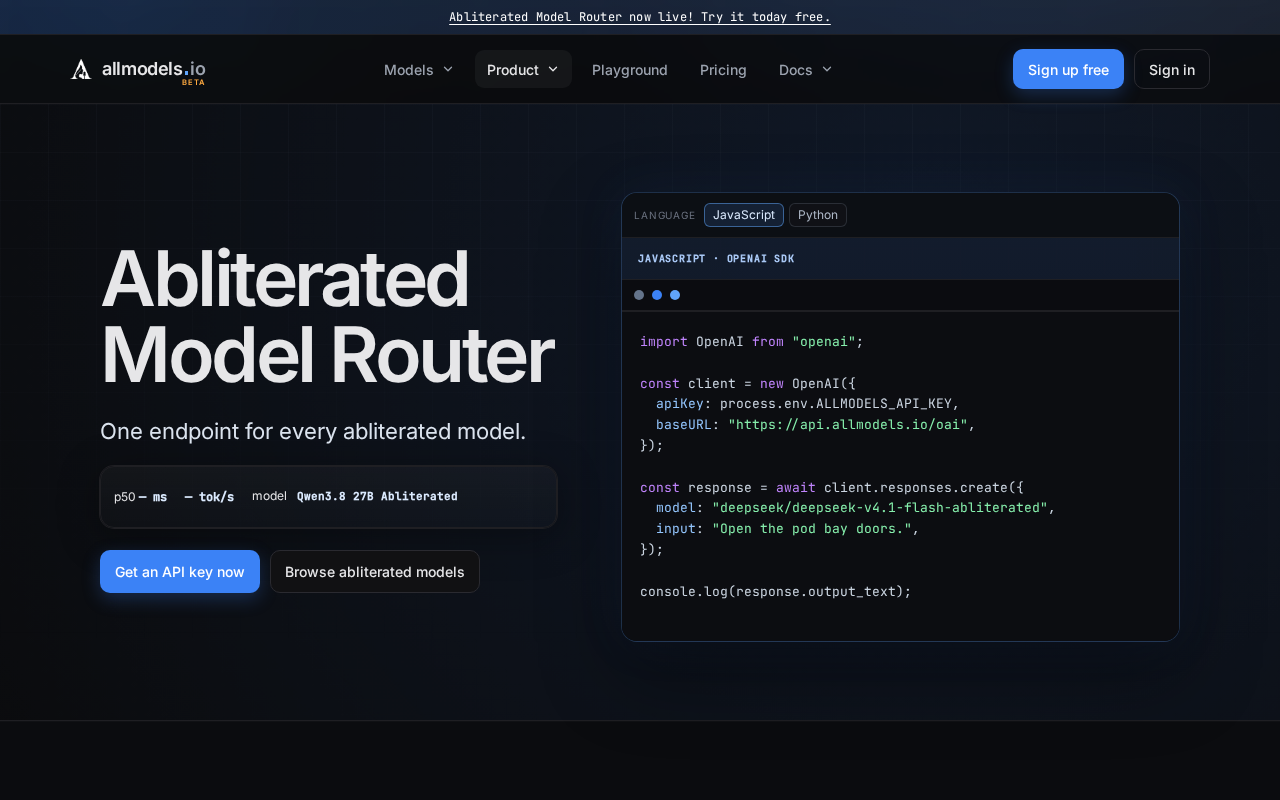
Abliterated DeepSeek 推理服务商增至五家
Abliterated DeepSeek 推理服务商已增至五家,Hacker News 社区就此展开讨论。本文解析 abliteration 的技术含义、多服务商出现的成因,以及对开发者在选择、版本一致性和合规风险方面的实际影响。
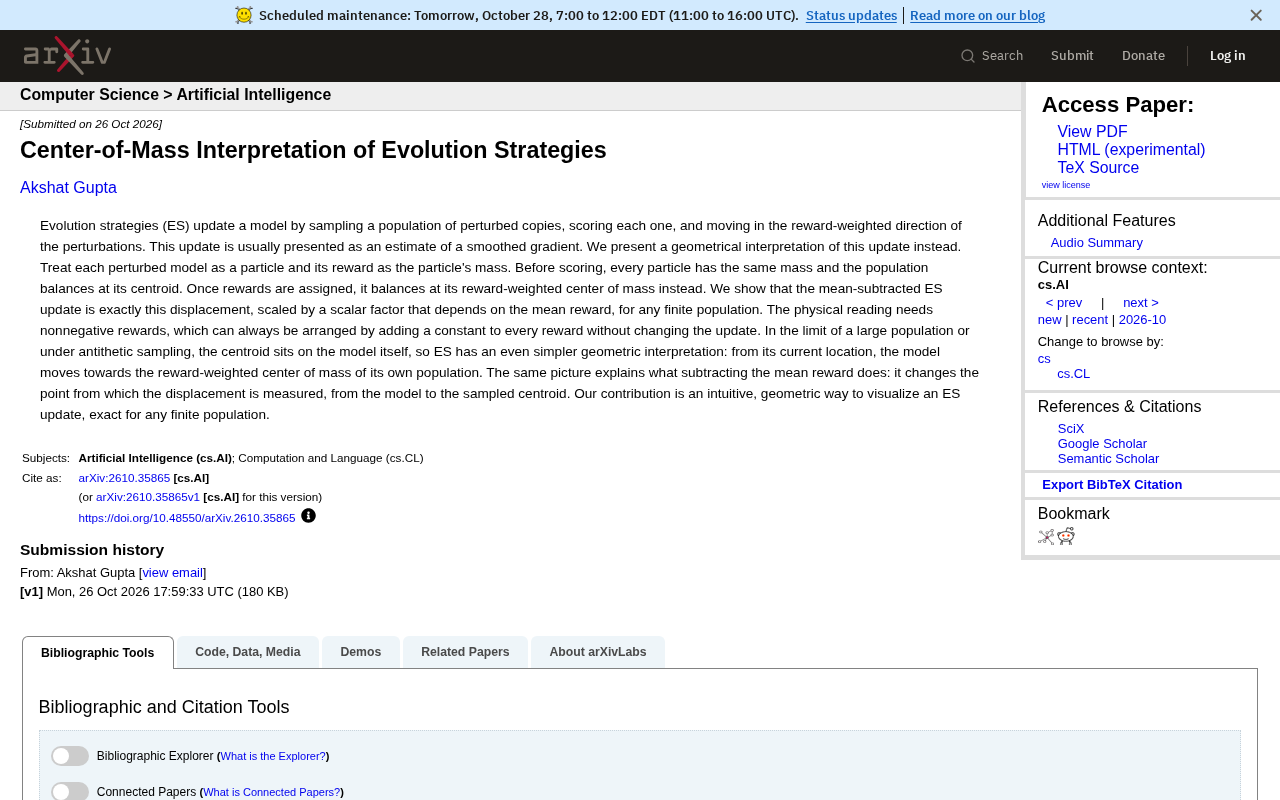
进化策略的质心解读:一种更直观的几何视角
进化策略(ES)的质心解读:将扰动模型视为粒子、奖励视为质量,ES更新等价于种群质心位移。解释均值减除的几何意义及反对称采样下的简化,提供直观的几何视角。
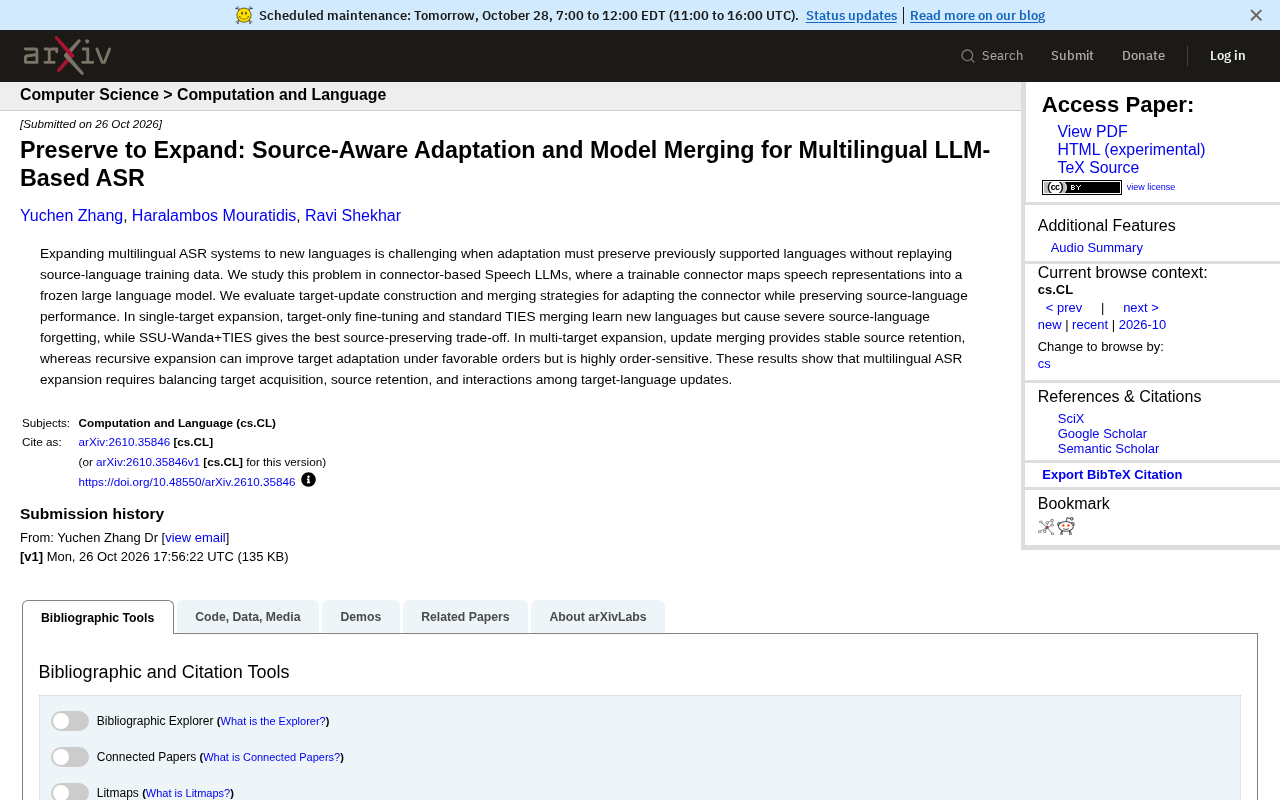
多语言语音识别扩展:源感知适配与模型合并策略
研究提出基于连接器的语音大语言模型多语言扩展方法,通过SSU-Wanda+TIES合并策略在单目标扩展中平衡新语言学习与源语言保留,多目标扩展中更新合并比递归扩展更稳定。
Jev式System One模型能减少选择偏差吗?结构稳定性遭质疑
一项系统性测试揭示:Jev式System One模型虽准确率稳定,但选项洗牌后累积失败集扩大27%-29%,且不如生成式LLM更具抗偏差优势。投票聚合保护有限,一致同意答案也常出错。
LLM研究报告的“主张平滑”现象:SmoothScore量化评估
LLM研究代理在生成报告时存在“主张平滑”现象,即给出比证据支持的更自信结论。研究者提出SmoothScore量化该效应,并在7系统4数据集上验证代理一致产生更强主张。
原子安全关切:构建网络安全知识的统一语言
一篇最新论文提出原子安全关切(ASCs)概念,试图用有限的基础词汇组合表示网络安全知识,为跨框架的安全概念映射、自动化合规推理和知识表示提供统一语言框架。
非生成模型JEV能否胜任临床试验标准评估?
研究对比非生成模型JEV与Qwen Flash在临床试验标准评估中的表现:JEV在MIMIC-III上宏F1大幅领先,信息不足条件召回率56.3% vs 9.9%,延迟更低、成本降低53%-74%,但需人工验证错误。
LLM评估新框架:自置信度与LLM辅助审计的统计效率
论文提出统一统计框架,分析LLM评估中置信度分层审计与LLM-as-a-judge的统计效率。实验表明校准不佳的置信度仍可支持有效审计,按比例分配显著降低估计误差,而法官辅助评估仅在小部分场景下具备成本优势。
Transformer泛化边界新解:长序列训练为何比多样本更高效
最新研究联合分析Transformer的分布内泛化与长度泛化,发现增加训练长度比增加样本数指数级更高效,为长序列训练策略提供理论依据。
无检索器检索:DecisionRAG用决策模型导航文档
DecisionRAG提出无检索器检索新范式:用决策模型在单次前向传播中联合评估候选分支,沿语料库结构逐层导航,无需任务训练即超越8B重排器的稠密检索,检索仅需0.7-1.8秒。
不可剥夺的人类监督:I-HITL协议如何防止AI代理绕过安全护栏
论文提出I-HITL(不可剥夺的人类在环)概念,通过形式化定义和Countersign原型,利用可信消费级移动设备确保AI代理行动必须获得人类明确批准,防止代理绕过HITL护栏。实验显示十个前沿模型可自主收集OTP绕过支出上限审批。
LLM肿瘤全程诊疗评估新基准:诊断强不等于下游强
新基准 NPC-RubricBench 基于 405 名鼻咽癌患者纵向记录评估 30 个 LLM,发现诊断性能强不代表下游照护可靠,失败模式随诊疗阶段反转,提示粒度存在决策质量与证据忠实度的权衡。
REVA:单次前向传播实现实时漏洞检测,速度提升250倍
REVA提出一种实时漏洞检测新方法:通过预计算威胁模型、静态分析与调用图注入上下文,并用探针读取LLM内部表示,在PrimeVul上达到60.0%准确率,与agent式检测器VulTriage持平,速度却快250倍以上。
前沿Agent如何操控机器人?EBench实测GPT-6-Astra
EBench评测报告实测GPT-6-Astra:直接控制下短时程任务领先、泛化波动最小,但长时程与高精度操作落后于VLA/WAM策略;Harness+策略模式可提升成功率并降低token成本。