#基准评测
共 8 篇相关文章

·4 分钟
Quant-Arena:LLM量化交易研究基准,九大前沿模型仍跑不赢等权市场
Quant-Arena 是一个面向真实 A 股数据的端到端量化研究基准,模型仅获 2022–2023 年反馈,需冻结策略接受 2024 密封年考核。九个前沿模型中 GPT-6 Astra 得分最高,但无一跑赢等权市场。
阅读全文 →

·6 分钟
Hugging Face官方榜单日更:49个基准,SoMarkAI视觉解析登顶
Hugging Face官方基准榜单日更解读:49个基准、1107条成绩,SoMarkAI OXR-1.0登顶olmOCR-bench,FINAL-Bench以11个榜首领先,DeepSeek、智谱、MiniMax等中国团队占据组织榜多数席位。
阅读全文 →

·5 分钟
SerpApi在SimpleQA Verified上达到97.6%准确率
SerpApi将Google Search API与Extract API接入GPT-6.1 Sol,在SimpleQA Verified基准上取得97.6%准确率,与Tavily并列第一。本文详解其测试方法、结果对比及对AI智能体搜索能力的影响。
阅读全文 →

·7 分钟
Hugging Face 官方基准榜首次快照:49个排行榜的霸主盘点
Hugging Face 官方基准排行榜首期快照:49个官方基准、1102条记录,盘点 FINAL-Bench、DeepSeek、GLM、Kimi 等组织在各榜单的登顶情况,并解读自报数据与利益披露带来的解读边界。
阅读全文 →
·5 分钟
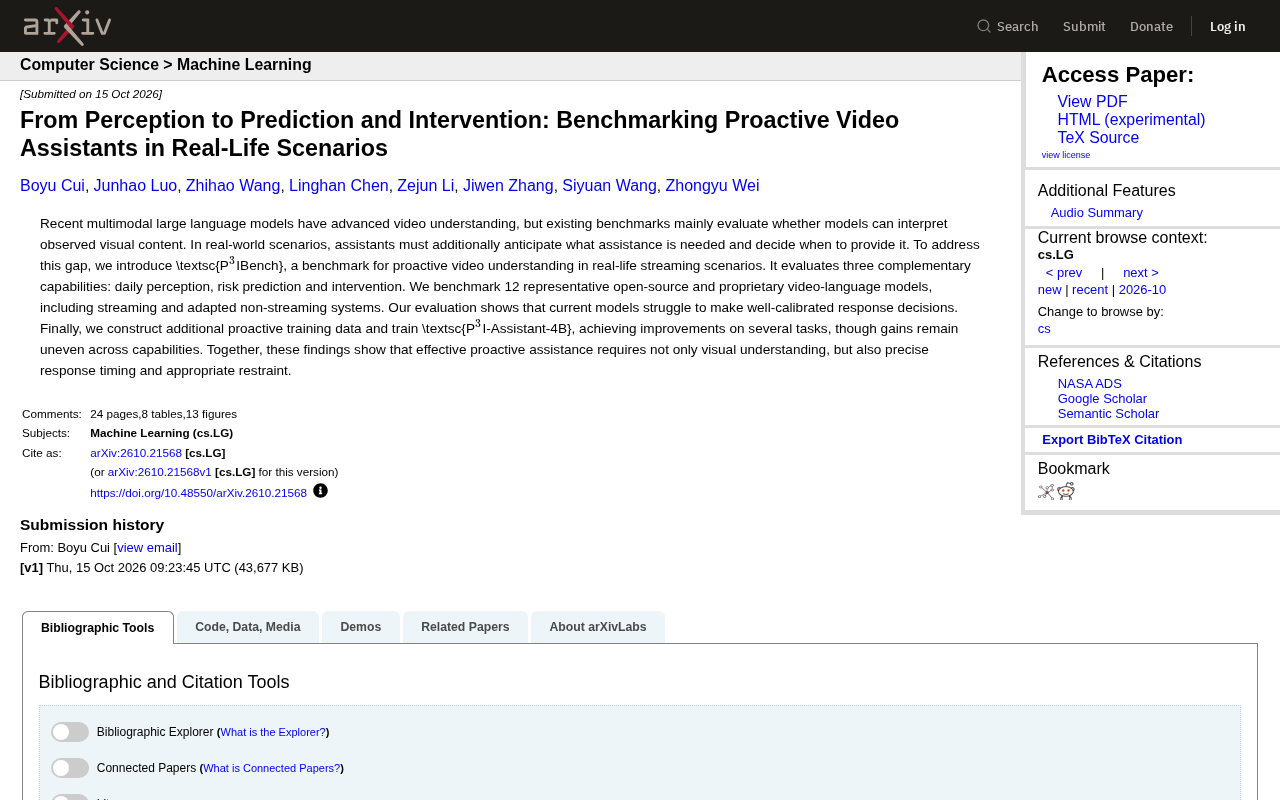
P³IBench:视频助手从感知到干预的主动理解评测
P³IBench 是面向真实流式场景的主动视频理解基准,评测日常感知、风险预测与干预三类能力。12 个视频语言模型在响应决策上普遍表现不佳,4B 助手 P³I-Assistant-4B 虽有提升但收益不均,说明主动协助需要精确时机判断与适当克制。
阅读全文 →

·4 分钟
Hugging Face官方基准榜首聚合索引:49项榜单谁在领跑
Hugging Face官方基准排行榜分散在数十个数据集页面中,这个实时聚合索引追踪约49个官方基准、上千条排行榜条目,按机构、国家和领域展示谁在领跑,截至2026年10月初FINAL-Bench以11个榜首居首。
阅读全文 →