#多模态
共 156 篇相关文章

证据顺序竟能改变判断:多模态大模型的"证据不可交换性"
arXiv 新论文揭示多模态大模型的"证据不可交换性":图像或语音与文本冲突时,感知证据放在后面会显著增加模型依赖度。相同证据、不同顺序即导致不同判断,过往文本偏见研究结论或需重新审视。

Gemini 3.8 文本转语音功能引发关注
谷歌 Gemini 文本转语音(TTS)功能在 Hacker News 引发热议,本文梳理该话题背景、语音合成的行业意义以及评估 TTS 能力的关键维度,帮助读者理性看待多模态语音赛道竞争。
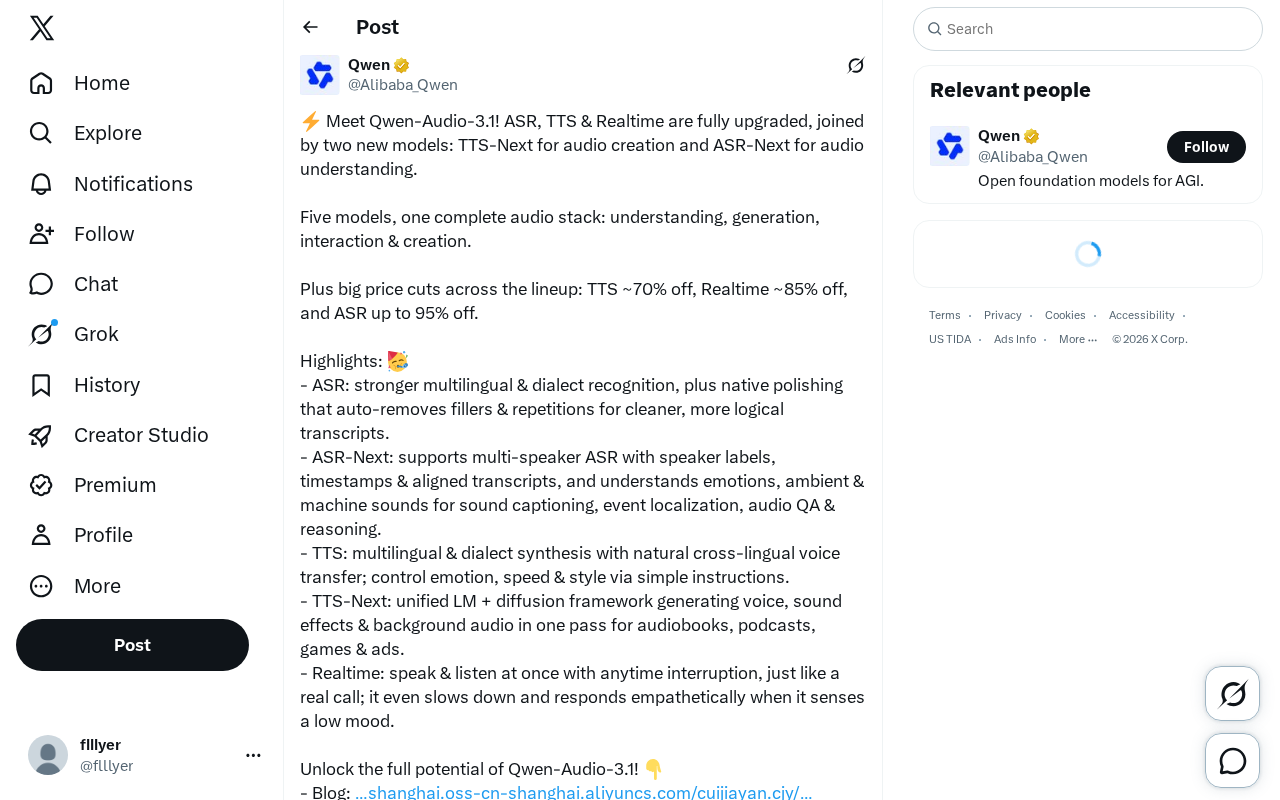
阿里通义Qwen-Audio-3.1发布:五模型音频全栈,ASR降价95%
阿里通义发布Qwen-Audio-3.1,包含ASR、TTS、Realtime及新增TTS-Next、ASR-Next共五个模型,构成完整音频技术栈,并全线降价:TTS降70%、Realtime降85%、ASR最高降95%。
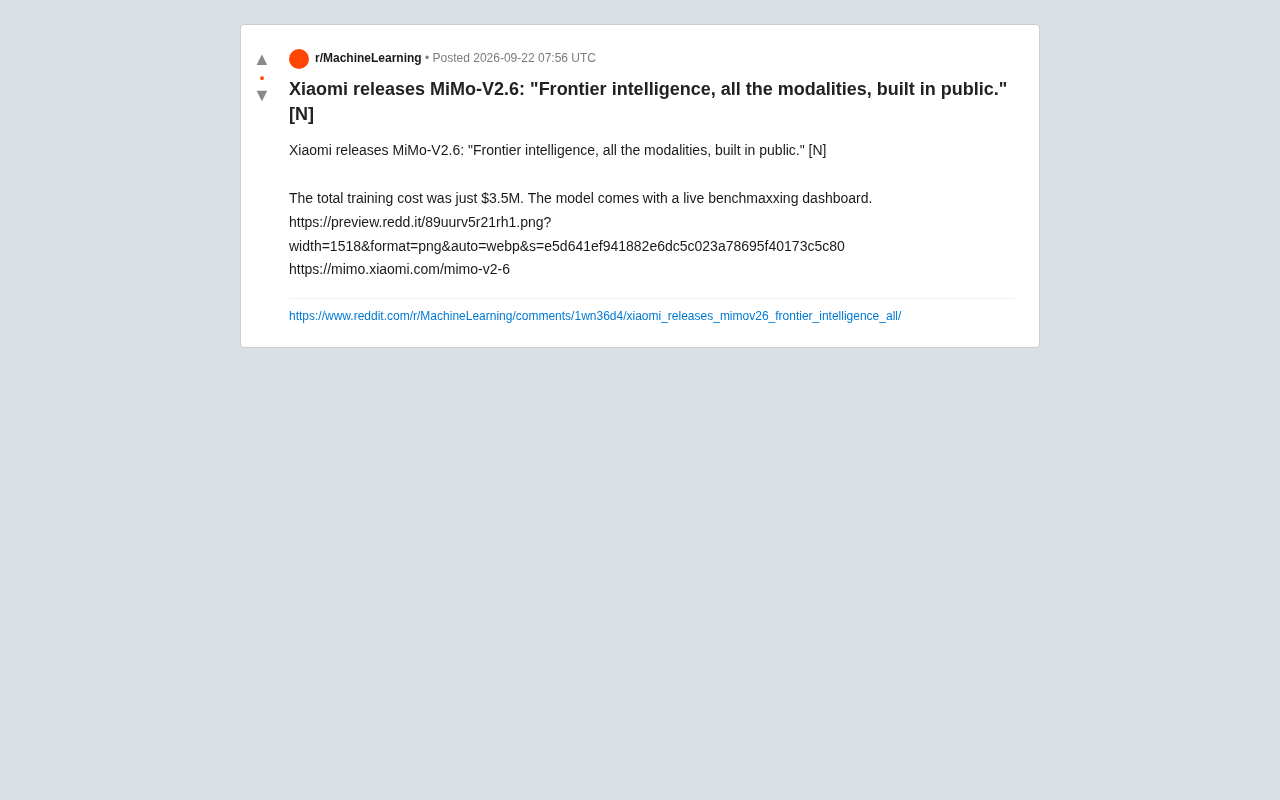
小米发布MiMo-V2.6:350万美元打造的全模态开源模型
小米发布多模态大模型MiMo-V2.6,主打前沿智能、全模态与公开构建,总训练成本仅350万美元,并配备实时评测仪表盘。本文解析其成本、定位与生态意义。

SJR架构:解耦内容理解与策略学习的多模态内容审核新范式
arXiv论文提出SJR(总结-判断-精炼)架构,通过自然语言接口解耦多模态内容理解与策略分类。在误导广告检测中相对F1提升23.6%,且零真实违规样本即可启动新策略,兼具数据效率与可解释性。
MasterGo AI+Cursor实战:一个人搭建多模态AI应用全流程
MasterGo AI与Cursor联合实战课程,带你用AI工具链搭建集成文本聊天、语音交互、图像生成的多模态全栈应用,覆盖需求分析、数据库建模、API设计、前端开发到部署上线全流程,掌握AI与人工协同开发的核心竞争力。
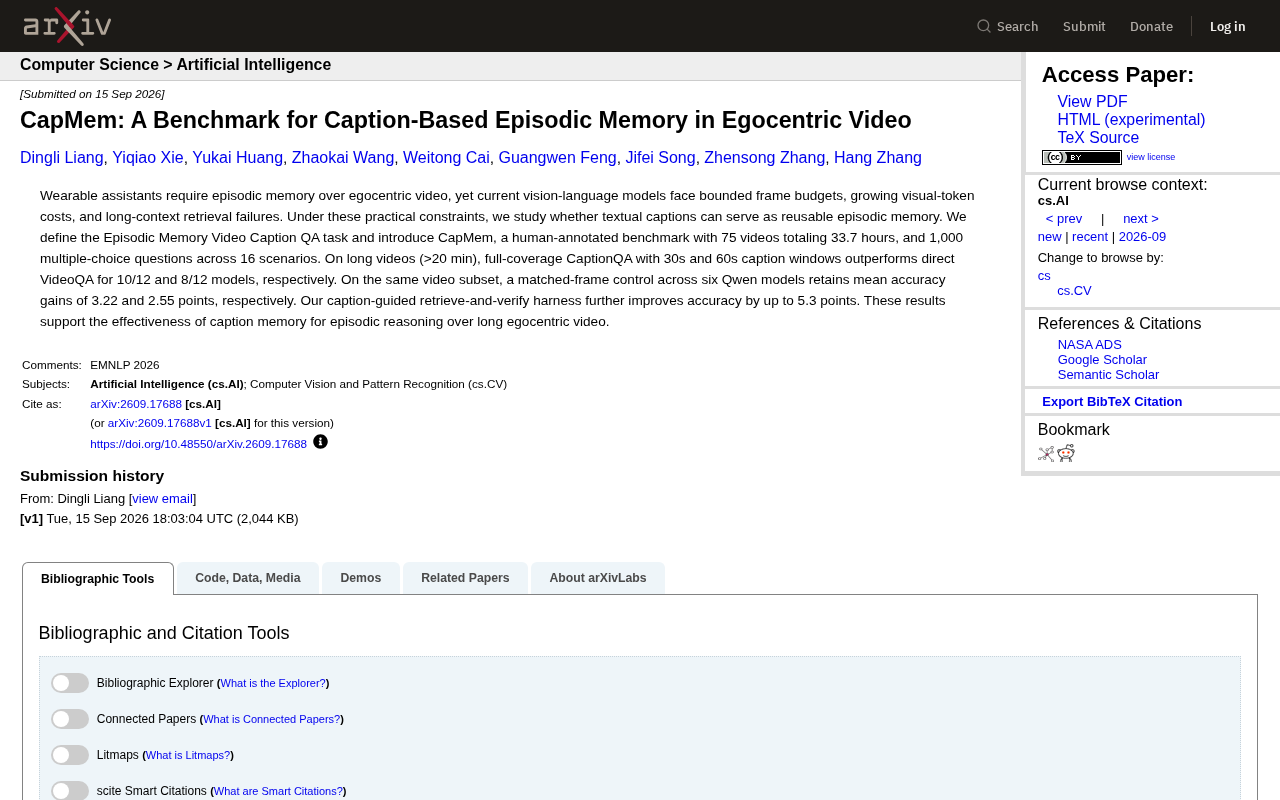
CapMem:用文本字幕解决长视频情景记忆的新基准
CapMem 提出用文本字幕作为可复用情景记忆,解决可穿戴助手处理第一人称长视频的难题。基准含75段视频、33.7小时、1000道问答,实验证明字幕方案在长视频上超越直接VideoQA。
Sierra 多模态智能体:语音、文字、视觉自由切换的客服 AI
Sierra 推出 Multimodal Agents 多模态智能体,能在语音、文字、视觉三种交互模式间自动切换,专为客户成功场景设计。本文解析其产品理念、应用价值与 AI 智能体多模态融合趋势。
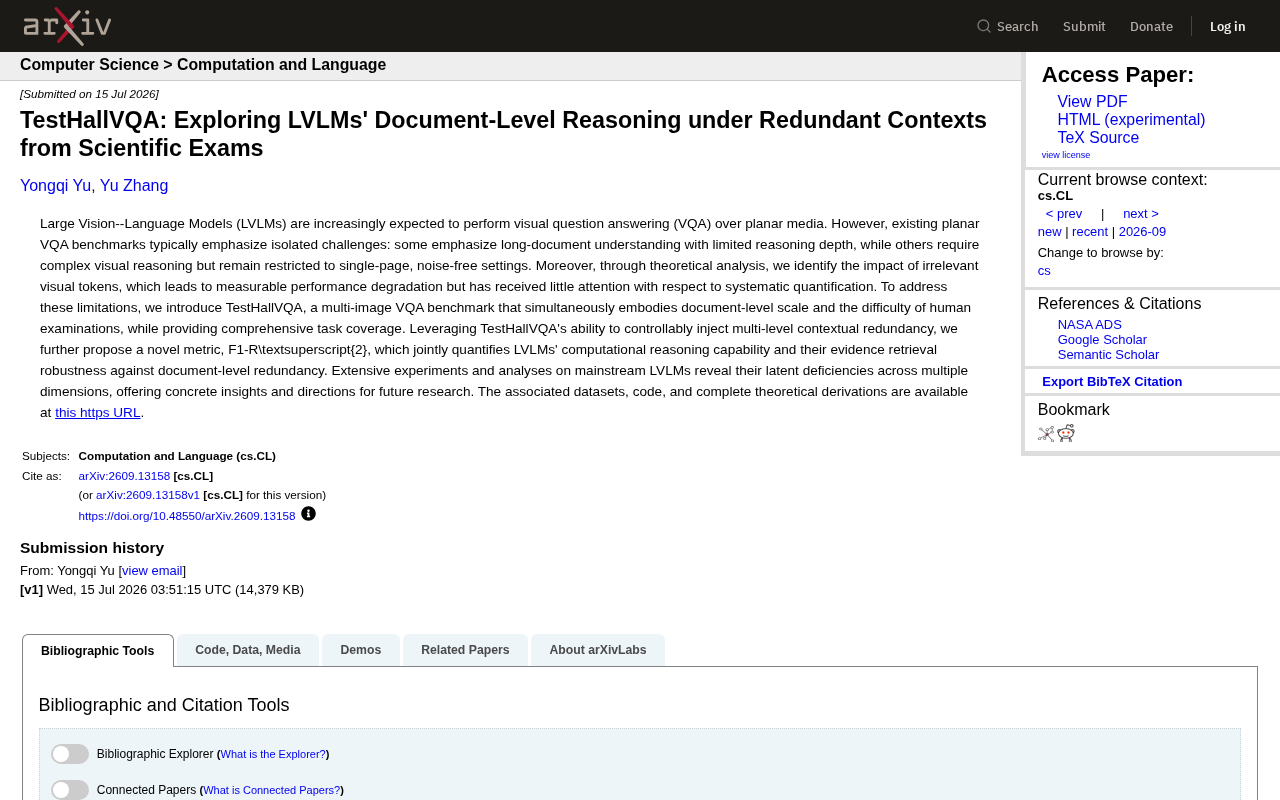
TestHallVQA:冗余上下文下大视觉语言模型的文档级推理新基准
TestHallVQA 是一个面向大视觉语言模型(LVLMs)的多图 VQA 新基准,融合文档级规模与科学考试难度,并提出 F1-R² 指标量化模型在冗余上下文下的推理与证据检索鲁棒性,揭示主流模型的潜在缺陷。

Agnes-3.0-Flash 深度解析:33B 混合注意力多模态模型
Agnes-3.0-Flash 是一款 33B 参数的多模态模型,采用 3:1 混合注意力架构,支持 26 万 token 上下文与文本、图像、视频理解。本文深度解析其架构设计,并探讨其在 Artificial Analysis 上的评分疑点。

用选择题重新定义视频字幕质量评估:VLLM新方法解析
针对视觉大语言模型(VLLM)视频字幕评估的难题,研究者提出以信息保真度和多项选择题问答(MCQA)重新定义字幕质量,破解传统词汇匹配指标的一对多困境,实现更公平、细粒度的评估。
 科技前沿
Kimi K3.1 Pro开源3万亿参数实测:硬盘当内存跑大模型
Kimi K3.1 Pro正式开源,总参数约3万亿,原生多模态智能体模型。B站UP主零度解说实测本地部署:显存内存不足时用硬盘兜底,550G量化模型分层加载,速度虽慢但确实能跑。本文梳理部署流程、API接入方式,以及动画自我介绍、微观世界网页、3D游戏和涡扇发动机模型等生成效果实测。
 教程攻略
pnpm Monorepo全栈AI工程化实战:搭建多模态对话系统
详解如何用pnpm Monorepo架构搭建全栈AI多模态对话系统,涵盖本地模型集成、图片理解、流式对话等核心功能,提供工程化最佳实践与落地方案。
 行业洞察
百度开源LoneForge多模态训练框架,训练提速最高4.8倍
百度智能云开源多模态训练框架LoneForge,采用Apache 2.0协议,支持20+主流模型开箱即用,训练提速15%-45%,前沿架构最高加速4.8倍,一套代码跨GPU和昆仑芯平台运行,大幅降低多模态模型训练的工程门槛。
 产品体验
OpenAI Codex多模态实战:白板草图秒变精美前端应用
深度拆解OpenAI Codex多模态演示:从白板草图拍照上传到自动生成3D地球前端应用,解析Codex视觉自检机制、响应式自动验证、一次性数据可视化等核心能力,探讨AI辅助前端开发的实际影响。
 科技前沿
Qwen3.5-Omni发布:215项任务SOTA,阿里全模态大模型硬刚Gemini
阿里发布Qwen3.5-Omni全模态大模型,基于1亿小时音视频数据原生多模态预训练,215项任务拿下SOTA,多项指标超越Gemini 3.1 Pro。支持音视频Web Coding、长音频分析、113种语言语音识别等能力。
 产品体验
Qwen3.6-27B开源模型评测:27B参数实现旗舰级代码与多模态能力
阿里Qwen3.6-27B开源模型深度解析:270亿参数稠密架构,单卡即可部署,代码生成能力超越前代旗舰。本文详解其技术优势、基准测试成绩、硬件配置方案及实际部署建议,助你低成本获得旗舰级AI编程与多模态理解能力。
 产品体验
GitHub 8K Star:最全LLM大模型资源宝库深度解析
深度解析GitHub热门项目awesome-LLM-resources,涵盖多模态生成、AI Agent、MCP协议、模型训练推理、o1模型、小语言模型等LLM核心方向,8200+ Star社区验证的大语言模型学习资源一站式导航。
 产品体验
GitHub 8K星:最全LLM资源宝库深度解析
深度解析GitHub 8200+星的awesome-LLM-resources项目,涵盖多模态、AI Agent、MCP协议、模型训练推理、o1模型、小语言模型等十大核心板块,为LLM从业者提供最全面的中文学习资源索引。
 产品体验
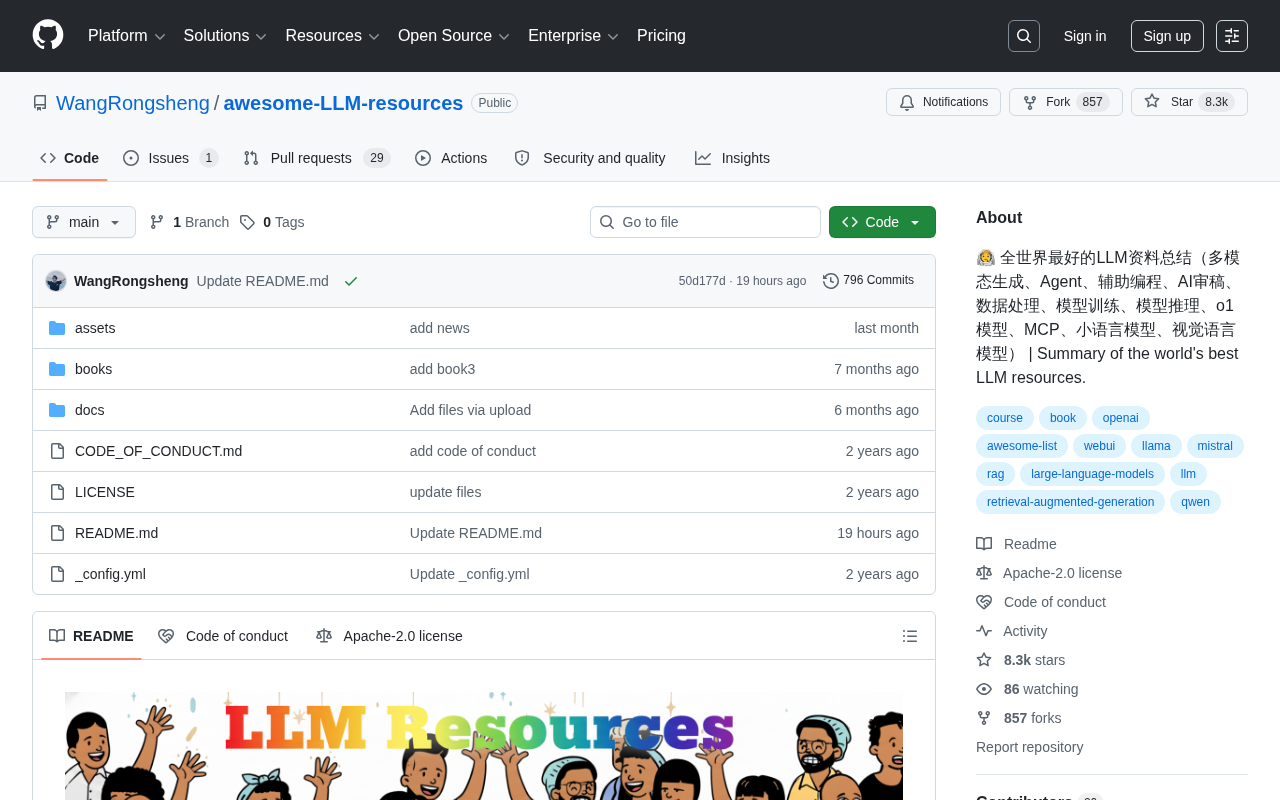
awesome-LLM-resources:GitHub 8200星LLM学习资源库全面解析
深度解析GitHub万星项目awesome-LLM-resources,涵盖LLM多模态生成、Agent智能体、模型训练推理、MCP协议等十大核心模块,为AI从业者提供一站式大语言模型学习导航。