#大模型
共 288 篇相关文章
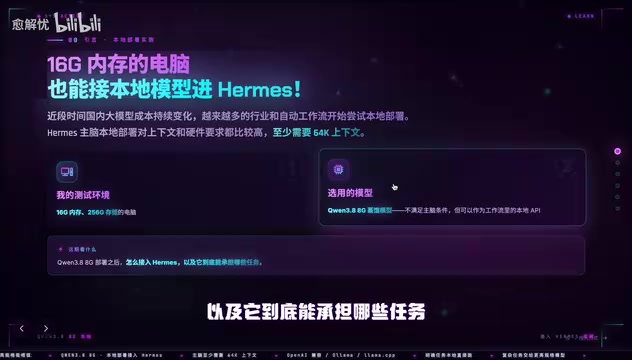
Hermes接入Qwen3-8B本地部署:低配电脑也能跑自动化工作流
在16G内存电脑上部署Qwen3-8B蒸馏模型并接入Hermes自动化工作流的实测记录。详解OpenAI兼容接口、Ollama、llama.cpp三种接入方式,以及低配设备下主脑调度加本地执行的分工模式。
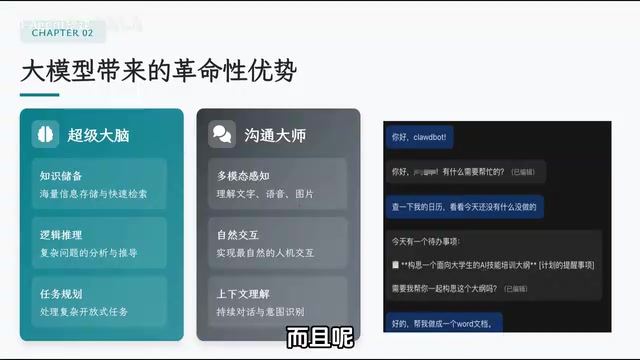
AI Agent入门指南:智能体的核心架构与工作原理详解
本文系统讲解AI Agent智能体的定义、大模型能力演进、感知/大脑/行动三大核心架构,以及上下文窗口、System Prompt、RAG检索增强生成等记忆管理机制,是AI Agent零基础入门的完整知识框架。
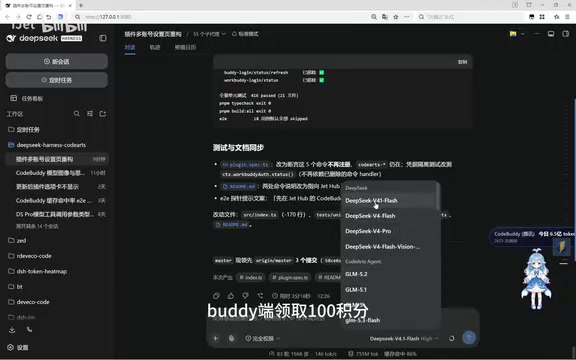
DSH白嫖DeepSeek V4.1 Flash:积分批量领取与国际版WorkBuddy实测
DSH项目最新升级实测:WorkBuddy端可批量领取100积分,限流额度提升、重置时间缩短,国际版WorkBuddy现已支持免费调用混元4与DeepSeek V4.1 Flash,附使用建议与风险提示。
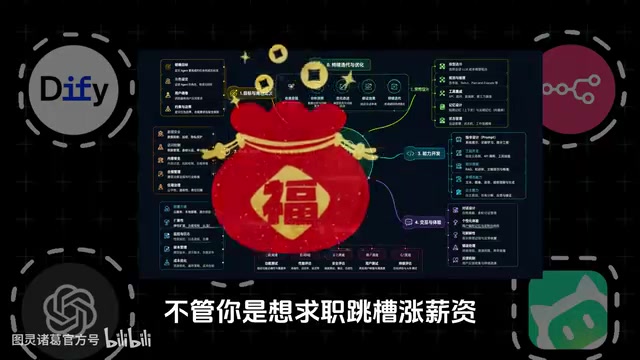
AI Agent开发四阶段学习路线:从入门到企业级实战
AI Agent开发零基础学习路线全解析:从核心概念、ReAct范式,到多智能体协作、Prompt调优与企业级实战项目,系统掌握规划、记忆、工具调用、RAG与MCP,帮你少走弯路成为AI核心人才。
Jev前沿模型问世:成本降40-400倍,速度提升20-200倍
新前沿模型Jev宣称成本降低40-400倍、速度提升20-200倍,引发Hacker News热议。本文解析其性价比卖点、效率突破的可能路径,以及如何理性看待这组惊人数字。
AI Agent实战入门:从RAG到智能体的技术进阶路线图
从提示工程到RAG再到AI Agent,本文梳理大模型应用开发的能力结构、商业落地四阶段和Agent四大分类,帮你理清LangChain、LangGraph技术进阶的学习路线。
LangChain 1.3 入门指南:大模型与Agent核心概念解析
LangChain 1.3入门教程:解析大语言模型的三大局限、框架的统一接口与模块化架构,以及LLM、Agent、DeepAgent与Harness架构的层级关系,助你理解大模型应用开发核心概念。

Gemini 3.8 Live 与 Extended Thinking:谷歌实时推理的新尝试
谷歌 Gemini 3.8 Live 与 3.8 Live Extended Thinking 引发技术社区讨论。本文解析实时交互与延展推理的技术取舍、社区关注点及对大模型行业的意义。
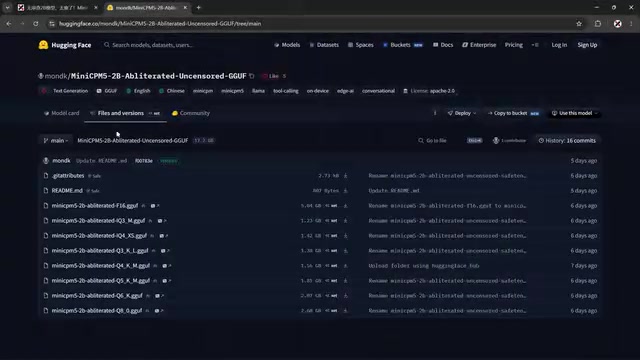
MiniCPM-2B无审查版本地部署教程:接入llama.cpp与Hermes全流程
MiniCPM-2B 本地部署完整教程:涵盖 GGUF 模型下载、llama.cpp 配置、启动脚本编写及接入 Hermes 客户端全流程。支持 131K 上下文,普通电脑即可运行的国产轻量级大模型部署指南。
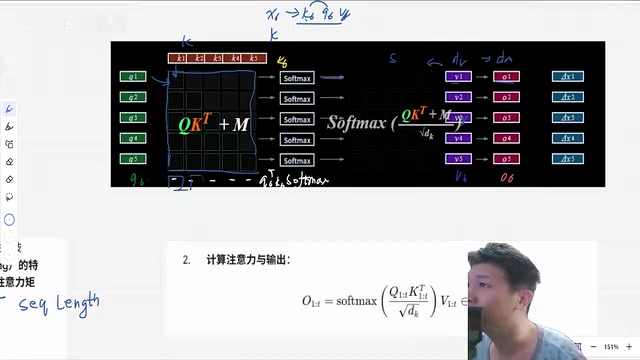
深入理解 KV Cache:大模型推理的空间换时间优化
深入解析大模型推理中的 KV Cache 技术:从无缓存的重复计算问题出发,讲清键值缓存的实现原理、新词计算流程、时间复杂度对比以及显存开销估算公式,帮助理解 Transformer 推理的性能优化。
零基础学AI大模型:一套100集入门教程的价值与学习路径拆解
一套面向零基础人群的100集AI大模型全套教程测评与学习路径拆解,分析其课程逻辑、配套资源价值,并提供理性使用免费教程、高效入门大模型的实用建议。
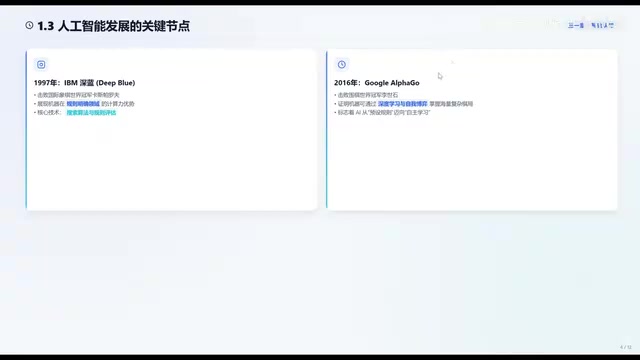
从零理解AI大模型:概念、技术脉络与普通人的机会
从零理解AI大模型:厘清人工智能、机器学习、深度学习、Transformer与生成式AI的发展脉络,解析深蓝、AlphaGo、ChatGPT等关键节点,以及普通人如何切入大模型应用领域。
稠密模型 vs MoE:激活参数、吞吐量与选型指南
深入解析稠密模型与 MoE 混合专家模型的核心区别:激活参数、总参数、吞吐量各有何差异?结合 NVIDIA Nemotron 3.5 Lightning 案例,给出实用的模型选型建议。
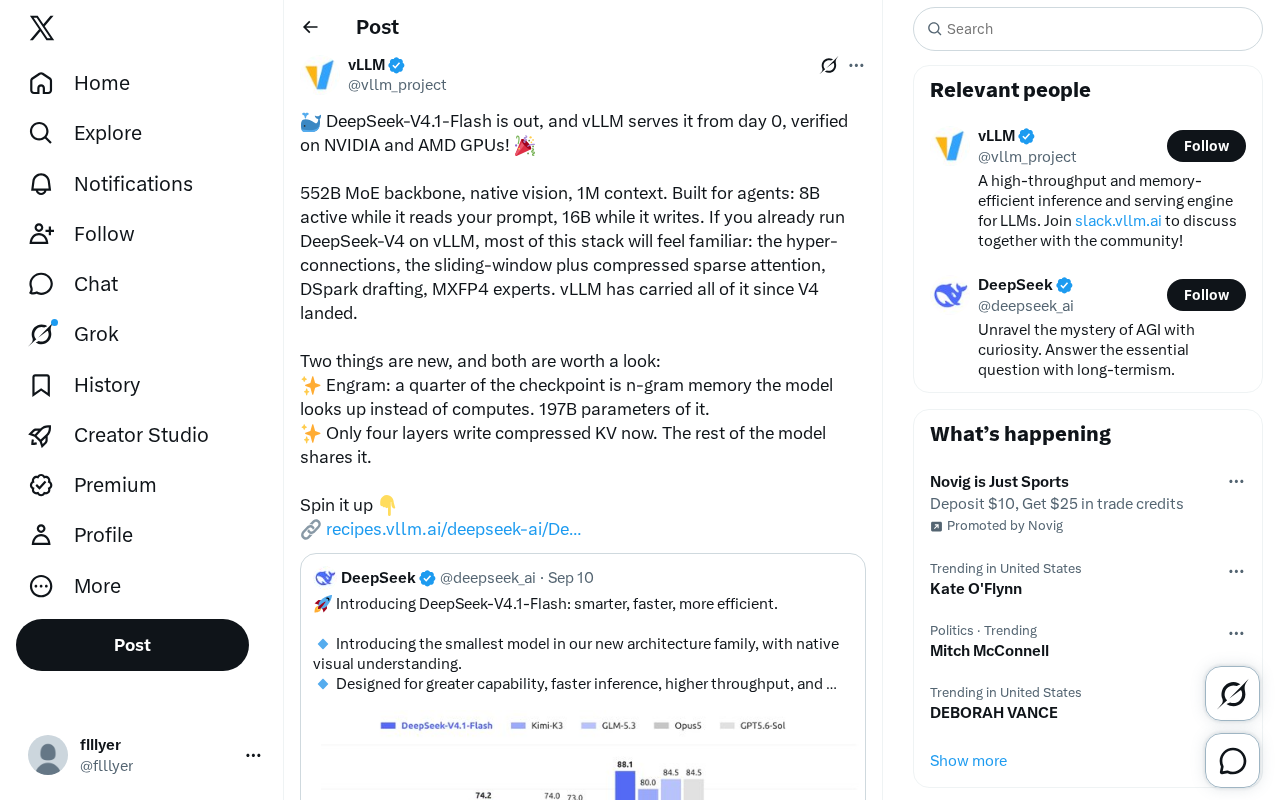
DeepSeek-V4.1-Flash发布:552B MoE与Engram记忆架构解析
DeepSeek-V4.1-Flash正式发布,采用552B MoE主干、100万上下文与原生视觉,vLLM从首日起支持并验证NVIDIA与AMD GPU。深度解析Engram记忆架构与压缩KV共享两项核心创新。
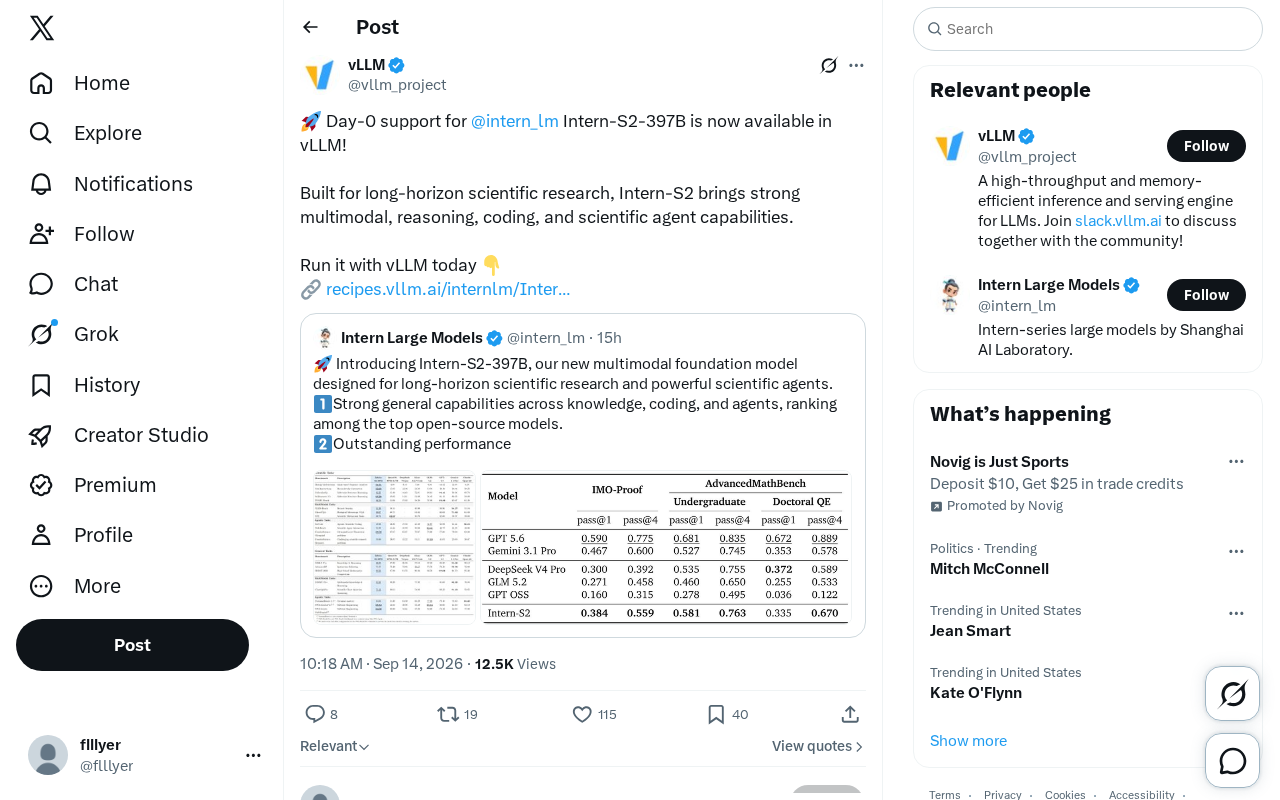
vLLM 首日支持书生 Intern-S2-397B:面向科研的多模态大模型
上海AI实验室书生 Intern-S2-397B 大模型现已获得 vLLM 首日 Day-0 支持,面向长周期科学研究,具备多模态、推理、编程与科学 Agent 能力,开发者可即刻部署运行。
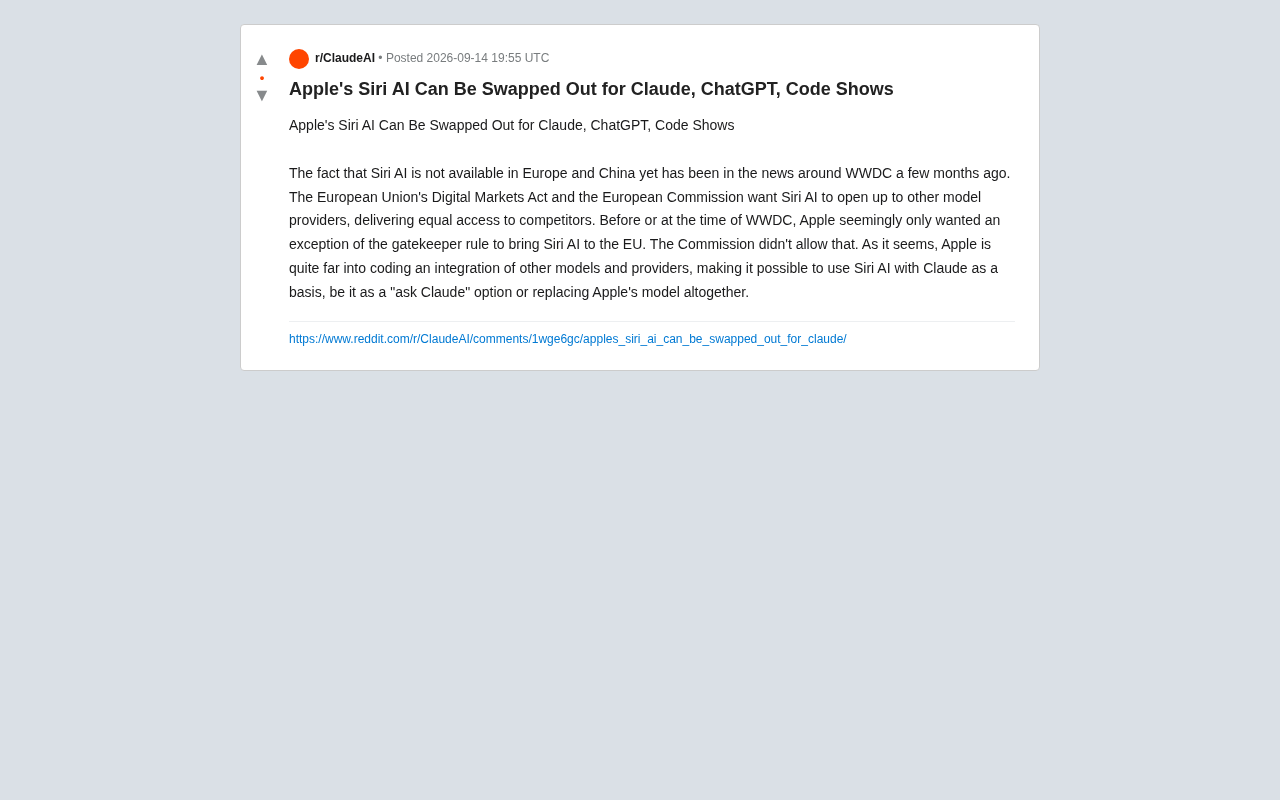
苹果Siri将支持替换为Claude、ChatGPT,代码已现端倪
曝光代码显示,苹果正开发Siri AI的第三方模型集成方案,未来或可将Siri底层模型替换为Claude或ChatGPT。这一变化背后是欧盟《数字市场法》的监管压力。
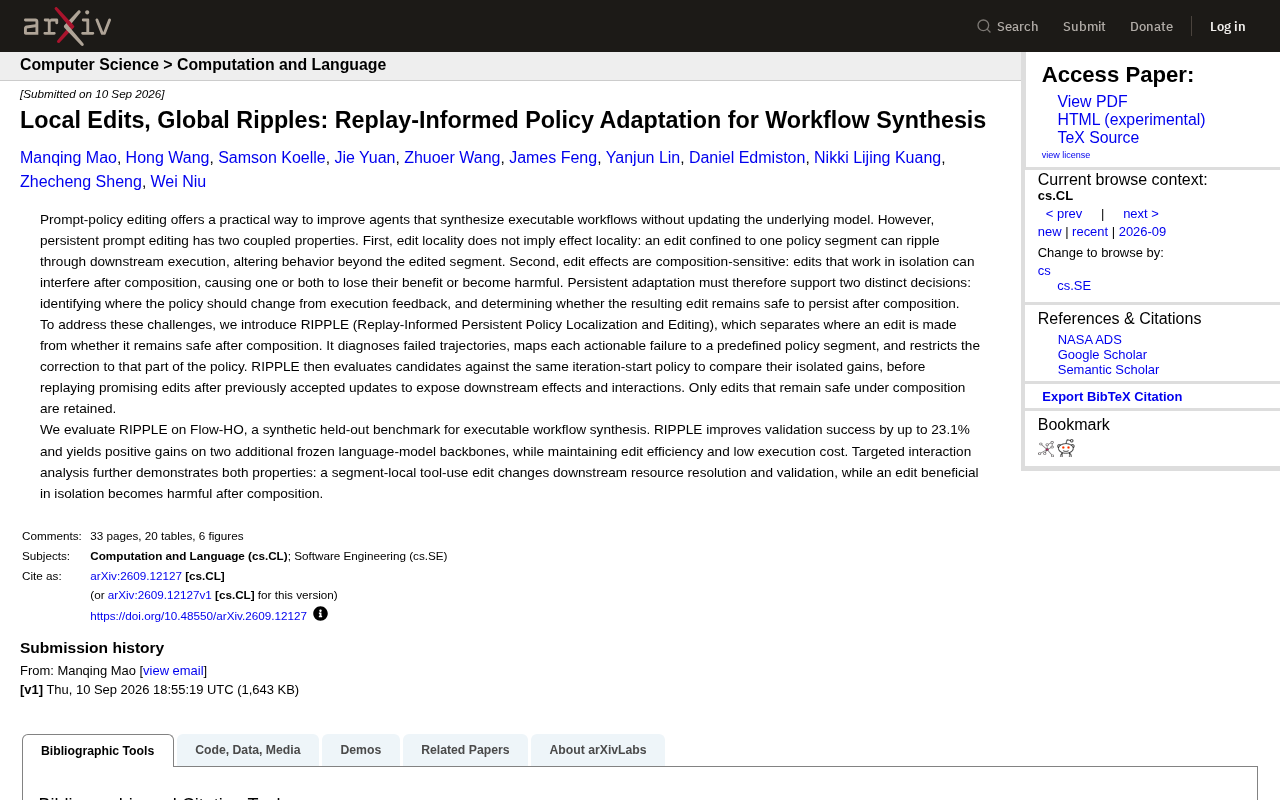
RIPPLE:无需重训模型的智能体工作流策略编辑新方法
arXiv最新论文提出RIPPLE框架,通过回放引导的持久策略定位与编辑,解决AI智能体工作流合成中提示词编辑的局部涟漪与组合敏感性问题,无需重训模型即可将验证成功率最高提升23.1%。
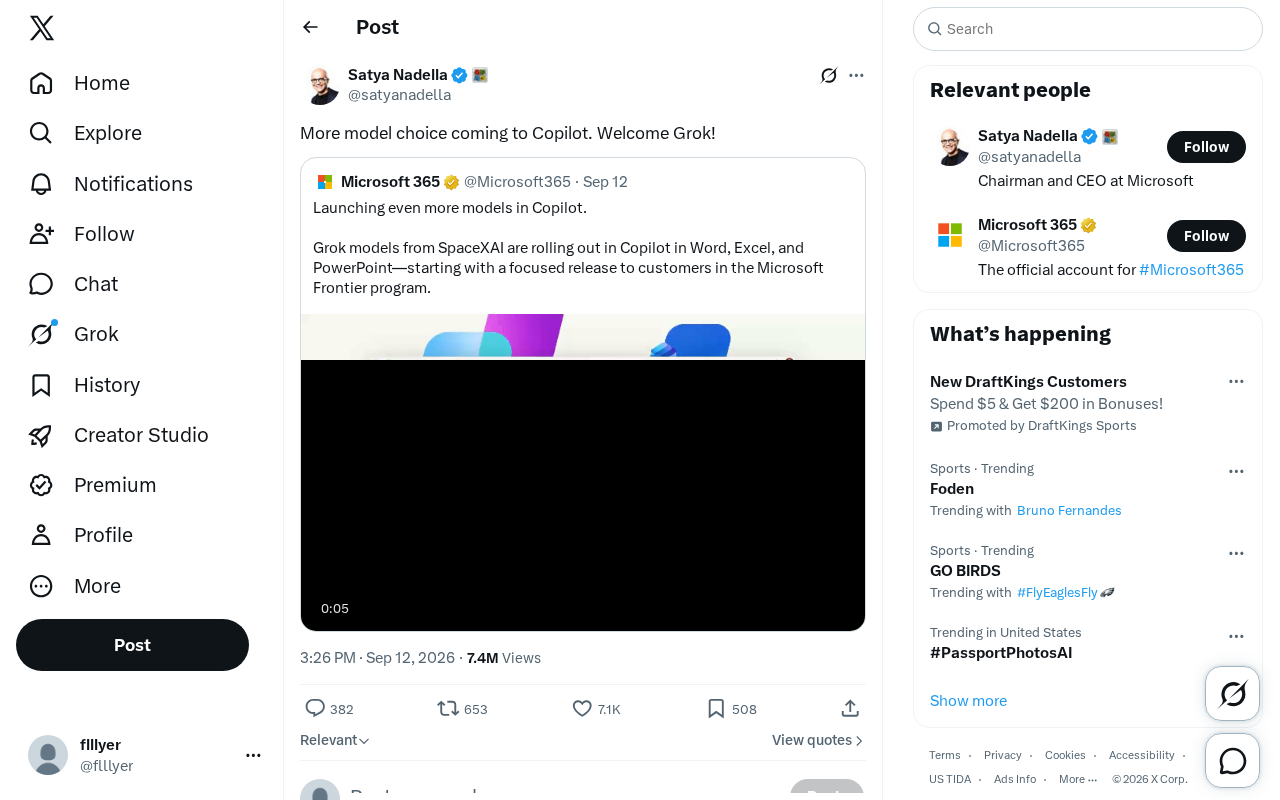
Copilot引入Grok模型:微软扩展AI模型选择版图
微软宣布Copilot将引入xAI的Grok模型,为用户提供更多模型选择。本文解析微软多模型策略的产品逻辑与行业意义,探讨AI助手向多模型聚合平台演进的趋势。