#强化学习
共 248 篇相关文章

一石二鸟:统一检索与利用的技能增强生成框架
Skill-Uni统一强化学习框架联合优化技能检索与利用,在五个基准测试中相比Qwen3-4B和LLaMA3.1-8B分别取得66.59%和34.82%的平均性能提升,兼容多种检索引擎。

H²R:用分层提示奖励提升数学推理
论文提出 H²R 框架,利用数学题固有的子问题结构作为分层提示奖励,为 RLVR 训练提供中间监督,并发布 HiMath 分层数学基准。实验显示分层提示可一致提升多种大模型的数学推理表现,集成到 RL 训练后增益进一步放大。

信息价值:强化学习记忆检索与信用分配的统一钥匙
强化学习记忆机制面临检索成本高与信用分配难两大问题。最新研究提出信息价值可统一解决二者:在观测处读取给出获取动作最优价值的可证明下界,在决策处读取定义最优检索集合,并可从存档轨迹中学习估计。
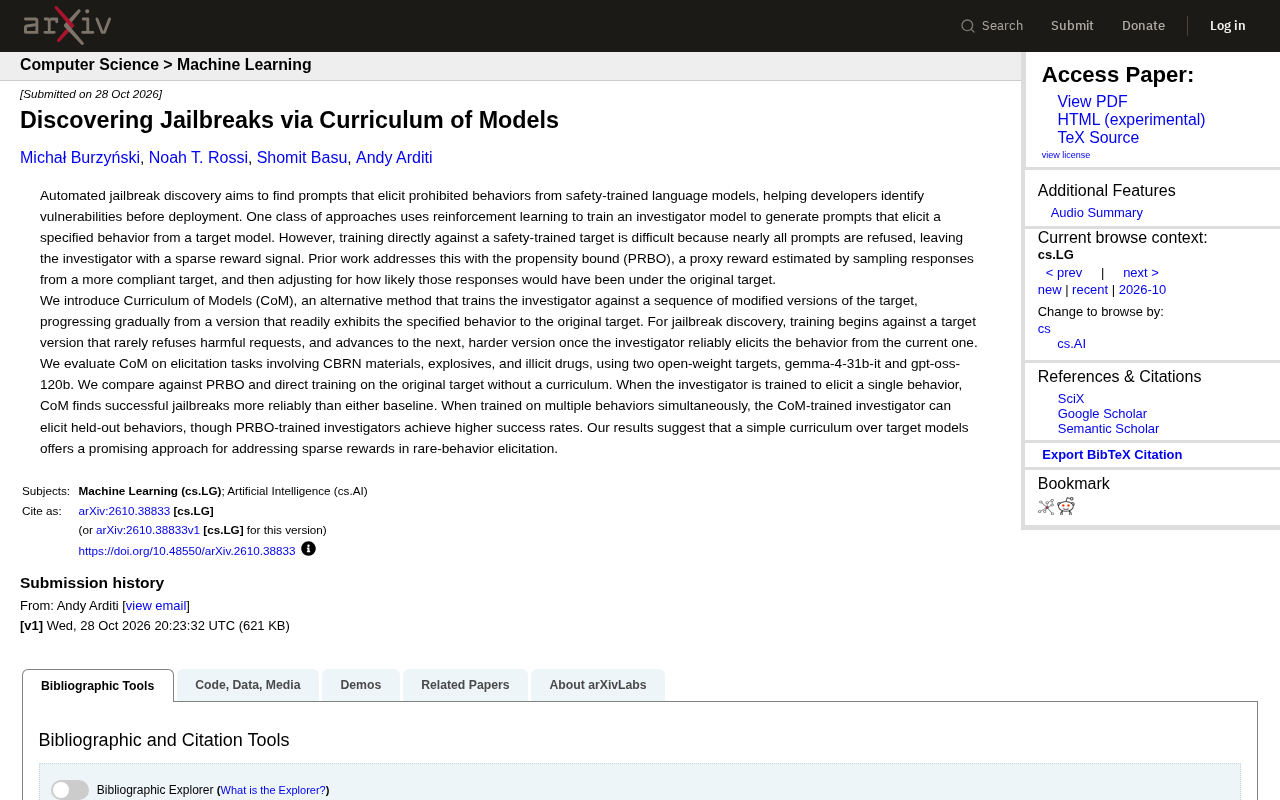
模型课程学习:破解安全对齐的新思路
模型课程学习(CoM)通过逐步从易到难的目标模型版本训练调查者,缓解越狱发现中的稀疏奖励问题,在单行为诱导任务上比PRBO更可靠。

GUIDER:攻克临床指南推理的路径-答案鸿沟
GUIDER 提出联合优化决策流控制器与推理策略的方法,用多流过程奖励应对路径多样性,以答案正确性门控弥合路径-答案鸿沟,在 MedGUIDE 及多个域外临床基准上超越 CRPO、MRPO、FaithMed。

强化扩散模型FitzRoy:精准且真实的降水预报新突破
FitzRoy系统利用强化扩散框架,首次在美国大陆同时实现领先的降水预报技巧与物理真实感,成功捕捉德州山洪和密苏里洪水等极端事件,解决逐点精度与结构保真度的长期权衡。

纯棋盘输入训练贪吃蛇AI:简化设计击败复杂特征工程
开发者用C++17和PPO训练贪吃蛇智能体,仅用固定棋盘one-hot输入,平均得分267/297,21%对局填满棋盘。实验揭示gamma比特征工程更重要,简化输入反超复杂设计,并分享失败回放与价值估计校准的实践经验。

自博弈AI为何总被廉价兵种打崩?RTS开发者亲述困境
独立开发者用纯自博弈训练RTS指挥官AI,却发现AI对历史版本胜率极高,却被人类玩家用廉价一级兵种击溃。本文分析自博弈策略坍塌的成因,探讨剥削者、多样性奖励与奖励设计等解决路径,并介绍其开放Bot Kit与AI联赛计划。
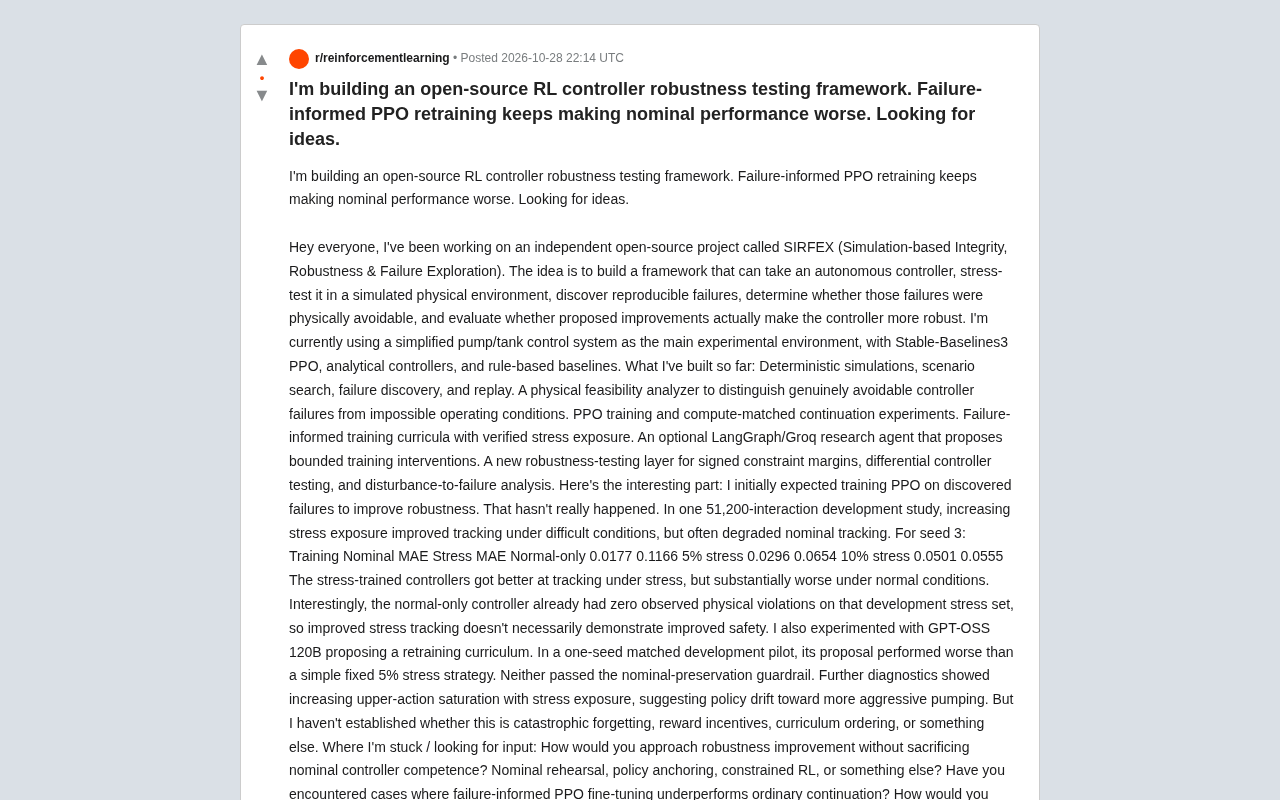
开源鲁棒性测试框架SIRFEX:失败驱动的PPO重训为何拖累正常性能?
开源框架SIRFEX用失败场景微调PPO,却导致标称性能下降。本文解析其实验数据、负结果原因,并探讨鲁棒性提升与标称性能保持的平衡之道。
用RL智能体生成多样化量子电路:QEC研究的小步突破
Reddit研究者分享用强化学习训练智能体生成多样化量子电路,为量子纠错(QEC)研究提供更丰富的候选方案。文章解析这一小步突破的思路、价值与局限。
GRPO值函数近似:能否偏离均值?
Reddit社区讨论GRPO中值函数近似偏离组内均值的可能性,探讨数据规模、任务类型和模型规模对基线选择的影响,指出当前文献空白与潜在实验方向。
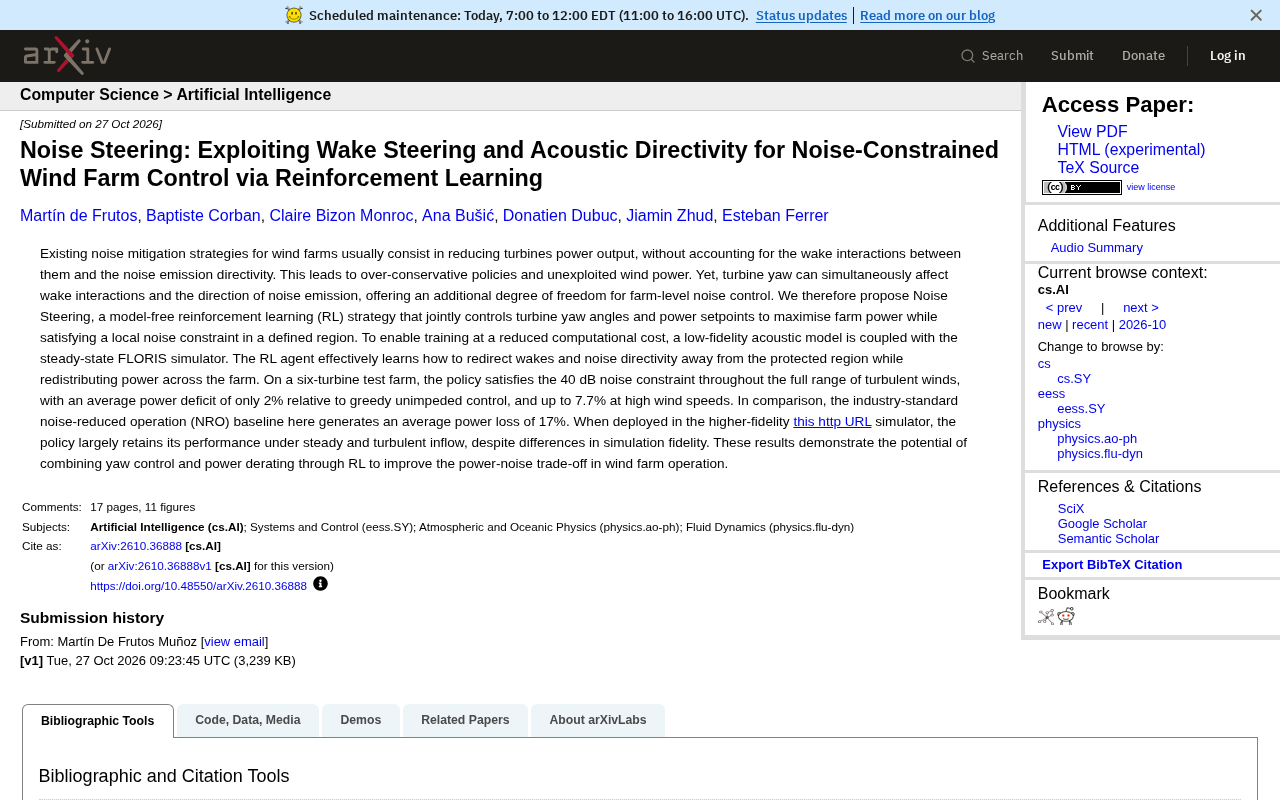
强化学习实现风电场降噪与发电双赢
风电场噪声治理新思路:强化学习联合控制偏航角与功率设定点,在满足40 dB噪声约束下将平均功率损失从行业标准的17%降至2%,实现降噪与发电的双赢。
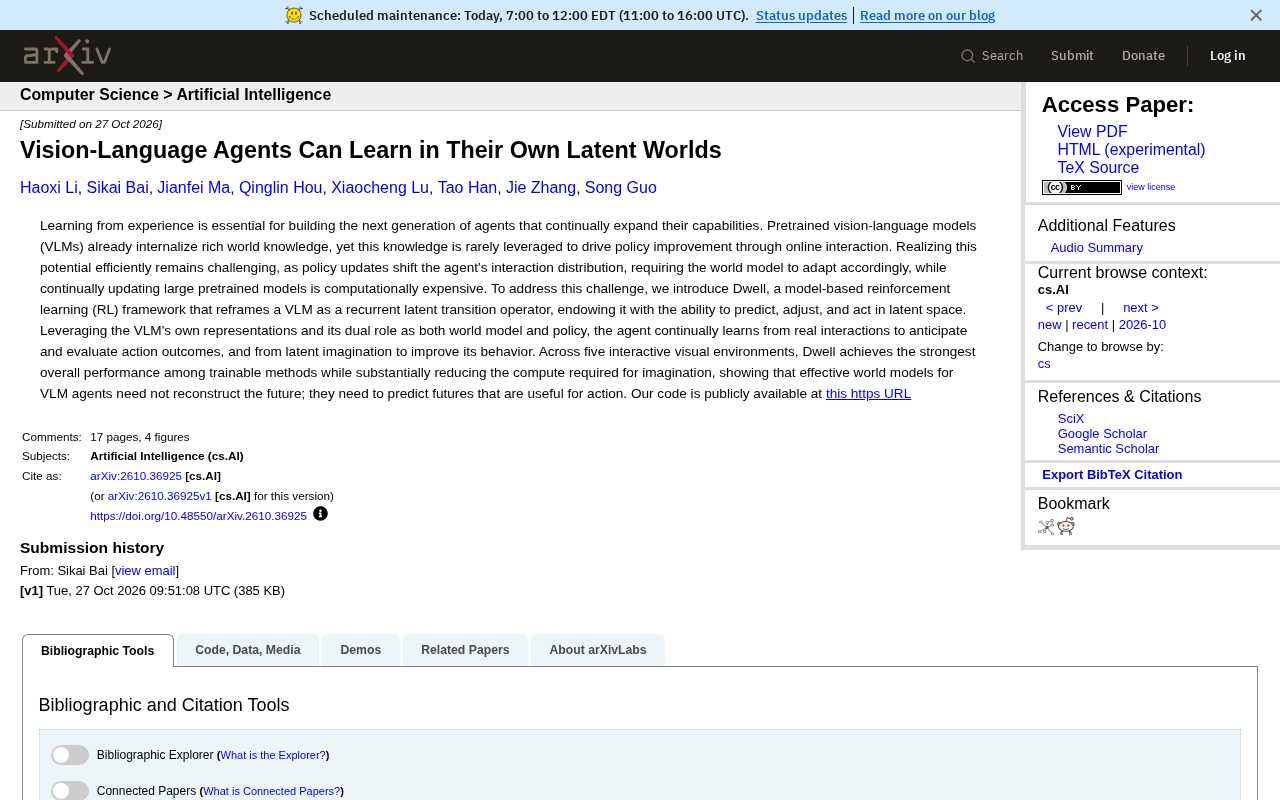
VLM智能体在潜在世界中自我进化:Dwell框架解析
Dwell框架将VLM重构为循环潜在转移算子,让智能体在潜在空间中预测和行动,在五个交互式视觉环境中取得最强整体性能,同时大幅降低想象计算量。
PPO训练Franka机械臂抓取放置:一个强化学习入门项目
一个用PPO算法在PyBullet中训练Franka Panda机械臂完成抓取放置任务的强化学习项目,涵盖技术栈选型、任务设计难点与未来文本/语音指令交互计划,适合入门者参考。
微软工程师拆解Agentic AI训练:数据与评分器才是胜负手
微软工程师在UC Berkeley课程中详解Agentic AI模型训练实战:可验证与不可验证数据的处理、rubrics评分器设计、奖励黑客防范、异步强化学习效率优化,以及测试时与训练时扩展的未来方向。
RL博士研究方向怎么选?六大前沿领域深度解析
RL博士研究方向怎么选?本文深度解析RL for LLMs、离线RL、安全RL、世界模型、多智能体RL和机器人RL六大前沿方向的开放问题、优势与风险,并提供兴趣匹配、产业价值平衡、导师匹配和技能可迁移性四个选择框架,帮助博士生做出明智决策。

FOCUS:主动评论家学习破解长程智能体信用分配难题
FOCUS 提出选择性分支与主动评论家学习,缓解长程语言模型智能体的信用分配难题,在 BrowseComp-Plus 等基准上以匹配预算超越 GRPO 和 VinePPO。

RLEC:让大模型学会按置信度目标决定答或不答
RLEC 提出用强化学习训练单一 LLM 响应显式置信度目标:用户在提示中指定准确率 p,模型自主决定作答或弃权。文章解析此前方法失败的两大原因——奖励信号丢失与惩罚无界增长,以及 RLEC 的稳定奖励族与奖励调度设计。

SimPOTrans:用强化学习让离线语音翻译模型自适应同传
SimPOTrans 提出基于强化学习的两阶段后训练框架,让离线语音翻译模型自适应为对话式同传模型,无需合成读写轨迹或显式延迟优化,推理时通过调整语音分块大小灵活控制质量与延迟,在多个基准和语言方向上取得更优的质量—延迟权衡。
Hugging Face Journal Club:Score Centering如何稳定离线强化学习
Hugging Face Journal Club讨论的论文提出Score Centering方法,通过数学修正消除推理与训练不匹配导致的漂移,在极端量化下稳定LLM强化学习训练,top-k近似实现高效计算。