#推理优化
共 57 篇相关文章

GLM-5.3 在 8×MI355X 实现 469 tok/s:vLLM 与 TileRT 分离式推理解析
TileRT 与 AMD 团队在 8×MI355X 上让 GLM-5.3 实现 469 tok/s 单用户解码,通过 vLLM 处理 prefill、TileRT 处理延迟关键的 decode 的分离式架构。本文解析其技术原理与行业意义。

金丝雀发布:生产环境零停机升级AI模型的实战方法
金丝雀发布(Canary Rollout)让生产环境AI模型升级实现零停机。本文解析分阶段流量爬升、指标门控与自动回滚三大机制,以及它在专用推理场景的落地实践。
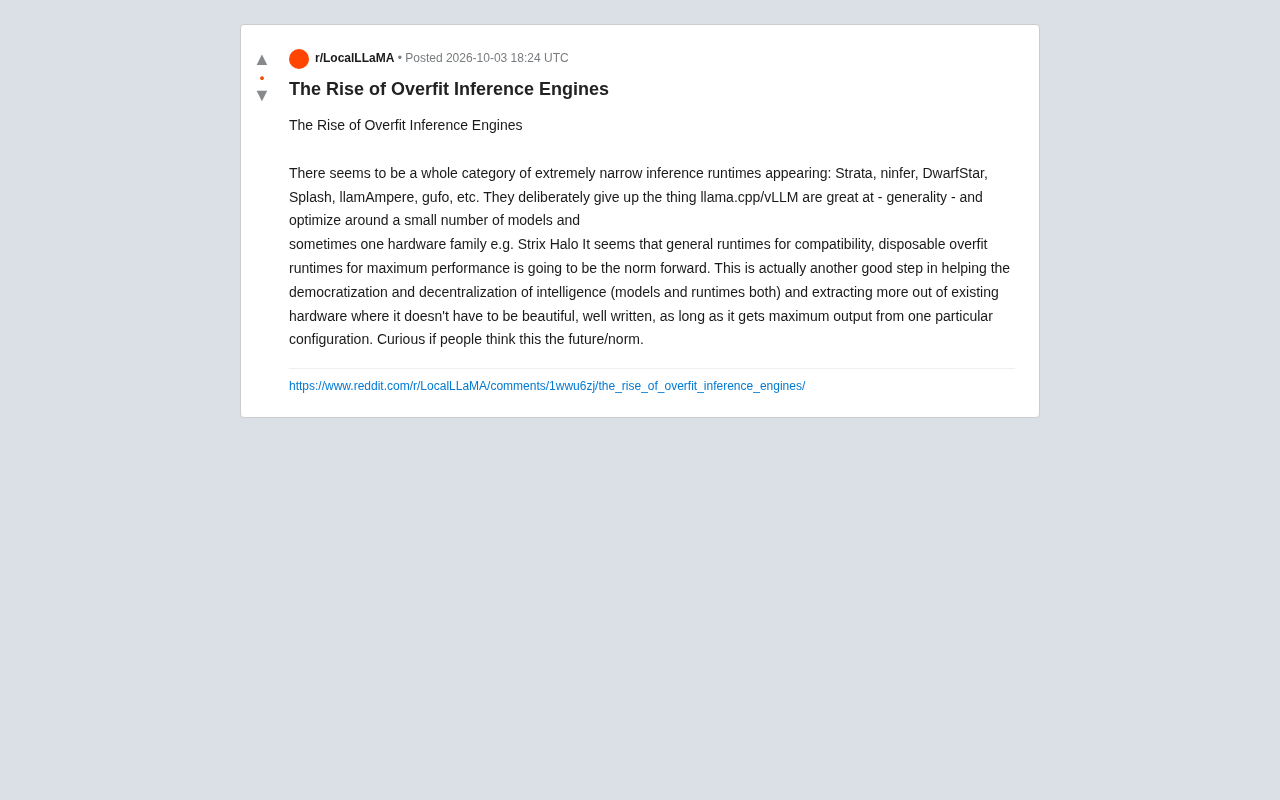
过拟合推理引擎崛起:专用化如何重塑AI本地部署
一批名为Strata、ninfer、DwarfStar的"过拟合推理引擎"正在崛起,它们放弃通用性、专注单一硬件与模型的极致性能优化。本文解析这类专用推理运行时的技术逻辑、价值主张及其对AI本地部署民主化的意义。
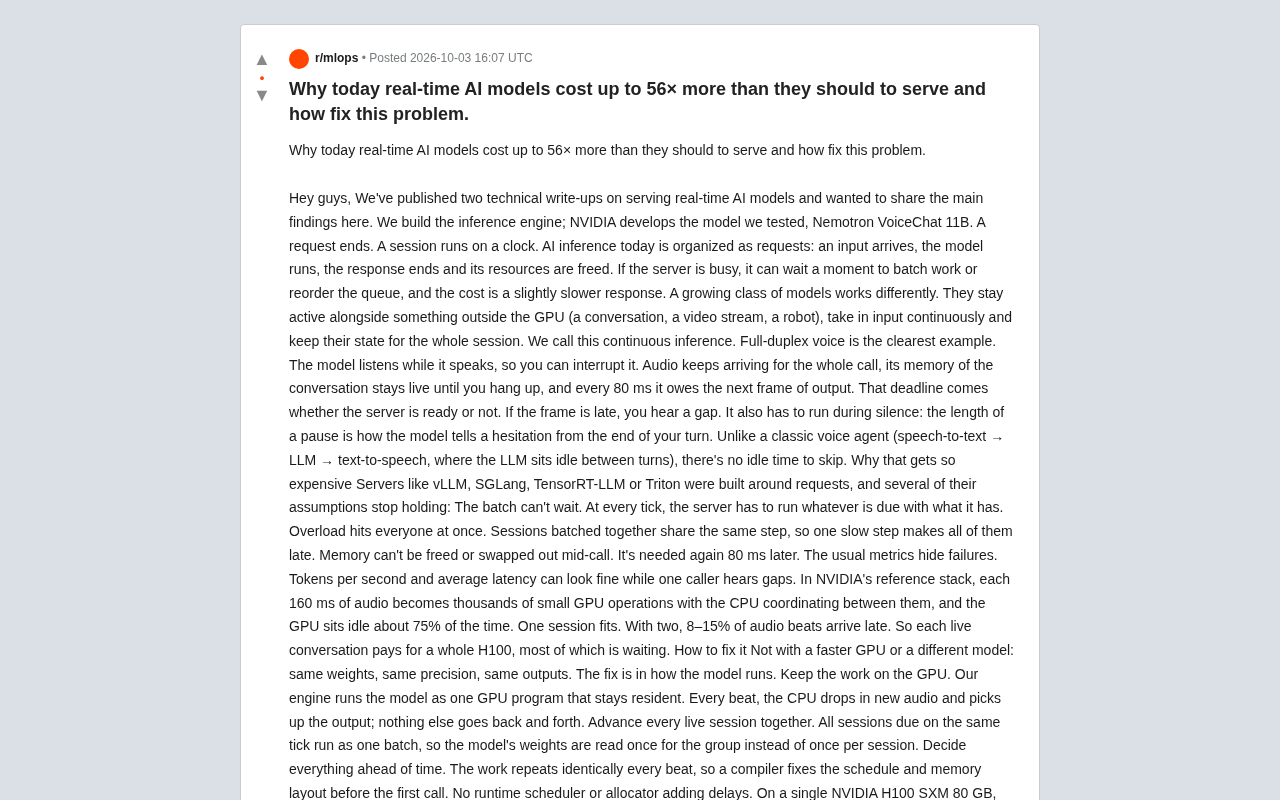
实时AI推理为何贵56倍?持续推理与常驻内核的破局之道
实时AI模型为何服务成本高达应有的56倍?本文解析请求式推理与持续推理的差异,拆解全双工语音模型在H100上从1到56并发会话的优化方案——常驻GPU内核、同步批处理与编译期调度。

Fireworks推出Ember-1:推理更短,Token省40%
Fireworks Research发布Ember-1推理模型,基于Kimi K3构建,可减少约40%的token消耗同时保持顶级质量。本文解析其效率优化的意义与行业价值。

TPU megakernel 让 Kimi K3 达到 709 tokens/s,超越 GB200
@inferact 团队开源针对 Kimi K3 的 TPU megakernel,实现 709 tokens/s 吞吐,超越 GB200 的 450 tokens/s。文章解析其将 92 层 MoE 融合进单一 Pallas 内核及跨层权重预取的优化思路。
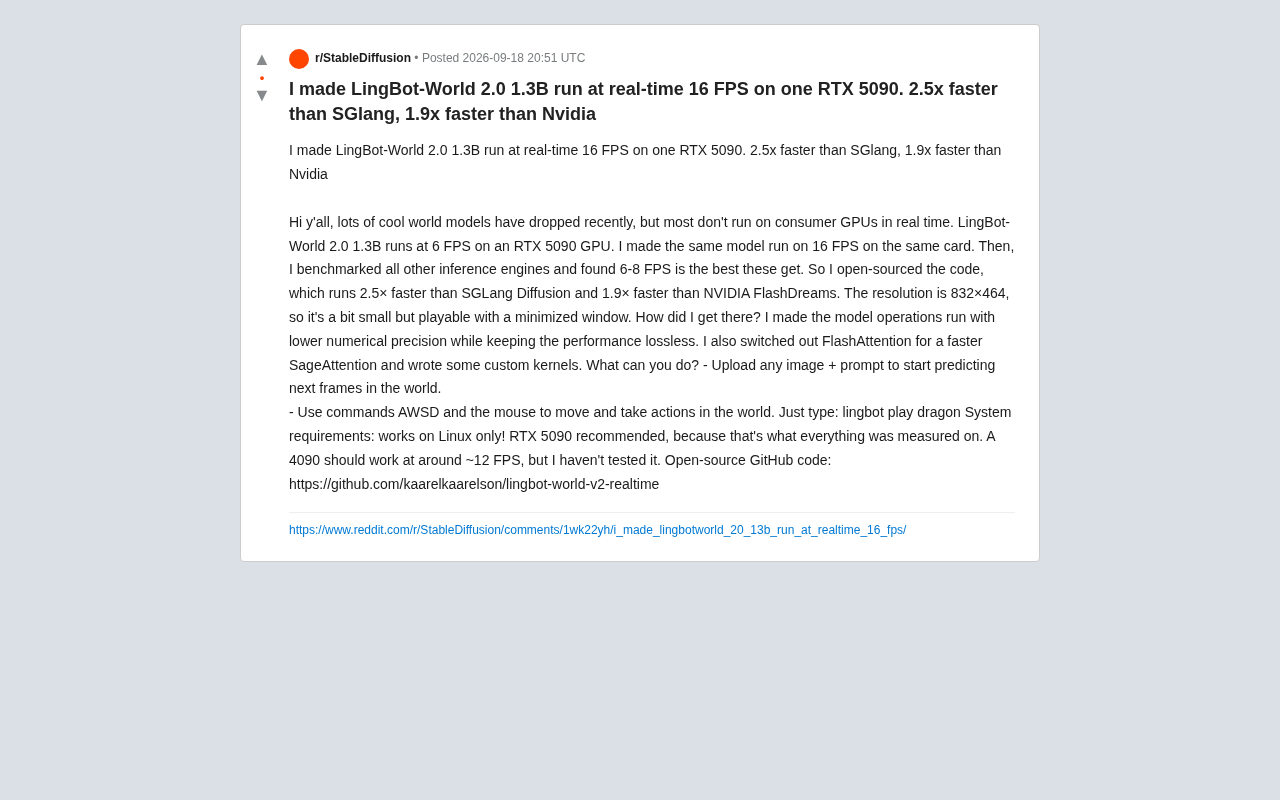
单张RTX 5090跑出16 FPS:LingBot-World 2.0实时世界模型优化实战
开发者将LingBot-World 2.0 1.3B世界模型在单张RTX 5090上优化到实时16 FPS,比SGLang快2.5倍、比NVIDIA FlashDreams快1.9倍,并开源代码。本文解析其低精度运算、SageAttention和自定义内核三大优化手段。
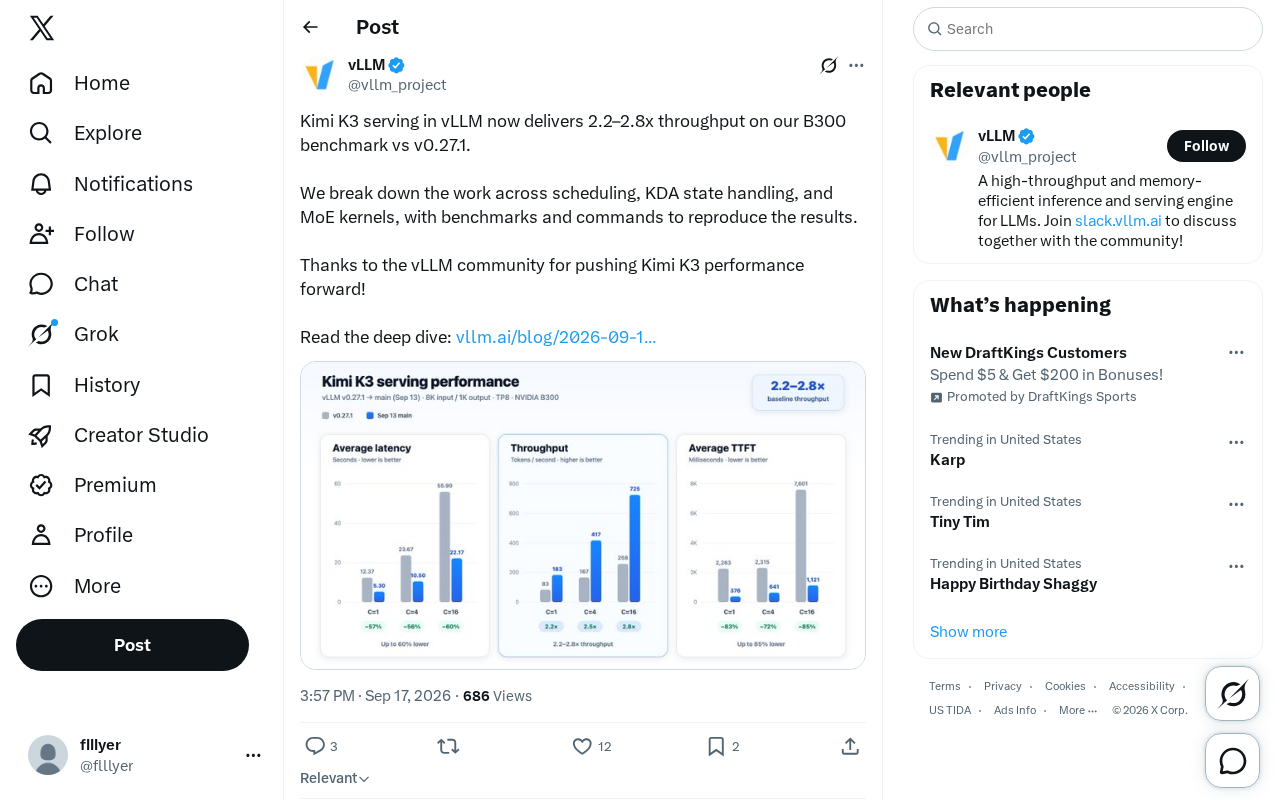
vLLM 部署 Kimi K3 吞吐量提升 2.2–2.8 倍:性能优化拆解
Kimi K3 在 vLLM 上的部署性能获得显著提升,B300 基准测试显示吞吐量较 v0.27.1 提升 2.2–2.8 倍。本文拆解调度、KDA 状态处理与 MoE 内核三大优化方向及其对推理成本的影响。
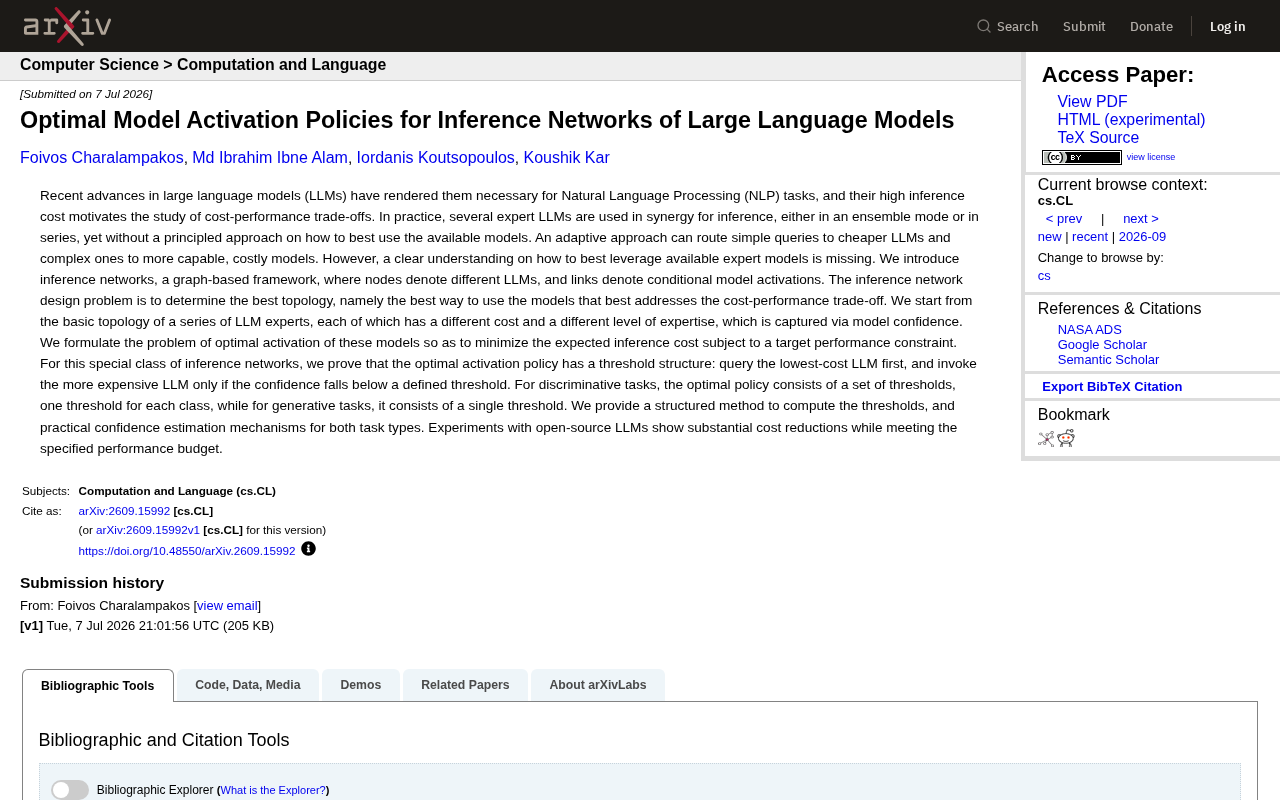
推理网络:用阈值策略优化大模型推理成本
arXiv 最新研究提出「推理网络」图框架,用于优化大语言模型的推理成本。论文证明最优模型激活策略具有阈值结构:先用低成本模型,置信度不足时再调用昂贵模型,在开源 LLM 上实现显著降本。
Jev前沿模型问世:成本降40-400倍,速度提升20-200倍
新前沿模型Jev宣称成本降低40-400倍、速度提升20-200倍,引发Hacker News热议。本文解析其性价比卖点、效率突破的可能路径,以及如何理性看待这组惊人数字。
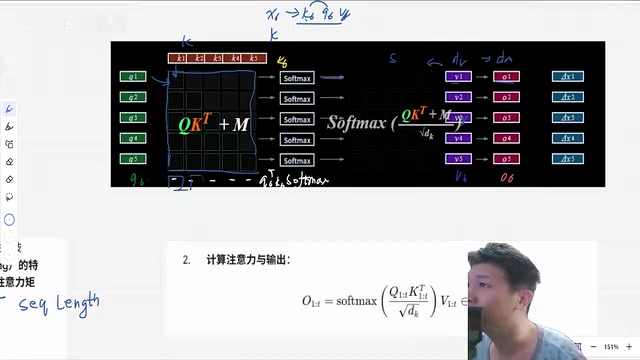
深入理解 KV Cache:大模型推理的空间换时间优化
深入解析大模型推理中的 KV Cache 技术:从无缓存的重复计算问题出发,讲清键值缓存的实现原理、新词计算流程、时间复杂度对比以及显存开销估算公式,帮助理解 Transformer 推理的性能优化。
vLLM 全栈优化实战:如何应对真实 Agent 流量的服务压力
vLLM 全栈优化实战:如何应对真实 Agent 流量的服务压力
vLLM 团队发布全栈优化博客,针对真实 Agent 流量对推理服务栈的压力,从架构、框架到运行时协同优化,并在 SemiAnalysis 的 AgentX 公开基准上进行测量。本文解析其优化思路与工程启示。
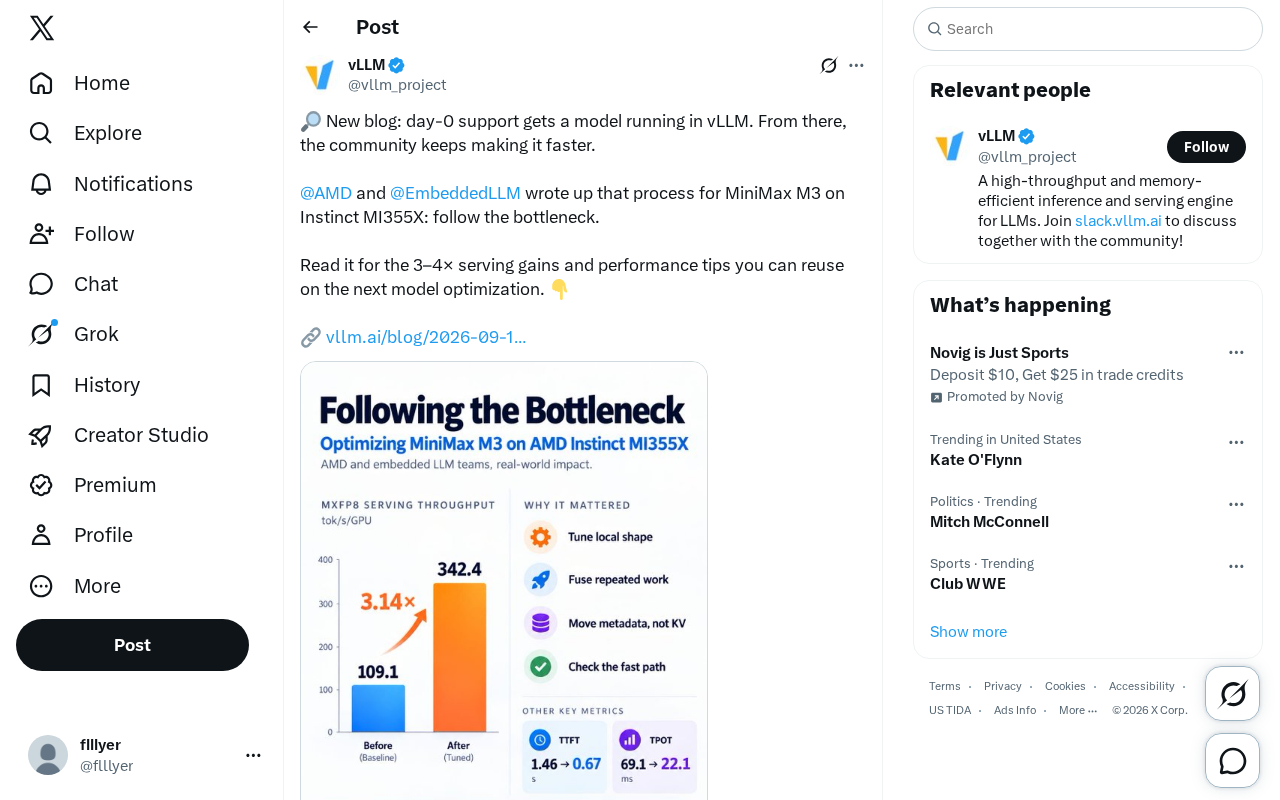
vLLM Day-0支持之后:社区如何把MiniMax M3推理提速3-4倍
AMD与EmbeddedLLM发布博客,记录在Instinct MI355X上优化MiniMax M3的vLLM推理服务过程,通过“跟着瓶颈走”的方法实现3-4倍吞吐提升。解析day-0支持与社区调优范式。
 教程攻略
DeepSeek V4 Flash MTP推测解码实测:本地推理提速20%指南
实测DeepSeek V4 Flash开启MTP推测解码后的性能表现:代码生成场景提速约20%,文本生成提升有限。详解内存开销、准确性差异、Q4与Q3量化对比,以及通过Inference应用和OpenAI兼容API的完整部署教程。
 行业洞察
NVIDIA Dynamo Snapshot:GPU推理冷启动问题的快照恢复方案
深入解析NVIDIA Dynamo Snapshot如何通过GPU状态快照与恢复机制,将大模型推理服务的冷启动时间从分钟级降至秒级,涵盖Kubernetes集成、技术实现挑战及弹性推理等实际应用场景。
 科技前沿
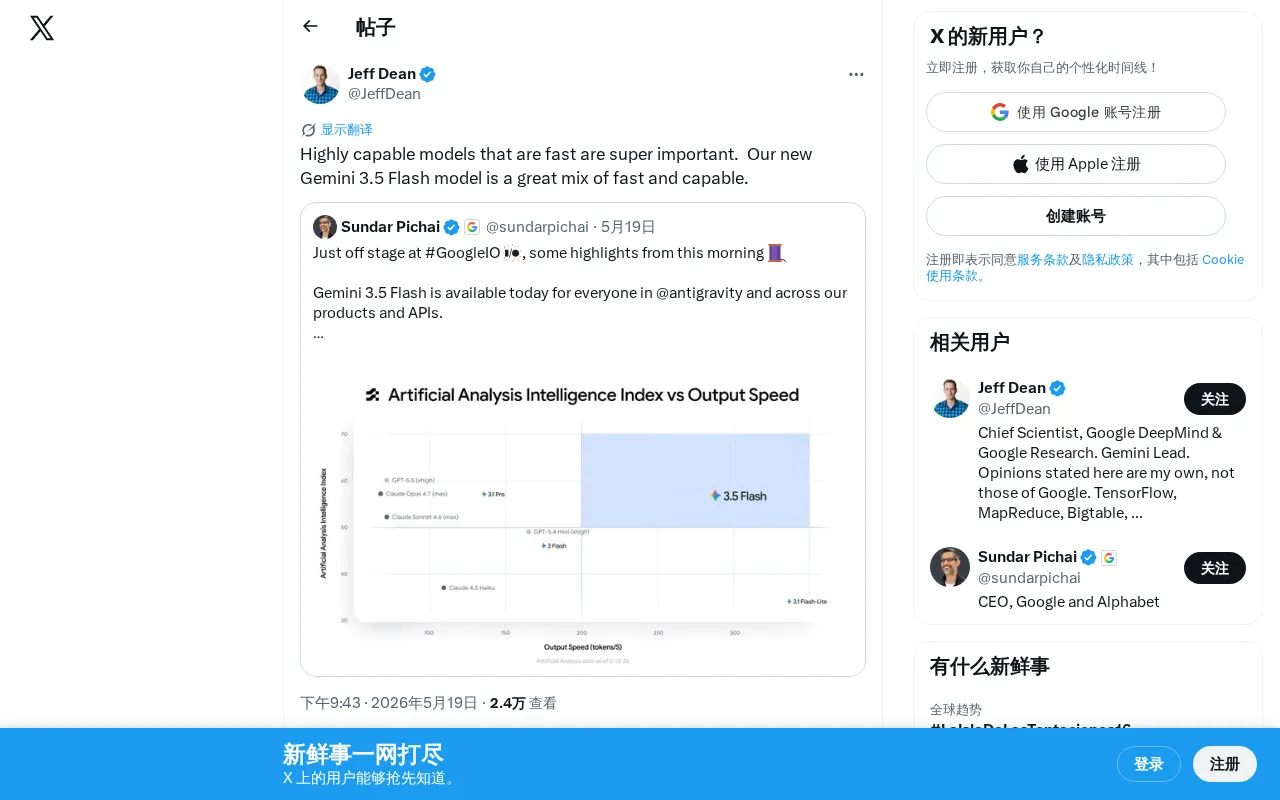
Gemini 3.5 Flash发布:Google如何平衡AI模型速度与能力
Google发布Gemini 3.5 Flash模型,主打速度与能力的最佳平衡。本文解析Flash系列定位演进、与GPT-4o mini等竞品对比,以及对开发者和企业用户的实际应用价值。
 深度解读
AI模型部署流水线摩擦:TensorRT如何系统性消除推理优化瓶颈
深入解析AI模型从训练到生产部署中的流水线摩擦问题,详解TensorRT自动化优化、ONNX模型导出、Triton推理服务器等关键技术,提供消除部署瓶颈的最佳实践方案。