#本地推理
共 54 篇相关文章

Llmspeed:买硬件前先测本地LLM跑速
Llmspeed 是 Hacker News 上发布的开源测速项目,帮助开发者在购买硬件前预估本地大语言模型的推理速度。本文解析本地 LLM 跑速的关键影响因素、用测速数据做选型决策的方法,以及社区众包测速库的价值与局限。

Lucebox:让异构消费级GPU跑出投机解码加速
Lucebox 是面向异构消费级 GPU 的 C++ 投机解码推理服务器,用小模型草稿 + 大模型验证的方式,在混搭显卡、核显或 CPU 上实现 1.5x–3x 的本地 LLM 推理加速,并兼容 OpenAI 接口。

本地部署Jev决策API:Docker与DGX Spark实测
在NVIDIA DGX Spark上用Docker本地部署Jev式决策API的完整教程,包含镜像选择、检查点锁定、内存实测与十个开源权重模型的检索准确率对比数据。

开源权重模型能当Agent廉价层吗?实测出炉
实测两个开源权重模型(qwen3.8、nemotron-3.5-lightning)作为Agent廉价层的表现:成本$0但延迟18.9秒,nemotron有效回答率仅45%。通过agentgateway对比Claude Sonnet 5的60题基准结果与分析。

本地AI CRM:让客户对话永不离开你的笔记本
Private AI Lead Assistant是一款完全本地运行的CRM工具,用Qwen 2.5 1.5B和Ollama将客户对话提取为结构化线索,数据永不离开笔记本。包含约束解码、Zod校验和提示注入防护的工程实践。

RTX 3090实测:Qwen 381 tok/s神话破灭,真实聊天仅118
RTX 3090实测HyperQwen推理栈:Qwen 27B模型真实聊天118 tok/s,381 tok/s仅限引用场景且长上下文下崩溃,包含完整性能数据与运营避坑指南。

用Ghidra逆向CUDA推理引擎,RTX 3090提速12%
开发者用Ghidra逆向分析CUDA推理引擎Strata的符号表,结合多会话交替的访问模式,在RTX 3090上实现解码提速12%,会话切换延迟降低25倍,并记录了六个无效优化方案的数据。

HowToLiveBetter 实测:63851 星开源人生指南
实测 GitHub 63851 星开源项目 HowToLiveBetter:一套覆盖健康、理财、法律、社保、婚育、创业合规的高性价比人生指南。支持在线试用、自托管和 MonkeyCode 本地推理,免费且隐私优先。

SponsorPulse:本地优先的品牌报价量化与谈判AI智能体
SponsorPulse 是一个本地优先的创作者品牌报价量化工具,用 TabPFN-3.5 计算分位数价格带,本地 Gemma 3:1b 生成谈判邮件,并通过数值防火墙拦截 LLM 幻觉数字。
你的GPU就是一座数据中心:本地AI运维指南
消费级GPU跑本地AI不是免费推理,而是你兼任设施、网络和运维。本文基于Ayraix社区实践,解析如何用数据中心思维管理本地GPU:容量规划、队列纪律、散热供电、运行手册与起飞前测试。

本地Gemma模型帮你找出客户为何沉默
FollowUp Local是一款开源本地工具,通过Ollama运行Gemma模型分析客户聊天记录,识别客户卡在哪个阶段、真实顾虑是什么,并草拟跟进消息。聊天数据永不离开本机,适合在私信和微信上做小生意的卖家。

Ollama v0.40.4 预发布:llama.cpp 升级与 MLX 优化
Ollama 发布 v0.40.4 预发布版本,升级 llama.cpp 至 b11521 支持 EmbeddingGemma 2,优化服务端模型复用、MLX 状态管理及 Codex 集成。

破解PS5运行Qwen 27B:GPU推理速度达20 tok/s
Reddit用户展示在破解PS5上通过GPU运行Qwen 27B大模型,推理速度达20 tok/s。本文分析其技术路径、硬件可行性及对本地AI推理硬件多元化的启示。

本地优先AI路由器GreenRoute:该让提示词离开你的笔记本吗?
GreenRoute是一个本地优先AI路由器,用规则引擎判断每个LLM请求该本地处理还是送云端。60个提示词基准测试显示:本地保留58%请求,能量降低48%,但1B模型在翻译和提取任务上可靠性不足。

闲置Mac组建分布式GPU集群:LLM推理完整实操指南
利用闲置Apple Silicon Mac组建分布式GPU集群运行LLM推理:Exo+Ray编排、llama.cpp统一内存优化、powermetrics监控与自动扩缩,24小时电费不到$0.04的完整实操方案。

Liquid AI d1-3B:笔记本上的本地决策模型
Liquid AI 发布 d1-3B,一个专为笔记本本地决策场景设计的 3B 参数模型,主打低延迟的意图分类、工具路由与内容闸门任务。本文分析其定位、适用场景与落地工程考量。

HowToLiveBetter开源项目实测:6万星的人生指南值得用吗
HowToLiveBetter开源项目获62020颗星,覆盖长寿防病、省钱理财、医保社保、失业工伤等人生指南。本文实测其速度、质量与成本,分析三种使用方式及潜在局限。

M5 Max 128GB 部署 oMLX 本地推理服务实战指南
oMLX 本地推理服务在 M5 Max 128GB 上的完整部署与调优指南:服务器参数、多模型共存选型、Claude Code 接入、推测解码实测提速数据,以及 0.6.4 版本的关键变化。

Superfluid:为多智能体而生的本地LLM推理服务器
Superfluid 是面向多智能体场景的开源本地LLM推理服务器,支持交互请求抢占批量任务、token级日志恢复、OpenAI/Anthropic/Ollama三协议兼容,以及跨设备分布式推理,实测聊天首token延迟比llama-server快数十倍。
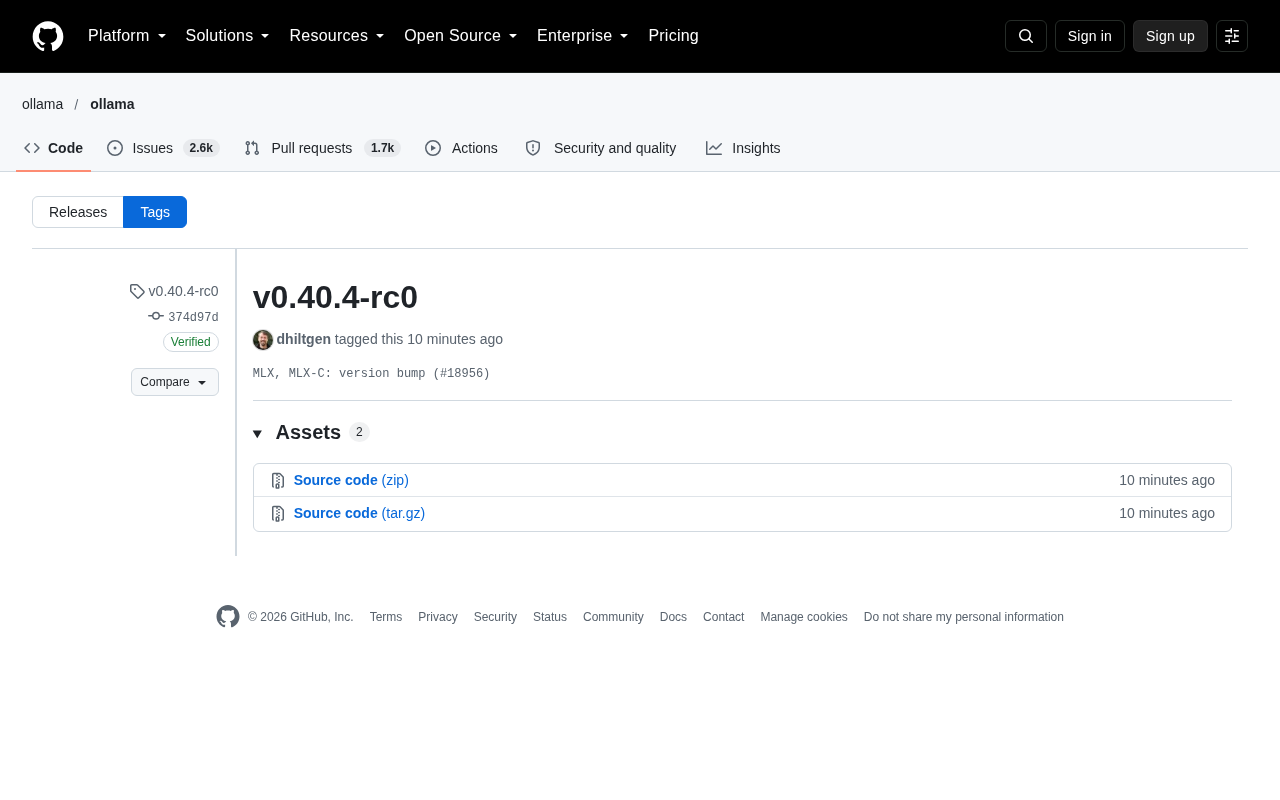
Ollama v0.40.4-rc0 发布:MLX 版本升级意味着什么
Ollama 发布 v0.40.4-rc0 预发布版本,核心变更是 MLX 和 MLX-C 版本升级。本文分析这次更新对 Apple Silicon 用户本地推理性能的影响,以及是否值得升级。