#本地推理
共 54 篇相关文章

用开源AI走出家门:Gemma本地推理打造园艺助手TGA
开源项目 The Gardening Assistant(TGA)用 Google Gemma 本地推理打造 AI 园艺助手,结合植物学数据与规则兜底引擎,帮用户规划四周户外任务、少盯屏幕。本文解析其架构、技术栈与开放式创新理念。

Campus Flora Finder:离线优先的本地AI植物识别应用
Campus Flora Finder 是一款完全离线、隐私优先的 AI 植物识别应用,基于 Streamlit 与 Ollama 本地运行 llava、moondream 等开源视觉模型,无需联网即可识别植物并给出学名与生态信息。
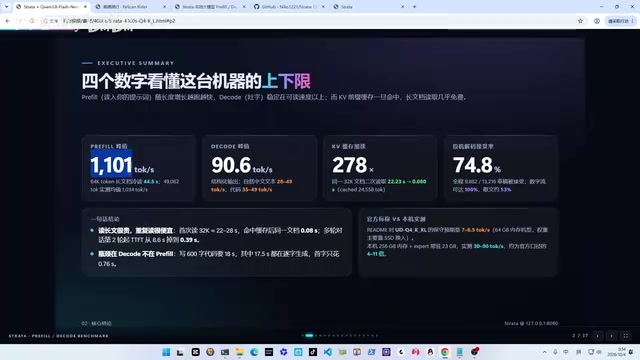
AMD 7900XTX 实测 Strata 跑 Qwen3:IQ3 量化 60-80 t/s
AMD 7900XTX 显卡实测开源项目 Strata,在 Windows 11 上跑 Qwen3 IQ3_XSS 量化模型,输出速度 60-80 t/s,附安装配置与多卡设置经验,A 卡本地推理终于可用。
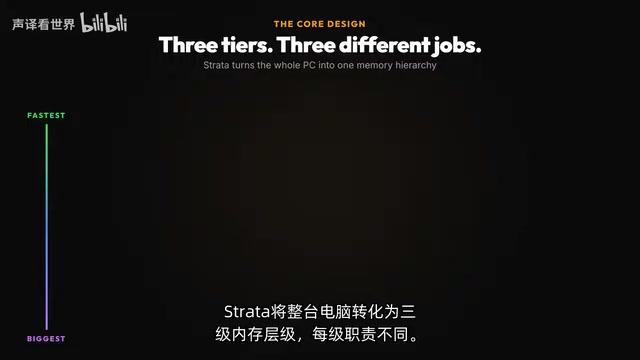
Strata开源运行时:12GB显卡跑动125B参数Qwen3模型
开源推理运行时Strata通过三级内存层级、热门专家缓存、推测解码等技术,让12GB显存的RTX 5070跑动1250亿参数的Qwen3.8 Flash Next稀疏MoE模型,速度约90 Token/秒。本文拆解其核心架构设计。

Clef Flash实时玩贪吃蛇:9B模型在RTX 5080上的推理实验
Clef Flash(9B模型Q4量化)在RTX 5080上实时玩贪吃蛇,无需训练、无需破解游戏状态,仅凭简单指令即可在135毫秒决策窗口内做出判断。本文解析这一通用模型实时决策实验的价值与局限。

把iPhone变成MacBook第二块GPU:本地大模型预填充提速29–44%
开发者用一根USB-C线将iPhone 17 Pro Max接入24GB M4 Pro MacBook,充当第二块GPU,为本地Qwen 3.8 27B模型分担计算,实现预填充提速29–44%,并把部分KV缓存卸载到手机,突破64k上下文的内存限制。

Magnitude:自调优推理引擎,剑指本地AI智能体后端
Magnitude 是一款 Apache-2.0 开源推理引擎,能在本地硬件上自动编译调优内核,宣称解码速度最高达 llama.cpp 的两倍,并集成 OpenCode、Codex 和 Claude Code,剑指 AI 智能体本地后端。
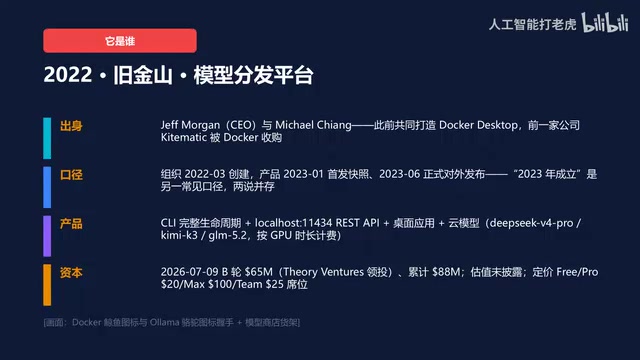
Ollama深度拆解:14人团队如何靠分发做成AI界Docker
深度拆解Ollama:14人团队如何靠Docker式分发做成AI界顶流。剖析其双推理后端、KV量化、MTP提速的技术底牌,以及推理层依附上游、量化落后前沿等真实短板与护城河。

双RTX 3090+大众高尔夫水箱:硬核玩家的自制AI推理主机
一位Reddit玩家用双RTX 3090、裸奔ThinkPad主板和一只24欧元大众高尔夫水箱,自制出名为2400cc Inference Racer的AI推理主机,通过NVLink和BIOS魔改跑vLLM部署Qwen3大模型,展现本地推理DIY的极限。

M5 Ultra AI性能实测:矩阵算力翻近5倍的最强AI Mac
M5 Ultra AI性能实测:本地视频生成、大模型Prefill与Decode全维度对比M3 Ultra,矩阵算力提升近5倍。深度解析Neural Accelerator与Ultra Fusion架构,为何它是最强AI Mac。
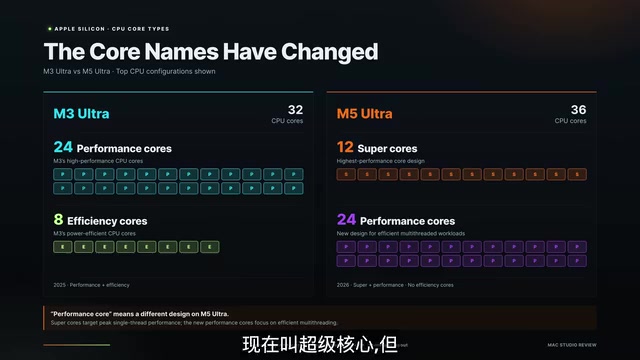
M5 Ultra Mac Studio深度评测:苹果4.3倍AI性能宣传属实吗?
M5 Ultra Mac Studio深度评测实测15项基准:四晶片架构、多核1.72倍、Blender 8倍、AI首token 4.1倍。苹果4.3倍AI性能宣传是否属实?统一内存在本地大模型推理中的真实优势解析。
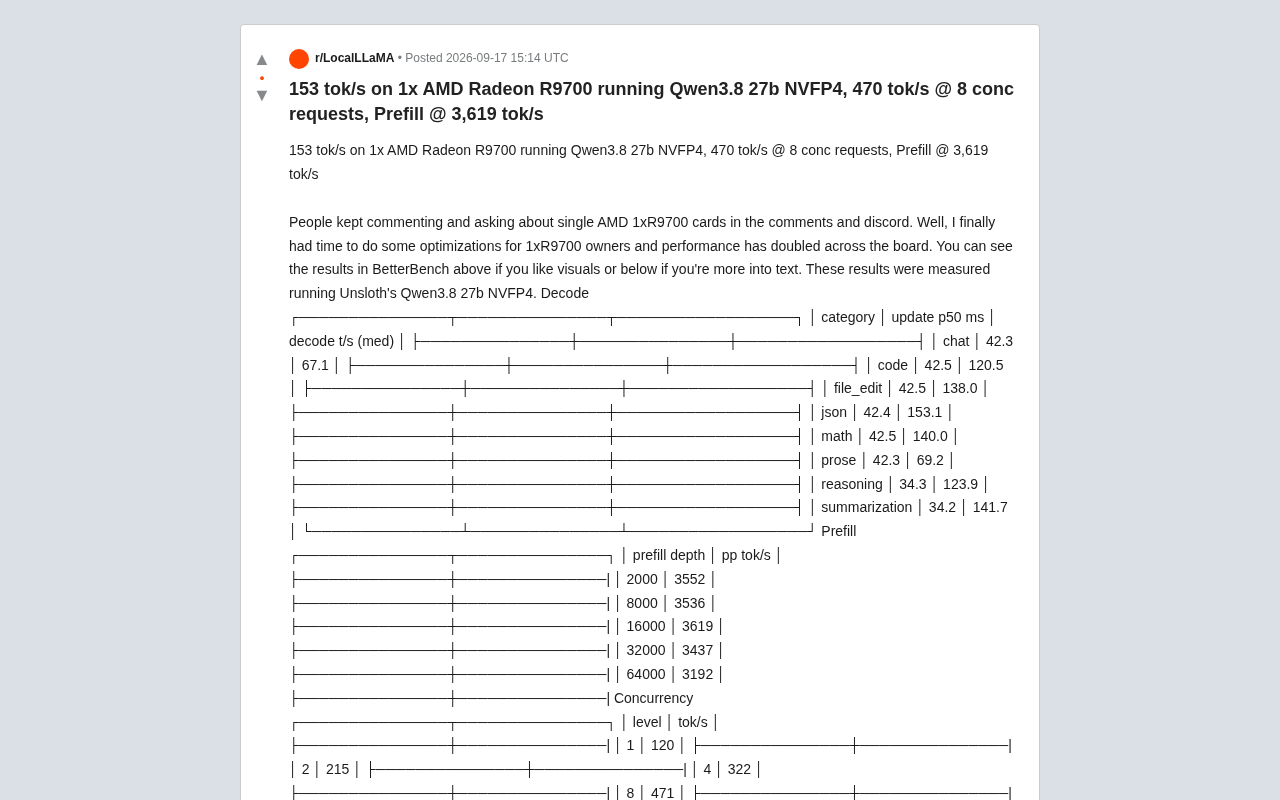
单张AMD R9700跑Qwen3 27B性能翻倍:解码153 tok/s实测解析
开发者实测单张AMD Radeon R9700运行Qwen3 27B NVFP4量化模型,优化后性能翻倍:解码峰值153 tok/s,8并发达471 tok/s,预填充3619 tok/s。本文详解各项数据与AMD本地推理生态意义。

