#模型微调
共 49 篇相关文章

Databricks × NVIDIA:用企业数据定制开源模型的新捷径
Databricks AI Runtime 与 NVIDIA 合作,让企业可用自有数据定制开源模型。本文解析该整合如何简化 GPU 训练管线、降低微调门槛,以及企业落地时仍需关注的数据与评估问题。

Qwen3-4B微调去除AI写作痕迹,Show HN项目引关注
Hacker News上的Show HN项目尝试微调Qwen3-4B模型,去除AI写作中常见的套话和机械表达,让生成文本更自然。本文分析其思路、小模型微调的优势与挑战。

行为耦合:微调一个行为为何会触发另一个?
论文提出行为耦合概念:微调一种行为会带出另一种。研究发现耦合可通过文档训练形成,并能在不同文档间复合,导致意外行为难以溯源,呼吁评估超越模型当前行为。
Qwen3-8B微调实测:LLM路由需要更多数据吗?
实测Qwen3-8B微调做LLM路由:用Tinker训练复杂度评分器,50条样本准确率86%却高于2500条的76%。分析合成数据标签一致性、小评估集陷阱与路由工程化实践。

本地恋爱聊天Copilot:322M判断+Gemma起草,数据不出电脑
Laya-Heart 是一个跑在本地电脑上的情侣聊天 Copilot:322M 的判断模型 Laya 读潜台词,Gemma 4 E2B 起草回复,默认不向云端发送任何内容。本文拆解它的本地推理优化、微调结果与安全设计。

当AI学会说"不确定":一个过敏原检测器的反直觉设计
开发者用微调Qwen3.5-4B构建开源过敏原检测器Contains,核心是三态判定:含、不含、需要核实。微调模型输给基座模型,但学会说"不确定";双层系统达86%召回且零误报。

合成数据投毒:企业微调中的模型崩溃威胁
企业微调中使用合成数据可能导致模型崩溃:递归训练使稀有尾部召回率从88%暴跌至29%,幻觉率飙升至52%。本文解析模型崩溃的数学原理、五轮递归微调实测数据,以及溯源水印、KL散度监控和尾部保留锚定等防护方案。

H100 跑 QLoRA 只比 4070 快 15%?真实瓶颈藏在数据管道
一位开发者用 H100 跑 QLoRA 只比 RTX 4070 快 15%,远低于预期的 4-5 倍。排查后发现瓶颈在数据管道:25GB 数据集反复从 S3 下载、基础模型未缓存、单线程预处理与过低 num_workers。修复后端到端时间从 9.5 小时降至 2 小时 40 分。

LoRA 智能体安全治理:从高效微调到行为依赖
LoRA 在 AI 智能体中既提升微调效率,也带来后门、对齐退化与组合攻击等安全风险。本文解析其机制、供应链隐患及身份、权限、组合、隔离、撤销五大治理面,探讨适配器治理的研究议程。

低成本微调9B决策分类器:无需前沿实验室预算
无需前沿实验室预算,仅靠监督微调(SFT)、公开数据集和两个简单技巧,就能在 Fireworks 平台微调出可用的 9B 决策分类器。完整配方已开源,开发者可复现训练自己的模型。

PewDiePie自制本地AI模型AJAX:拒绝监控的隐私实验
YouTube顶流PewDiePie自制本地AI模型AJAX,基于Odysseus框架微调,主打本地运行、拒绝监控与无审查。本文解析其知识蒸馏、两次被OpenAI封禁、去审查化技术及小模型哲学。
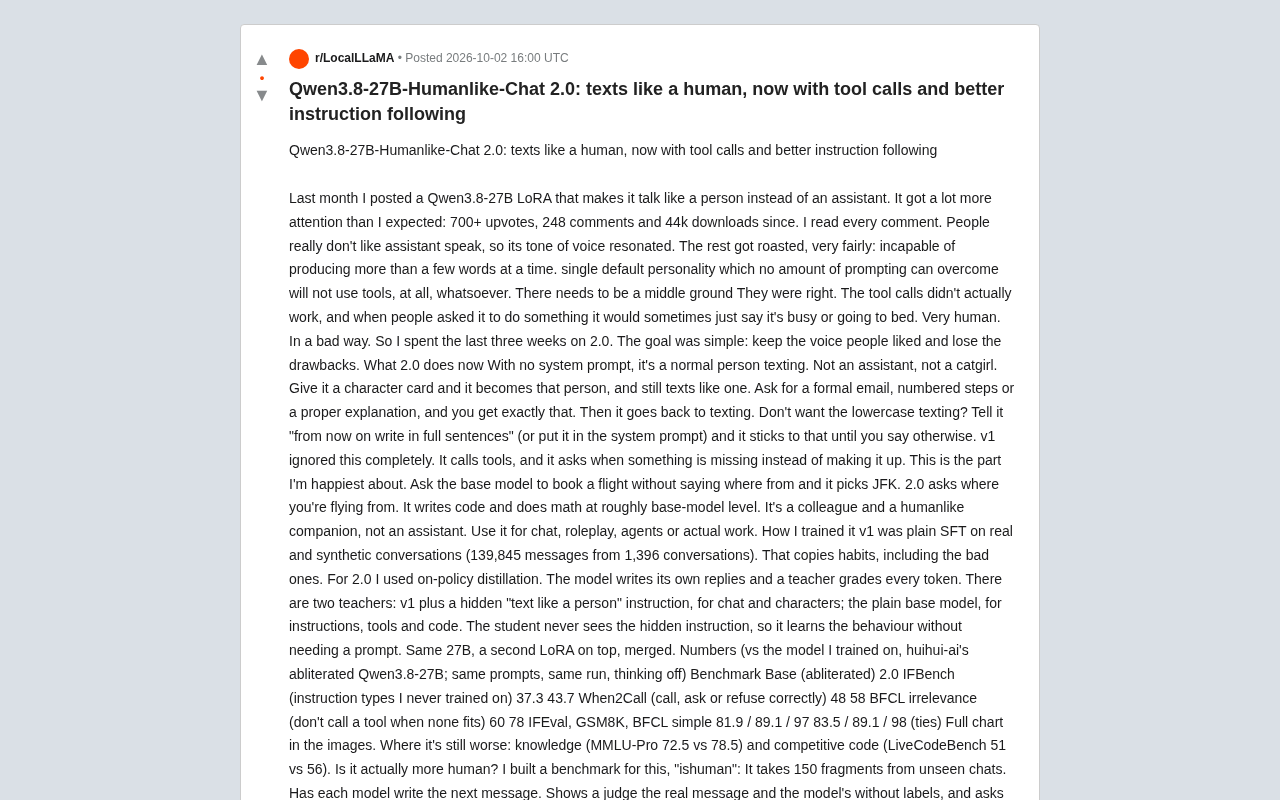
Qwen3.8-27B拟人化模型2.0:会聊天也会调用工具
Qwen3.8-27B-Humanlike-Chat 2.0 发布,在保留拟人化语气的同时新增工具调用与更强指令遵循。本文解析其双教师在线策略蒸馏训练法、Benchmark 数据与拟人化测试结果。
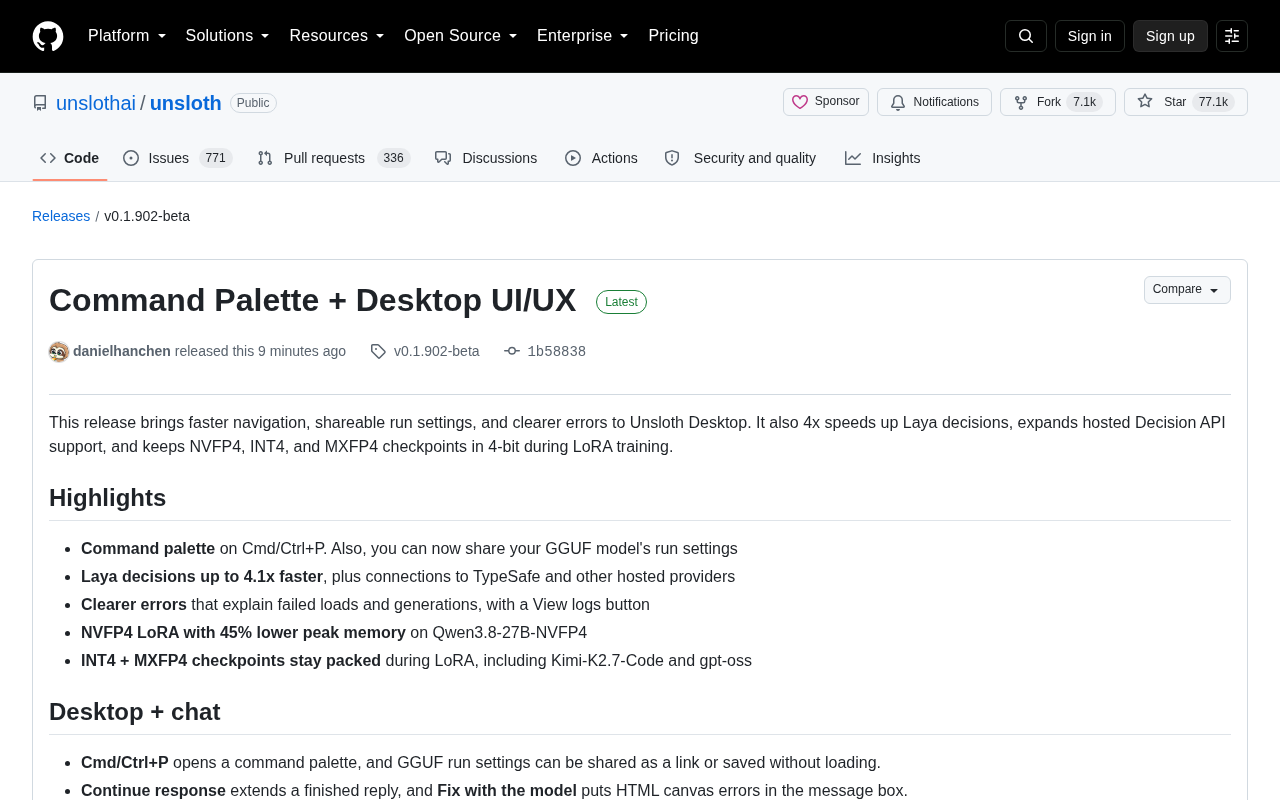
Unsloth Desktop 重磅更新:命令面板上线,4-bit 微调显存直降45%
Unsloth Desktop v0.1.902-beta 发布:新增命令面板、可分享运行设置,4-bit 预量化检查点保持打包训练让显存最高降低45%,Laya 决策提速4.1倍,涵盖 NVFP4、INT4、MXFP4 及跨平台支持。
Unsloth Desktop v0.1.901 发布:命令面板、4倍加速与低显存训练
Unsloth Desktop v0.1.901-beta 发布,带来命令面板、可分享运行配置、Laya 决策 4.1 倍提速,以及 NVFP4/INT4/MXFP4 检查点低显存 LoRA 训练,大幅降低本地大模型微调门槛。
微调NVIDIA Nemotron适配沙特阿拉伯方言:低资源语言的落地路径
NVIDIA分享如何微调Nemotron语音模型以识别沙特阿拉伯方言,并提炼出一套可迁移到其他低资源语言的通用路径,为全球语音AI本地化提供参考范例。

单卡在家微调:Jev风格决策模型的实测表现
一个独立项目用单张GPU在家微调Qwen3.5和Gemma 4,打造0.8B与2B决策模型,响应延迟仅22-28毫秒。本文解析其实测数据、复现方法及基准测试与真实场景的差距。
LessThink-Qwen3-4B:把推理Token砍掉44%
Reddit 开发者发布 LessThink-Qwen3-4B,通过后训练让 Qwen3-4B 的推理 token 减少 44%,在保持知识与回答风格的同时压缩思考开销,全程单卡完成。本文解读其思路、价值与需要打问号的地方。
微调LLM还需要人类可读文本吗?DASA给出否定答案
arXiv新论文提出DASA方法,通过激活梯度反馈优化连续合成嵌入用于LLM微调,无需人类可读文本。在Llama和Qwen共6个模型上,性能追平并超越自然语言数据,较GRADMM提速3.6-4.9倍。