Java+AI实战:LangChain4j与Spring AI开发指南
面向Java开发者的AI应用转型路径:用LangChain4j或Spring AI把大模型工程化落地。
文章围绕「Java+AI」实战课程展开,指出大模型成本下降、消费级显卡即可本地部署,使企业私有化部署需求上升,AI应用开发成为Java开发者转型热门方向。核心内容是框架选型:LangChain4j 封装了 HTTP 调用与参数传递,简化 Java 集成大模型,内置支持 OpenAI、Ollama、Hugging Face 及多种向量数据库,且 DeepSeek 可直接沿用 OpenAI 标准调用;Spring AI 原生贴合 Spring 生态,适合单模型快速接入,LangChain4j 无框架依赖,更适合多模型动态切换的通用平台。文章建议开发者掌握 Spring AI/LangChain4j/Ollama 技术栈,并以高并发等工程能力形成差异化优势,最终通过本地知识库、智能客服等项目完成落地闭环。
大模型成本持续走低,一张消费级显卡就能搭建本地大模型,这让越来越多企业开始考虑私有化部署——毕竟只有本地跑模型,数据安全才真正握在自己手里。伴随这一趋势,AI应用开发工程师成为Java开发者转型的热门方向。B站这期实战课就围绕「Java+AI」展开,从模型选择、数据清洗、微调到结合LangChain4j(原文音译“蓝浅佛技”)或Spring AI开发智能客服、本地知识库系统,试图打通一条完整的落地路径。
为什么Java开发者要关注AI应用开发
传统Java开发者的技能栈集中在业务逻辑、高并发、高可用这些企业级工程能力上,而AI应用开发恰好需要把大模型能力“工程化”地接入现有系统。课程给出的转型建议很直接:简历上写上Spring AI、LangChain4j或Ollama这类技术栈,再配一个AI智能项目——比如用LangChain4j+Ollama接入本地大模型实现本地知识库系统,并突出Java的工程化优势,例如通过线程池扛住高并发问答请求。按讲师的说法,这样的组合“绝对能让你甩开90%的传统Java开发”。这个比例是课程中的原话,是否精确另说,但方向值得参考:企业缺的不是会调API的人,而是能把大模型稳定接进生产系统的人。
什么是 Ollama? Ollama 是一个开源的本地大模型运行与管理系统,提供一条命令即可下载、启动 Llama、Qwen、DeepSeek广告 等开源模型的命令行工具,并在本地暴露与 OpenAI 风格兼容的 HTTP 接口。它把模型量化、显存调度、GPU/CPU 推理等底层细节封装起来,让消费级显卡甚至纯 CPU 环境也能跑起小参数模型。对私有化部署而言,Ollama 意味着模型权重和推理过程都留在企业内网,数据不出域;对开发者而言,它能以极低成本获得一个可编程调用的“本地模型服务”,因此常与 LangChain4j 搭配组成文中所述的本地知识库方案。
LangChain4j:简化Java集成大模型的框架
不用LangChain4j这类框架,Java程序也能对接大模型,但需要自己用HTTP Client、OkHttp等远程通信框架手动请求模型地址,还要手动传入各种层级的参数。LangChain4j的价值在于上层封装,把调用过程简化,从而提升Java应用集成大模型的开发效率。
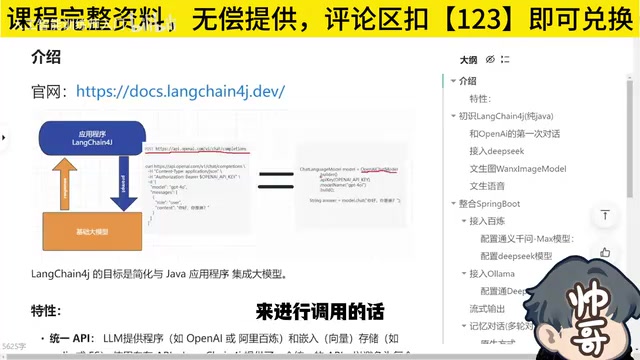
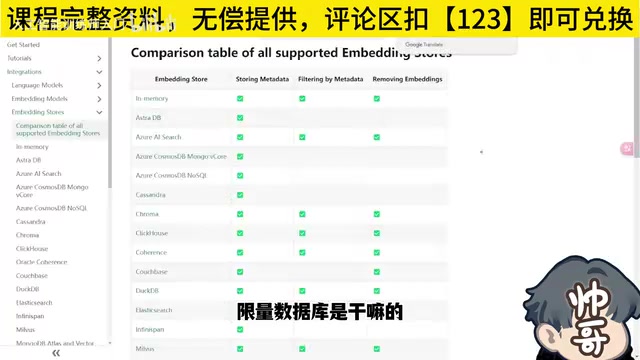
它并非支持所有大模型,需要查看内置支持列表。目前内置支持OpenAI、阿里、Hugging Face、Ollama等本地大模型,以及国内一些厂商。至于DeepSeek,讲师特别说明:它和OpenAI用的是同一套标准,用OpenAI的标准就能调用DeepSeek大模型,课程中也会演示。
向量数据库方面,LangChain4j支持ClickHouse、Elasticsearch、Neo4j、Oracle、Redis等Java技术栈中常见的组件。向量数据库的作用会在讲解RAG(检索增强生成)时详细展开,这里先建立印象即可。
什么是 LangChain4j? LangChain 是 Python 生态中用于构建大模型应用的开源框架,LangChain4j 是其面向 Java 的移植版本,API 设计贴合 Java 开发者习惯,同时提供对 Spring Boot 的可选集成模块。它的核心思想是把大模型应用的常见模式(Prompt 模板、对话记忆、工具函数调用、RAG 检索增强、Agent 编排)抽象成统一接口,开发者只需面向接口编程,底层换用 OpenAI、Ollama 或其他厂商模型时改动很小。对于熟悉面向对象设计的 Java 工程师,这种“组件化拼装”的思路比手写 HTTP 请求更符合既有工程习惯,也便于测试与替换。
什么是向量数据库? 向量数据库是专门存储和检索“向量”(一组浮点数)的数据库。在 AI 应用中,文本、图片等非结构化数据先经 Embedding 模型转换成向量,语义相近的内容在向量空间中距离也相近。用户提问时同样转成向量,数据库按相似度(如余弦距离)快速召回最相关的若干条内容,再交给大模型组织答案——这正是 RAG 的关键一环。传统关系型数据库擅长精确匹配,而向量数据库解决的是“语义近似查找”,因此常与 Elasticsearch、Redis、ClickHouse 等组件结合使用,文章提到的 LangChain4j 内置支持列表正是指这些可作为向量存储的后端。
Spring AI与LangChain4j怎么选
Java技术栈里另一个快速集成大模型的框架是Spring AI。两者最核心的区别在于生态依赖:Spring AI由Spring生态推出,原生支持Spring体系,可直接整合Spring或Spring Boot;LangChain4j没有框架依赖,只要是Java语言就能使用。
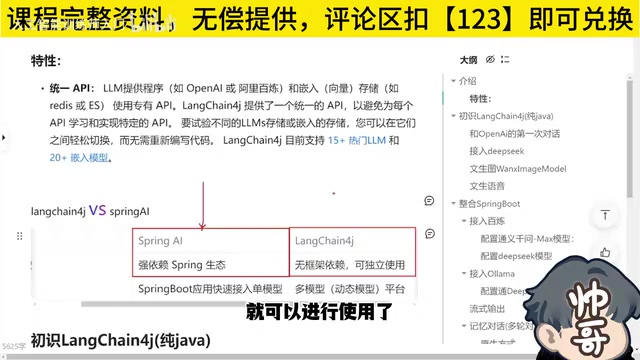
由此可以推导出应用场景的差异。Spring AI适合在Spring应用中快速接入单个模型,实现起来非常便捷;但如果需要多个模型动态切换、构建通用的大模型平台,LangChain4j更合适。课程举了一个开源项目为例——一个通用型多模型动态管理平台,可在系统中动态启用或禁用某一个大模型,这类场景用LangChain4j更顺手。两者各有优势,选型应基于实际场景,而不是简单比较谁更强。
从学习到落地:一条可复制的路径
课程规划的路径覆盖模型选择、数据清洗、微调,再到结合LangChain4j或Spring AI开发智能应用场景,最终完成智能客服或本地知识库系统的实战,形成“Java+AI应用工程师”的闭环。对Java开发者来说,这条路径的含金量在于它没有抛弃原有工程能力,而是把高并发、高可用这些企业级经验变成AI应用落地的差异化优势。需要视频资料和代码的读者,可按课程说明在评论区或私信领取。
需要提醒的是,本文基于公开视频内容整理,课程中的技术选型建议和效果描述带有讲师个人观点,实际落地时仍需结合团队技术栈和业务需求做验证。
什么是微调(Fine-tuning)? 微调是在一个已预训练好的大模型基础上,用特定领域的标注数据继续训练若干轮,使模型更贴合某类任务或行业语料。与 RAG 相比,二者定位不同:RAG 通过外挂知识库让模型“查资料”,知识更新只需改库,不改模型;微调则把知识或风格“写进”模型参数,推理时无需检索,但对数据质量要求高、成本更大,且知识更新需重新训练。实际工程中常见做法是先以 Prompt 工程与 RAG 起步,验证效果不足时再考虑微调,二者也可叠加使用。课程把数据清洗与微调列为路径环节,正是为了覆盖对回答风格和领域准确性要求更高的场景。
相关推荐
Gemini 4 Hydrogen 深度评测:高性价比之外的真实价值
基于 Artificial Analysis 选型数据与实测反馈,拆解 Gemini 4 Hydrogen 的性价比悖论:高分不等于高价值,自动化工作流与代码任务表现分化,定价与 Google 订阅包各算各的账,SynthID 输出标识可能成为一票否决项。
Gemini 4 Hydrogen 五大极限测试:96.7% 准确率与一键建站
YouTube 创作者对 Gemini 4 Hydrogen 进行五项极限测试:单提示词生成游戏、3D 太阳系模拟、30 分钟视频时间戳定位、287 页财报转交互仪表盘,以及抗幻觉测试中 96.7% 的准确率表现。
Gemini 4 Hydrogen发布:速度提升2.5倍的日常AI模型
Google发布Gemini 4 Hydrogen,宣称比Gemini 3.8 Flash快2.5倍,支持四级思考控制、百万token上下文和Orchestrator多模型协作,API定价每百万输入token 1.50美元。