#本地部署
共 459 篇相关文章

LM Studio是本地大模型最佳UI?实测优缺点
LM Studio 是本地大模型的可视化封装工具,基于 llama.cpp 和 MLXLM,支持 Mac 和 Linux。本文分析它的模型搜索亮点、非开源局限以及适合的用户群体。
Unsloth v0.1.916-beta发布:大型性能修复与双GPU加速
Unsloth v0.1.916-beta 发布大型性能修复:长聊天输入不再卡顿,SDXL 加载快 40%,双 NVIDIA GPU 图像视频生成提速约 1.5-1.8 倍,并新增每聊天独立浏览器与浮动浏览器窗口。

5分钟本地部署开源视频模型MiniMax H3,省下云端生成费
B站UP主实测开源视频模型MiniMax H3本地部署:ComfyUI三步安装、5分钟上手,无需写代码。同提示词下本地生成仅2分钟,线上排队加生成需4分钟,单条15秒720P视频省下约30元云端费用。附显存要求与RTX 5080实测表现。
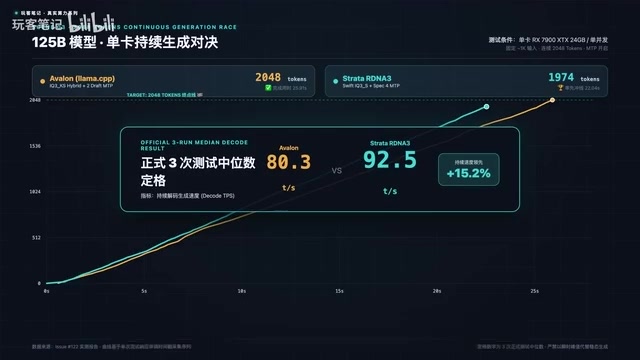
单卡7900XTX跑125B大模型:Avalon与Strata实测对决
单张24GB RX 7900XTX实测跑125B大模型:Avalon与Strata两套AMD优化推理引擎深度对决,Strata长文本预填充吞吐领先1.92倍、持续生成领先15.2%,但编程任务中Avalon反超。本文解析两种显存调度路线的差异与选型建议。

太阳能驱动Mac mini跑本地大模型:离网AI实操指南
用太阳能和Mac mini搭建离网本地大模型:详解Mac mini统一内存优势、150瓦与480瓦功耗差异、四块太阳能板加5千瓦时电池的全天候方案,以及多AI任务编排的实用思路。

DSH+Ollama本地部署大模型实战:免费对话大肥鱼
B站UP主实测DSH+Ollama本地部署大模型全流程:从Ollama安装、迅雷加速下载、魔搭GGUF模型导入,到DSH自定义API地址配置,并对比千问3.5 4B、8B、Gemma等模型在8G显存下的表现,给出本地部署与API调用的选择建议。

Qwen 3.8编程击败Opus,你的Mac能跑吗?
Qwen 3.8开源模型在编程测试中击败Opus 4.6,仅18GB大小,但你的Mac需要多少内存?实测显示24GB会崩溃,32GB才是甜点区,本文详解各档Mac配置的实际表现与上手方法。

本地跑大模型工具怎么选?五大主流方案一次讲清
一文讲清llama.cpp、Ollama、LM Studio、vLLM、MLX LM五大本地大模型运行工具的定位与差异:从GGUF格式、OpenAI兼容API到分页注意力与苹果统一内存,给出开发原型、普通用户和生产部署的选型建议。

OpenMausBot 接国产 DeepSeek 实测:零国外账号跑起 AI 机器人团队
GitHub 近 8000 星的 OpenMausBot 实测:在 Linux 上从零安装,接上国产 DeepSeek,十块钱跑起能动手干活的 AI 机器人团队,并整理端口冲突、SmartScreen 拦截等四个常见坑。

B站AI无限竞技场:三款MOE模型本地部署极限PK
B站AI无限竞技场实测:RTX 3060本地部署Gemma 4、GLM 4.7 Flash、Qwen 3.6 35B A3B三款MOE模型,通过雨夜便利店3D建模任务极限PK。Qwen 3.6一次成型表现最佳,GLM 4.7 Flash细节丰富但稳定性差,Gemma 4优化乏力垫底。附详细测试环境与过程分析。

零API费用!用Ollama在笔记本上搭建全离线RAG系统
开发者分享用Ollama在笔记本上搭建全离线RAG系统的实践,零API费用、数据隐私保护、减少幻觉。包含技术栈选择、复现步骤与社区反馈,适合对本地AI应用感兴趣的读者。

Trail:用决策模型实现精准本地智能家居控制
Trail 提出一种完全本地的智能家居控制框架,用分层类型化决策替代开放式命令生成,在 Trek-Robust 上达到 85.3% 准确率,多轮记忆任务解决率 75.6%,显著优于微调 Qwen3.5-4B 基线。
 科技前沿
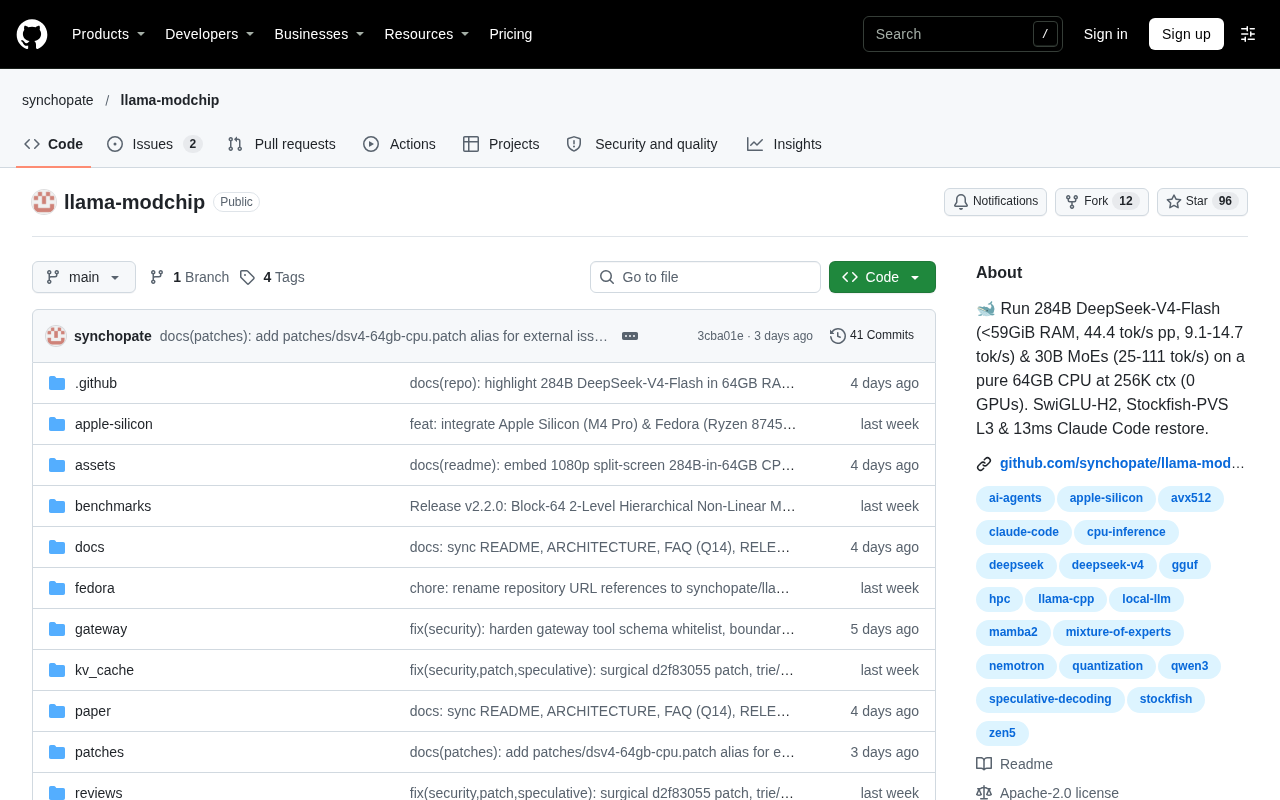
Llama-modchip:无GPU跑284B DeepSeek大模型
Llama-modchip项目宣称在64GB内存、无GPU的硬件上运行284B参数的DeepSeek大模型,本文分析其技术思路、无GPU推理的价值与局限,以及对本地部署开发者的启示。
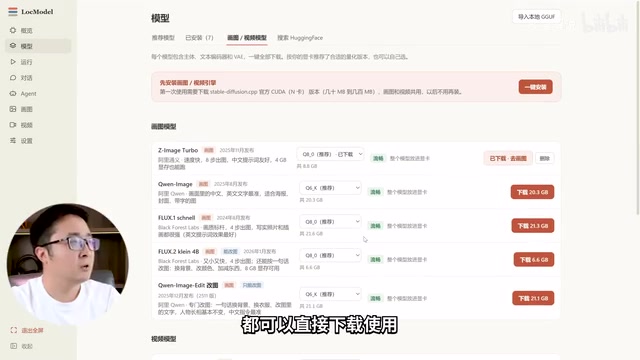
本地AI部署神器LocModel:一键玩转开源模型与AI生成
LocModel是一款本地AI部署工具,可自动适配硬件、一键下载开源模型,支持图片生成、视频生成、无审查大模型和Agent智能体,完全免费。本文基于实测视频介绍其安装与使用流程。

三块RTX 3090怎么装?本地AI玩家的硬件抉择
Reddit玩家分享三块RTX 3090的装机困境:72GB显存诱惑下,如何解决机箱、电源和主板限制?社区讨论开放式矿架、双电源与卖掉第三块卡的务实选择。

21GB显存本地跑大模型:Streeta+Cloud Studio实战
Streeta开源项目通过将内存放不下的模型部分卸载到SSD,让21GB显存的机器也能本地运行DeepSeek V4.1-Flash等大模型。本文整理B站教程:借助腾讯云Cloud Studio免费GPU,从搜索streethub模板到运行setup.sh脚本的完整流程,并分析实测token速度与适用场景。

10月开源AI狠活:本地部署Stable Diffusion视频模型,无限次生成AI短剧
10月开源AI狠活:手把手教你本地部署Stable Diffusion视频模型,2060显卡即可运行,不排队、无限次、无积分,用开源方案生成AI短剧,摆脱商业工具套壳收费。
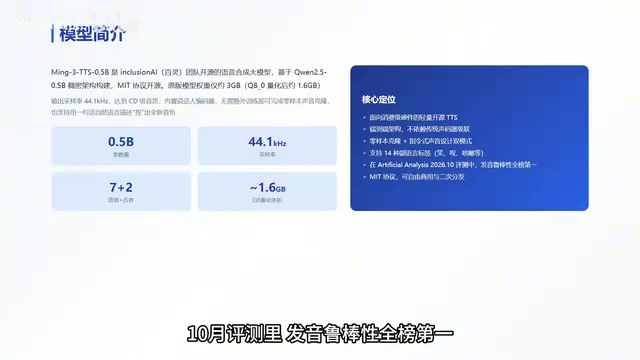
Ming-3-TTS-0.5B:2G显存本地跑声音克隆与设计,audio.cpp整合包实测
Ming-3-TTS-0.5B百灵开源TTS模型实测:0.5B参数支持零样本声音克隆与一句话声音设计,Q8量化约2G显存本地运行,audio.cpp整合包支持CPU与通用显卡,附API调用与官方测试数据解读。

一键部署MiniMax H3导演台:185个ComfyUI工作流整合包实测
B站UP主分享MiniMax H3全功能导演台整合包,含185个ComfyUI工作流与开源模型,总容量约700GB,支持零基础本地免费部署。本文梳理其核心构成、分卷解压报错排查与独立文件覆盖修复方法,并分析适用人群与硬盘占用代价。

Stable Diffusion特工版实测:2060显卡本地免费部署全攻略
Stable Diffusion特工版整合包实测:最低2060显卡即可本地免费部署,解压即用、全中文界面,内置488套工作流。本文整理完整安装步骤、模型迁移方法及路径规范等关键注意事项,帮新手避开常见坑。