#本地部署
共 459 篇相关文章
Ollama本地大模型部署避坑指南:从装好到用上只需几步
手把手讲解用 Ollama 部署本地大模型的完整流程:安装后如何修改 OLLAMA_MODELS 和 OLLAMA_HOST 环境变量避免占满系统盘并开放局域网算力,如何用 ollama run 拉取 DeepSeek、通义千问等模型,以及 list、ps、rm 三条常用管理命令和 Open WebUI 图形界面配置。

本地AI接入Home Assistant:隐私与风险并存的实践
基于 Smart Home Solver 的实践,详解如何用 MCP 将本地 AI 接入 Home Assistant,涵盖官方与社区工具差异、云端与本地模型表现对比、安全风险与时间成本,给出隐私优先的智能家居 AI 落地建议。
 科技前沿
本地AI客服血泪教训:一个模糊工具描述让退款翻三倍
Reddit开发者用Ollama+LangChain构建本地AI客服代理,因一个模糊的退款工具描述导致3条测试消息触发3笔错误退款。本文分析工具描述为何是AI Agent的行为契约,以及如何通过精确描述避免业务事故。
离线AI编程代理实战:在喜马拉雅用OpenCode+Ollama+Qwen写代码
开发者用OpenCode、Ollama和Qwen在喜马拉雅山区搭建离线AI编程代理,无需网络即可写代码。本文解析三件套的分工、搭建关键节点、真实能力边界,以及哪些开发者适合采用本地编程代理方案。
Dify本地部署实战:Docker+Ollama搭建企业智能体
基于B站课程内容,梳理Dify本地部署的完整路径:用Docker拉起服务、用Ollama部署本地大模型,覆盖工作流设计、变量管理、大语言节点配置与RAG技术,并对比云端与本地两条模型接入路线,适合想搭建企业智能体的开发者入门。

RAGFlow本地部署与RAG实战全指南
基于B站教程大纲整理RAGFlow完整学习路径:Linux虚拟机与Docker本地部署、知识库搭建、聊天与搜索功能、Agent工作流节点、Ollama本地模型接入、网页嵌入及HTTP/Python API调用,并说明MCP支持的特殊之处。
Windows本地部署OpenClaw并接入飞书教程:零基础搭建AI智能体
OpenClaw是能接管键鼠权限的AI智能体,本文介绍Windows本地部署OpenClaw并接入飞书的完整思路,解析它与传统大模型的区别、核心能力与部署风险,零基础也能上手搭建本地AI项目。

8GB显存跑Qwen 3.8 Flash Next:实测900 t/s
Reddit用户实测:8GB显存+32GB内存,借助Strata框架把Qwen 3.8 Flash Next跑出最高900+ t/s提示处理和30+ t/s生成速度,并给出关键参数与质量对比。
IBM CEO力挺开源权重模型:本地部署既好用又便宜
IBM CEO 表示开源权重模型已足够好用且便宜,适合企业本地部署。本文分析这一表态背后的成本结构变化、数据主权考量,以及对企业 AI 选型的实际影响。
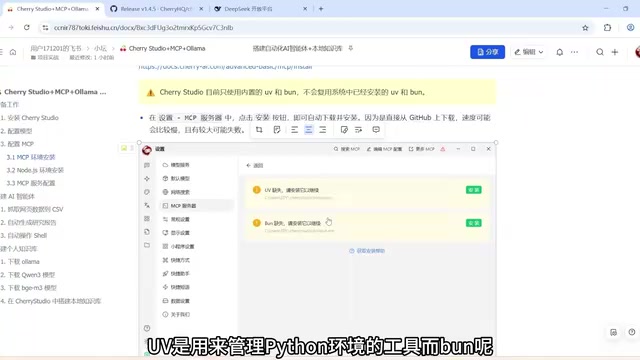
Cherry Studio+MCP搭建自动化AI智能体与本地知识库实战
基于B站实战教程,详解用Cherry Studio配置MCP服务器、接入DeepSeek V3实现文件读写与网页抓取自动化,并用Ollama本地部署通义千问3与bge-m3搭建私有知识库,含环境安装与模型选择的避坑要点。
Laya AI模型本地部署实测:35毫秒决策的智能体利器
Laya AI是一款非自回归决策模型,单次推理仅35毫秒,支持CPU/GPU本地运行。本文基于B站教程,详解Laya AI的安装步骤、客服路由代码实战与性能实测,并分析其在机器人、智能体等场景的适用性。
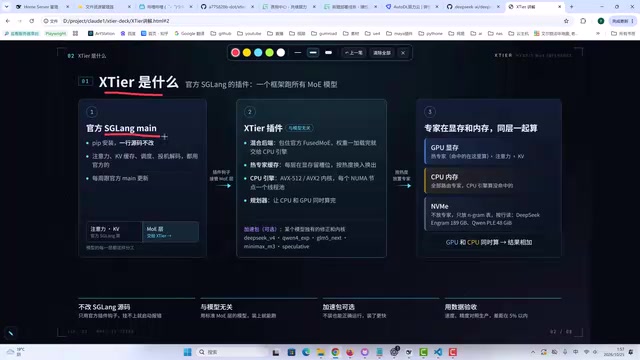
Xtier插件+SGLang官方版:显存内存混合推理MoE模型实战
B站UP主羊仔开源Xtier插件,基于SGLang官方版实现MoE模型显存内存混合推理,支持加速包可选。本文梳理其设计思路、安装流程,并实测MiniMax M3.1 Flash的速度与前端能力表现。
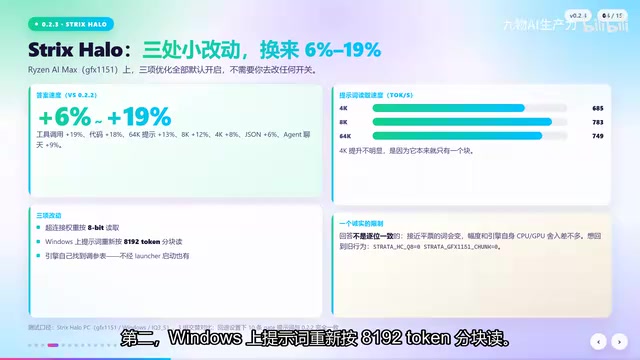
18小时三连发:Strata让12GB显卡跑起DeepSeek V4.1 Flash
Strata 项目 18 小时连发 0.2.3、0.2.3.1、0.2.4 三个版本,通过内存当显存、跳过冗余计算与投机解码,让 12GB 显卡加 46GB 内存跑起 DeepSeek V4.1 Flash。本文拆解三版节奏、量化选择、实际速度与升级建议。
Flint模型本地部署:Ollama运行与Claude Code接入指南
Recursive的Flint是一个40B参数、2.5B激活参数的开源编程模型。本文介绍如何在Ollama上本地运行Flint,并将其接入Claude Code终端助手,同时分析基准测试的局限性和实际使用注意事项。
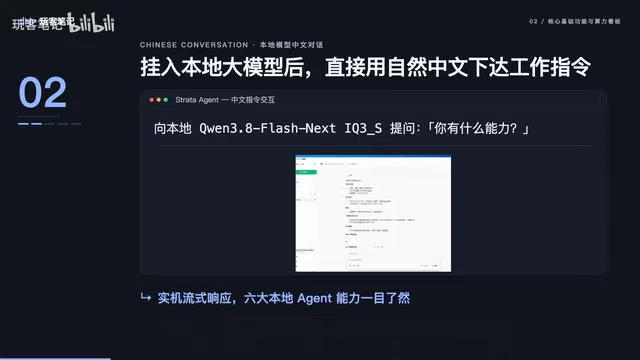
本地AI太难装?这款中文Windows软件开箱即用
一款基于Stratav开源项目的中文Windows本地AI桌面软件,739MB免管理员权限安装,自动检测硬件推荐量化模型,内置国内镜像下载源,支持中文对话、文件操作与PowerShell调用。

别抽卡了!用本地大模型写HTML做视频,安全可控
B站UP主分享用本地大模型写单文件HTML、录屏做视频的完整玩法:精确控制每一帧,断网可用,商业数据不出本地。附四个高频坑位与对应提示词解法。

141份实测揭秘:你的显卡跑大模型到底有多快?
基于141份真实提交,覆盖45种显卡,揭示本地跑大模型的真实速度:显存而非内存决定性能,RTX 4090性价比最高,双卡仅1.22-1.81倍提升。42张卡速度表帮你对号入座。

816B参数只拿39分?开源大模型参数竞赛的性价比真相
Meta 816B Muse Spark Open 在 Artificial Analysis 仅得39分,180B Qwen3.8-Flash-Next 却拿到40分。本文解析11个开源权重模型的参数与分数关系,探讨激活参数、量化体积与部署成本的真实影响。

