#本地部署
共 242 篇相关文章
Ollama+Cline本地部署Qwen3编码模型全教程
本教程详解如何用Ollama、VSCode与Cline在本地免费部署Qwen3编码大模型,涵盖硬件选型、模型下载、Context设置及MCP集成,实现无限制、高隐私的本地AI编程。
LM Studio vs Ollama:本地AI运行器怎么选?
LM Studio 和 Ollama 是两大主流本地AI运行工具。本文从界面、性能、开发者集成、模型发现等维度对比二者差异,帮你根据新手或开发者需求选择合适的本地大模型运行方案。
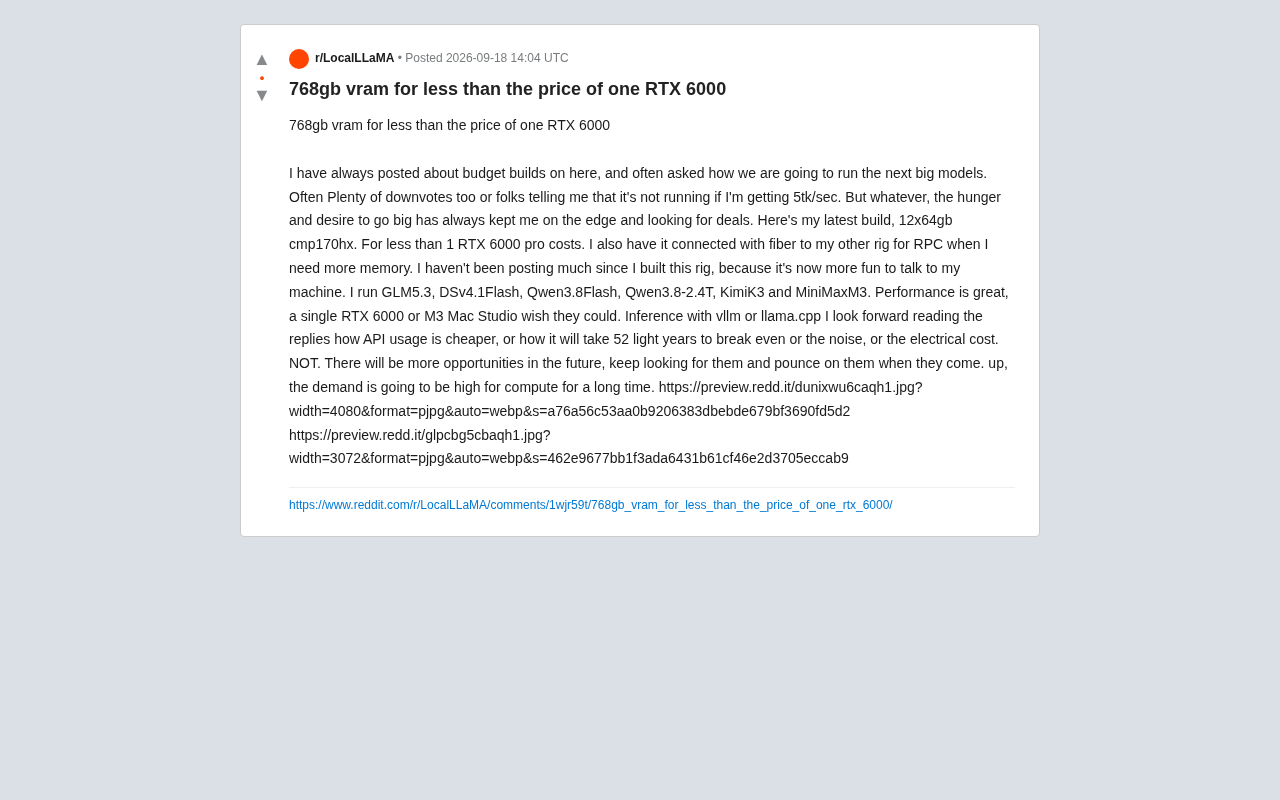
768GB显存低于单张RTX 6000:多卡拼装本地大模型实录
一位极客用12张CMP170HX矿卡拼出768GB显存,成本低于单张RTX 6000 Pro,可本地运行GLM、Qwen、DeepSeek等主流大模型。本文解析这套多卡方案的配置、性能与本地部署的成本争议。
1.9TB内存能跑什么大模型?聊聊本地部署的算力天花板
一位Reddit用户获得1.9TB内存访问权限并计划运行大模型。本文从本地大模型部署角度,分析海量内存对运行超大参数模型的意义、内存推理的性能局限以及本地AI部署的现实门槛。
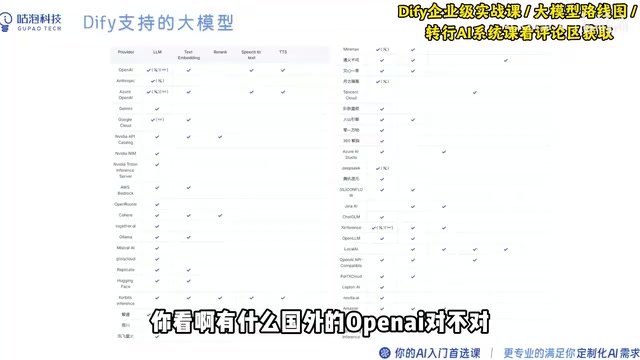
Dify本地部署全流程:从虚拟机到智能体搭建实操指南
Dify 本地部署完整教程,涵盖 VMware 虚拟机搭建、Ubuntu 22.04 系统安装、宝塔面板配置、Docker 部署 Dify 全流程,并附常见网络与镜像拉取故障的排查方法,帮助 AI 应用开发初学者快速跑通第一个 LLM 平台。
27B稠密模型登顶HF:16G显存跑出前沿级能力
一个27B稠密模型登顶Hugging Face历史点赞榜,量化后16G显存即可本地部署,一张4090就能跑出前沿级Agentic能力。本文拆解其智能密度路线、跑分表现与本地部署的真实取舍。
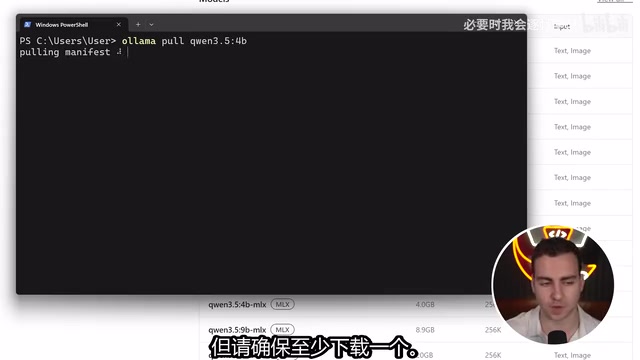
10分钟用Python搭建本地AI代理:Ollama+PydanticAI实战
一篇基于B站教程的实操指南,教你用Python、Ollama和PydanticAI在10分钟内搭建完全本地运行的AI代理。涵盖模型选择、连接推理服务器、挂载工具函数和构建对话循环全流程。
免费本地部署谷歌Gemma模型:数据零上传的隐私AI方案
手把手教你用LM Studio免费本地部署谷歌开源模型Gemma,全程离线、数据不出本机。涵盖模型下载、QAT量化、上下文窗口讲解,以及分析机密PDF、生成网页、读图解读化验单三大实战案例。
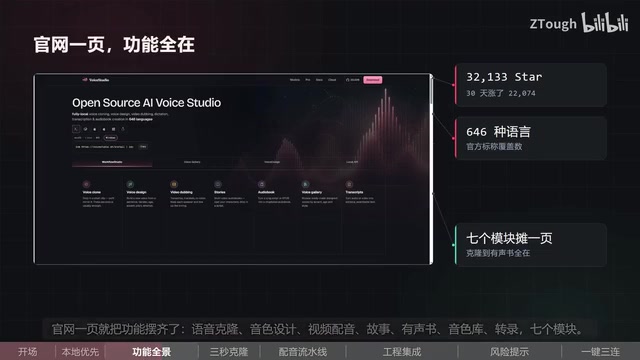
OmniVoice Studio:3秒克隆声音的全本地开源语音工作室
OmniVoice Studio 是一款全本地运行的开源语音工作室,3秒即可克隆声音、免API Key、支持646种语言,集成语音克隆、视频配音、有声书等七大模块,30天狂揽2.2万Star。本文详解其功能、配音流水线与硬件限制。
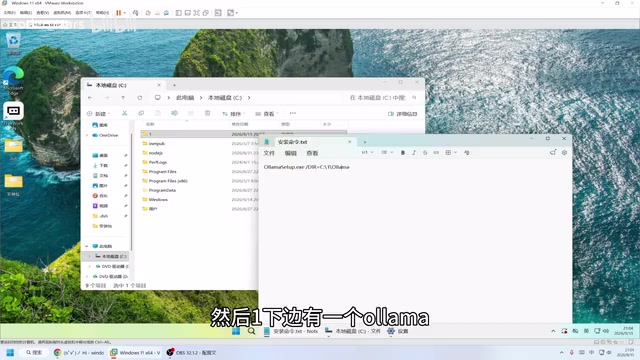
Ollama 换盘安装指南:告别默认C盘占用
Ollama 默认安装到 C 盘怎么办?本文详解通过命令行参数指定安装路径、配置环境变量实现命令全局调用,以及用 where 命令定位软件安装位置的完整方法,适用于 Windows 10/11。
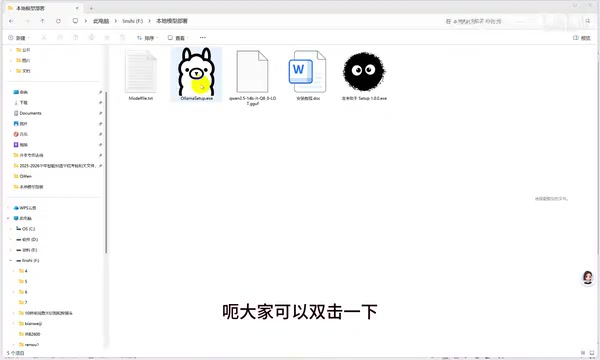
本地部署大模型完全教程:Ollama+Qwen 隐私免费方案
手把手教你在本地免费部署大模型:通过 Ollama 运行引擎加载 Qwen 通义千问开源模型,搭配图形客户端实现类豆包体验,数据不外泄、零费用,附完整安装步骤与硬件建议。
警惕AI教程套路:本地大模型部署的真相与误区
网络流传的"GPT-6本地免费使用教程"暗藏套路。本文拆解其命名造假、性能夸大等硬伤,并说明本地部署开源大模型的真实可行路径与风险防范。
警惕"GPT-6免费使用"骗局:本地部署AI的真相
网传《GPT-6 Astra国内免费使用教程》宣称旧电脑也能跑满血AI,本文从产品事实与技术常识拆解其中漏洞,揭示"免费大模型"引流套路,并给出理性本地部署AI的正确方式。
本地部署AI大模型:轻薄本也能跑的可行性分析
针对网络流传的“轻薄本本地部署满血AI”教程,本文从量化技术、模型规模、安全风险等角度理性分析其可行性与陷阱,并给出正规的本地大模型部署建议。
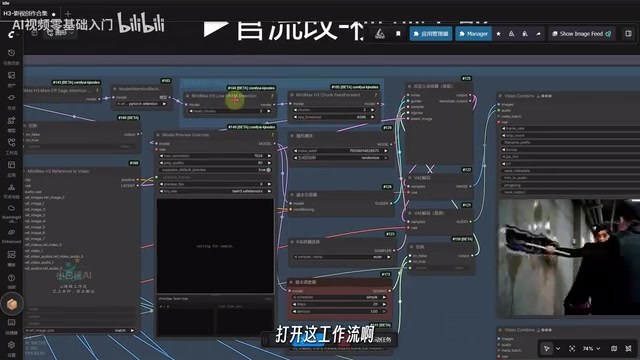
16GB显存跑27B大模型:Qwen3与MiniMax H3本地视频生成实测
实测16GB显存跑27B开源大模型:结合Qwen3与MiniMax H3的ComfyUI工作流集合,涵盖文生图、图像编辑与视频生成,8GB显存起步即可本地部署,媲美付费闭源方案。
MiniMax开源视频模型本地部署:8G显存也能跑,速度惊人
MiniMax最新开源AI视频加速模型支持8G显存本地运行,生成速度极快。本文详解ComfyUI本地部署流程、模型文件存放路径、五种工作流选择及文生视频、图生视频实测效果。
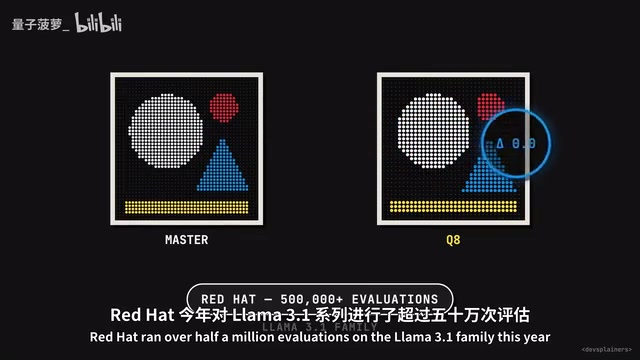
本地大模型变笨了?揭开Q4量化陷阱与自测指南
本地大模型跑起来变笨?问题可能出在你从未主动选择的Q4量化版本。本文解析量化陷阱、KV cache影响与运行器差异,并给出五分钟自测指南,帮你分清是量化还是模型本身的问题。
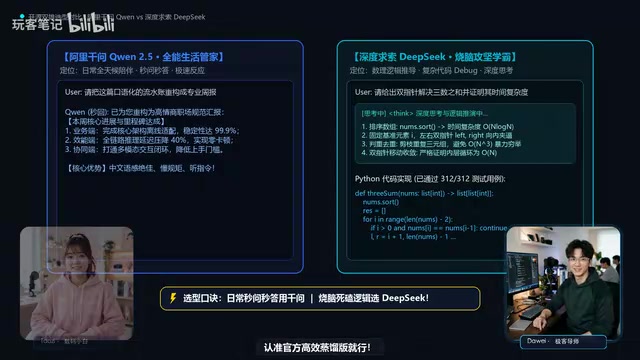
本地大模型选型指南:Qwen与DeepSeek怎么选?
本地大模型选型极简指南:Qwen与DeepSeek如何选择、7B/14B参数与Q4量化含义、按显存对号入座下载合适尺寸,以及LM Studio、Cherry Studio等零代码部署工具推荐,助你断网也能流畅跑本地AI。
本地部署Qwen3 27B实测:单张5090能跑出什么效果?
开发者用单张RTX 5090本地运行Qwen3 27B模型,通过Row-Bot框架仅凭一条提示词生成了包含8个场景、105秒的交互式动画,涵盖实时数学、分形计算、物理沙盒等。实测揭示本地中型模型的真实能力与Agent框架的关键作用。
Qwen 3.8 27B本地大模型实测:小体积如何逼近顶级闭源模型
Qwen 3.8 27B开源模型实测:仅17GB即可在家用硬件本地运行,在部分基准挑战Opus 4.6 Max等顶级模型。本文结合发票生成、待办应用两组实测与Hacker News社区反馈,剖析其惊艳输出与过度思考的短板。