#本地部署
共 242 篇相关文章
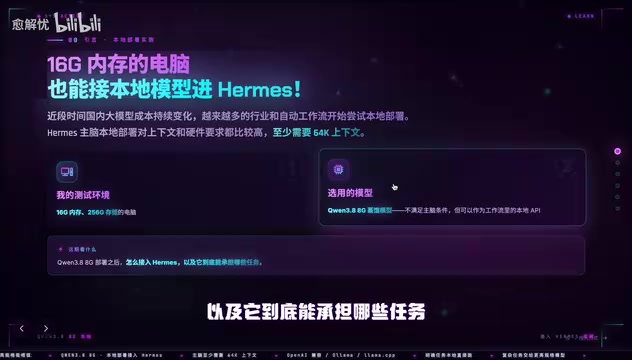
Hermes接入Qwen3-8B本地部署:低配电脑也能跑自动化工作流
在16G内存电脑上部署Qwen3-8B蒸馏模型并接入Hermes自动化工作流的实测记录。详解OpenAI兼容接口、Ollama、llama.cpp三种接入方式,以及低配设备下主脑调度加本地执行的分工模式。
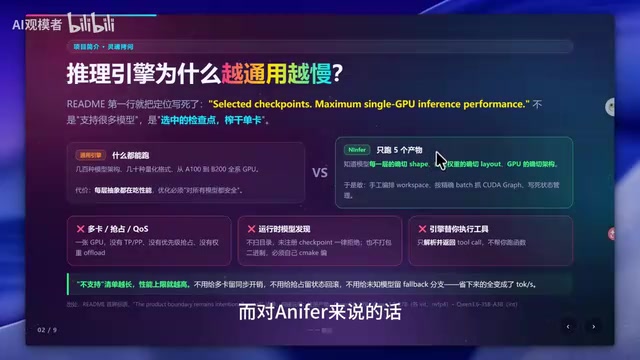
Anifer开源推理引擎实测:单卡5090狂飙150 token/s
开源推理引擎 Anifer 用 C++/CUDA 深度优化,单张 RTX 5090 上 Qwen3.8 27B 单并发实测稳定 144~150 token/s,8 并发官方跑分冲到 1147 token/s。本文解析它为何比 vLLM、llama.cpp 更快及实测数据。
本地部署私人DeepSeek全攻略:联网+知识库+隐私安全
手把手教你用Ollama、Chatbox、AnythingLLM搭建纯本地、可联网、带知识库的私人DeepSeek。涵盖蒸馏版模型选择、RAG知识库原理与API调用,隐私安全零门槛部署全流程干货。
DeepSeek v4.1 Flash本地部署真相:23秒才吐一个token
DeepSeek v4.1 Flash以MIT许可证和顶尖基准成绩引发本地部署热潮,但实测每token需23秒、510GB存储、1.9万美元集群四年才回本。本文拆解MoE架构下「选择性计算不等于选择性存储」的真相,帮你算清本地部署的真实成本。
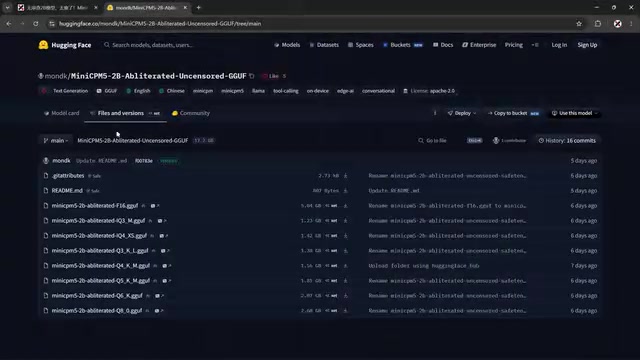
MiniCPM-2B无审查版本地部署教程:接入llama.cpp与Hermes全流程
MiniCPM-2B 本地部署完整教程:涵盖 GGUF 模型下载、llama.cpp 配置、启动脚本编写及接入 Hermes 客户端全流程。支持 131K 上下文,普通电脑即可运行的国产轻量级大模型部署指南。
4千美元淘到全新DGX Spark:本地部署大模型的性价比之选
一位Reddit用户以4000美元在Craigslist淘到全新DGX Spark,用于本地托管AI模型。本文解析这笔交易背后的性价比、二手交易安全,以及本地部署大模型的兴起趋势。
Voodoo Dynamic Quant开源:用梯度下降优化模型量化
开发者开源动态量化方法 Voodoo Dynamic Quant,采用 MIT 协议。它用梯度下降优化 GGUF 模型的逐张量量化布局,在激进低比特档位优于 Unsloth Dynamic 3.0,为低显存本地部署提供新工具。
Portable Computer登陆Windows:RTX GPU本地跑A…
Portable Computer登陆Windows:RTX GPU本地跑AI Agent
Portable Computer现已支持搭载NVIDIA RTX GPU的Windows PC,可在本地运行AI harness、agents和模型,无需上传云端即可处理本地文件与连接应用,并在需要时调用前沿云端模型。
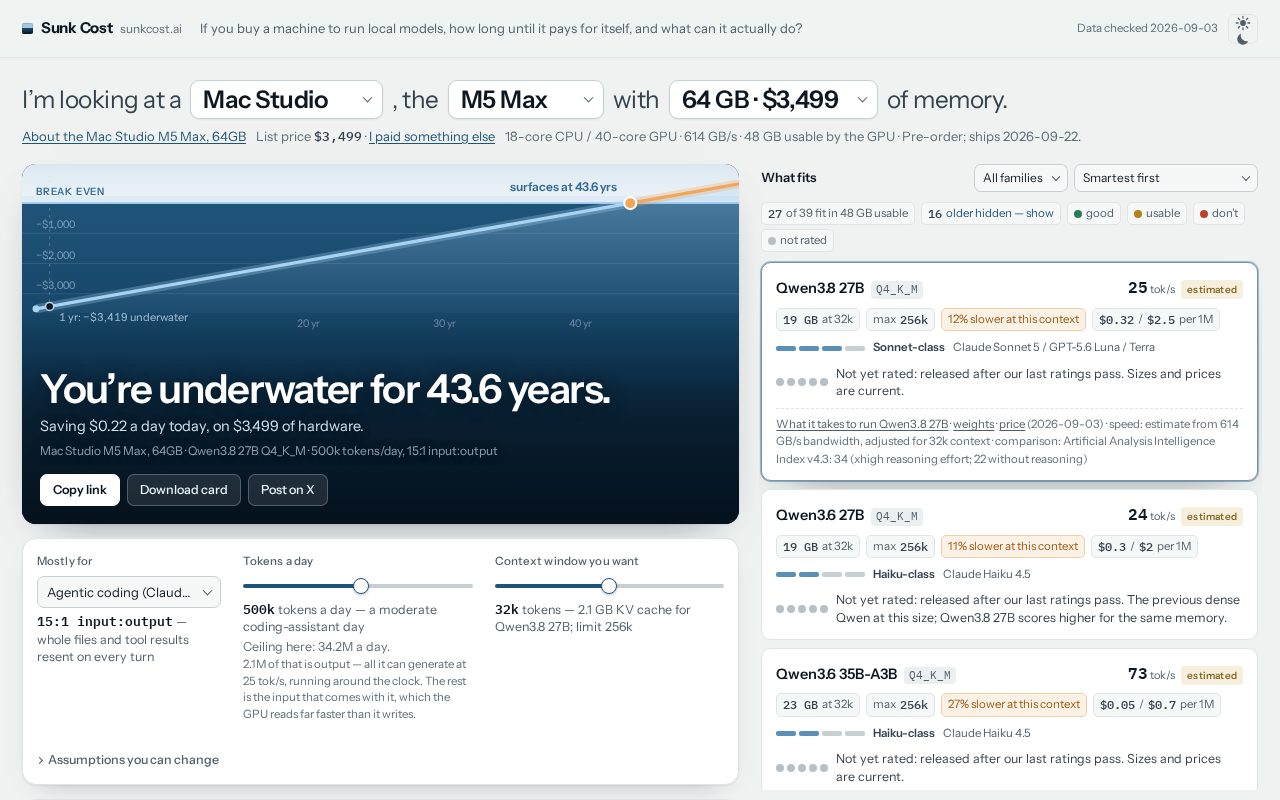
本地LLM硬件多久回本?Sunk Cost工具帮你算清这笔账
本地LLM硬件多久能回本?Hacker News热门工具Sunk Cost帮你量化自建大模型设备与云端API的成本对比,深入分析回本周期的关键变量与隐性因素。
K2 Horizon 7B:小体量模型跑出中量级智能水平
K2 Horizon 7B 在 Artificial Analysis 智能指数上排名介于 Qwen 3.6 27B 与 35BA3b 之间,用 70 亿参数逼近数倍体量模型的表现,成为本地部署用户的高性价比选择。
从Opus迁移到自托管Ollama:35KB长提示词的踩坑笔记
从Anthropic Opus迁移35KB长提示词到自托管Ollama的实战踩坑笔记:上下文窗口截断、模型能力差异、提示模板兼容性等关键问题及迁移检查清单。
智能权:守护本地运行AI的自由
Reddit社区发起"智能权"倡议,呼吁保护个人在本地运行AI的权利。在AI安全监管升级的背景下,开源模型可能成为牺牲品,本文剖析本地AI为何关乎隐私、自主与技术民主化。
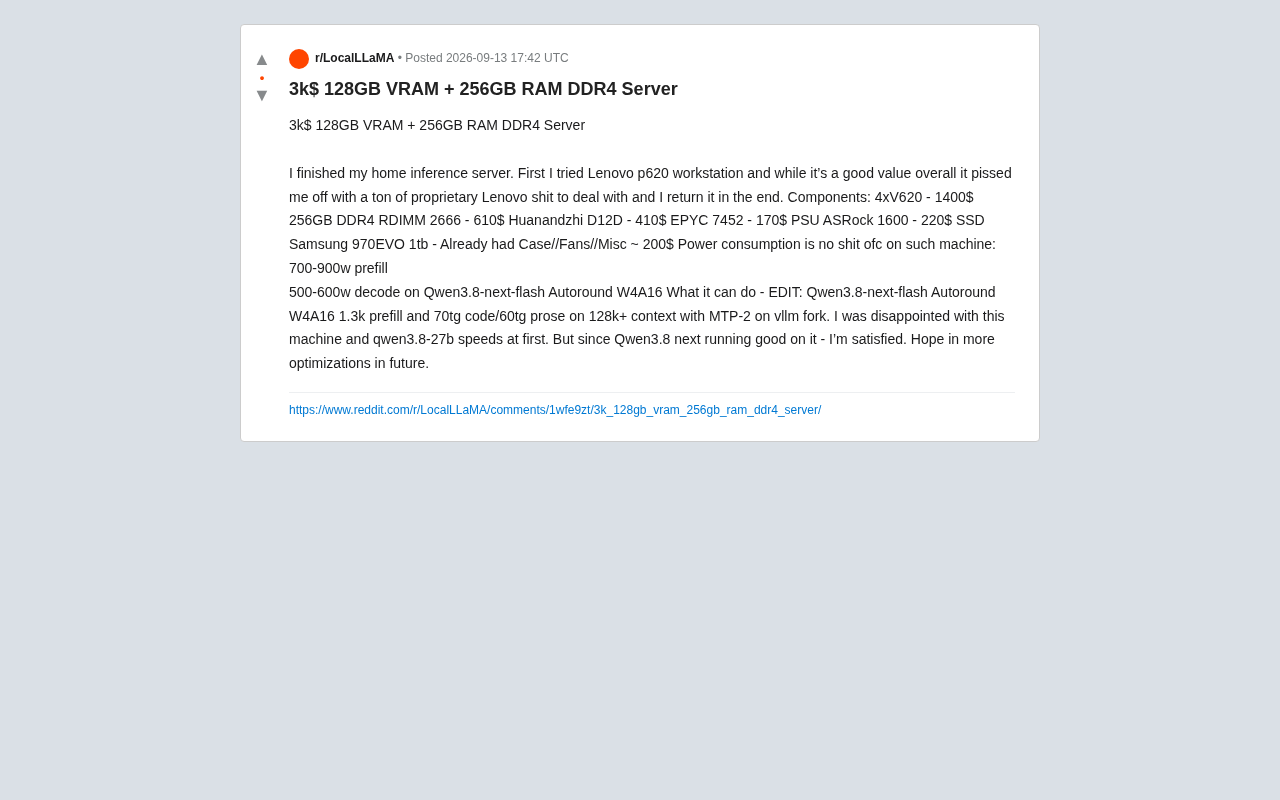
3000美元自建128GB显存AI推理服务器实测
一位Reddit用户用约3000美元自建128GB显存、256GB内存的本地AI推理服务器,采用4张V620显卡加EPYC平台,实测运行Qwen3-Next-Flash可达70 tokens/s。本文拆解硬件清单、功耗与性能表现。
本地大模型幻觉检测实战:从1.5B到120B的低显存方案
如何在不额外消耗大量显存的前提下检测本地大模型的幻觉?本文基于1.5B到120B模型的实测经验,解析置信度、自洽性、轻量校验等低开销检测思路,为本地LLM部署者提供实用参考。
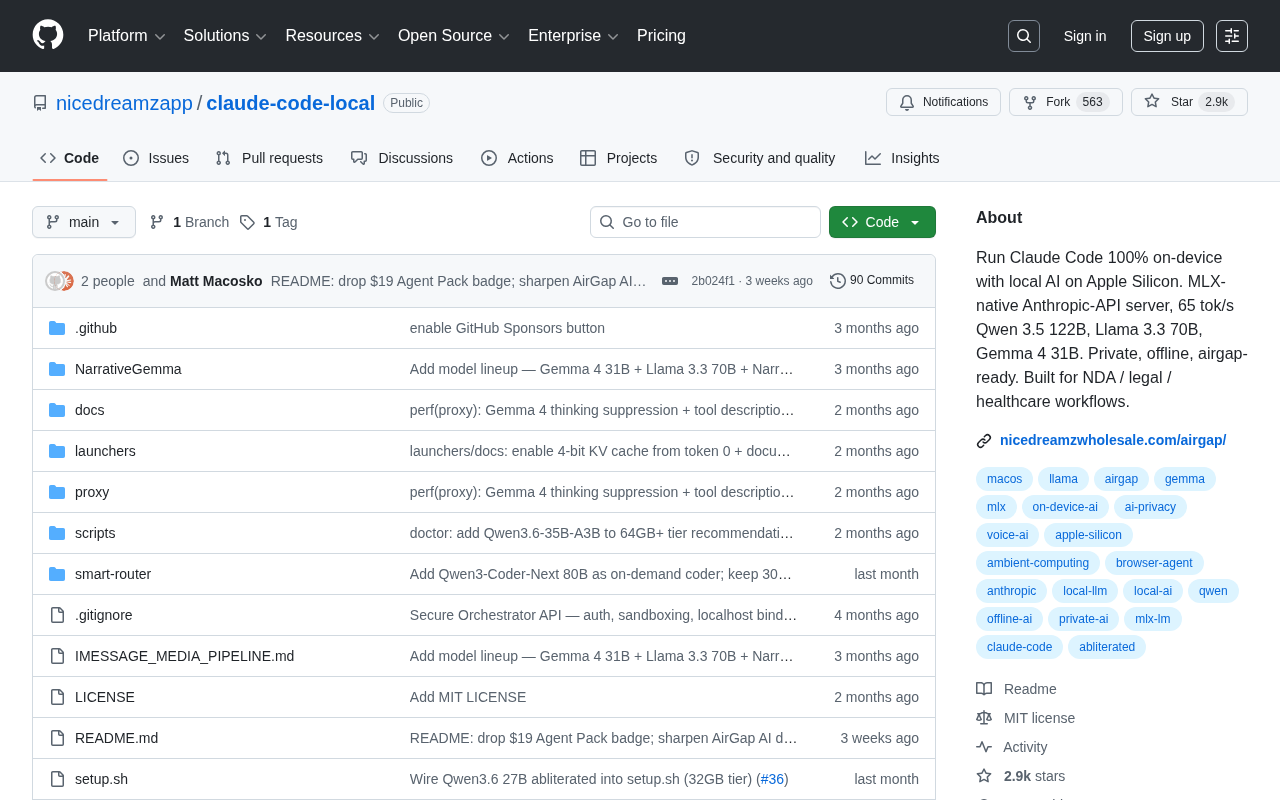
Claude Code 本地化运行:Apple Silicon 上的全离线 AI 编程方案
开源项目 claude-code-local 让 Claude Code 100% 本地离线运行于 Apple Silicon,基于 MLX 支持 Qwen 3.5 122B 等模型,65 tok/s 推理速度,专为 NDA、法律、医疗等隐私敏感工作流打造。
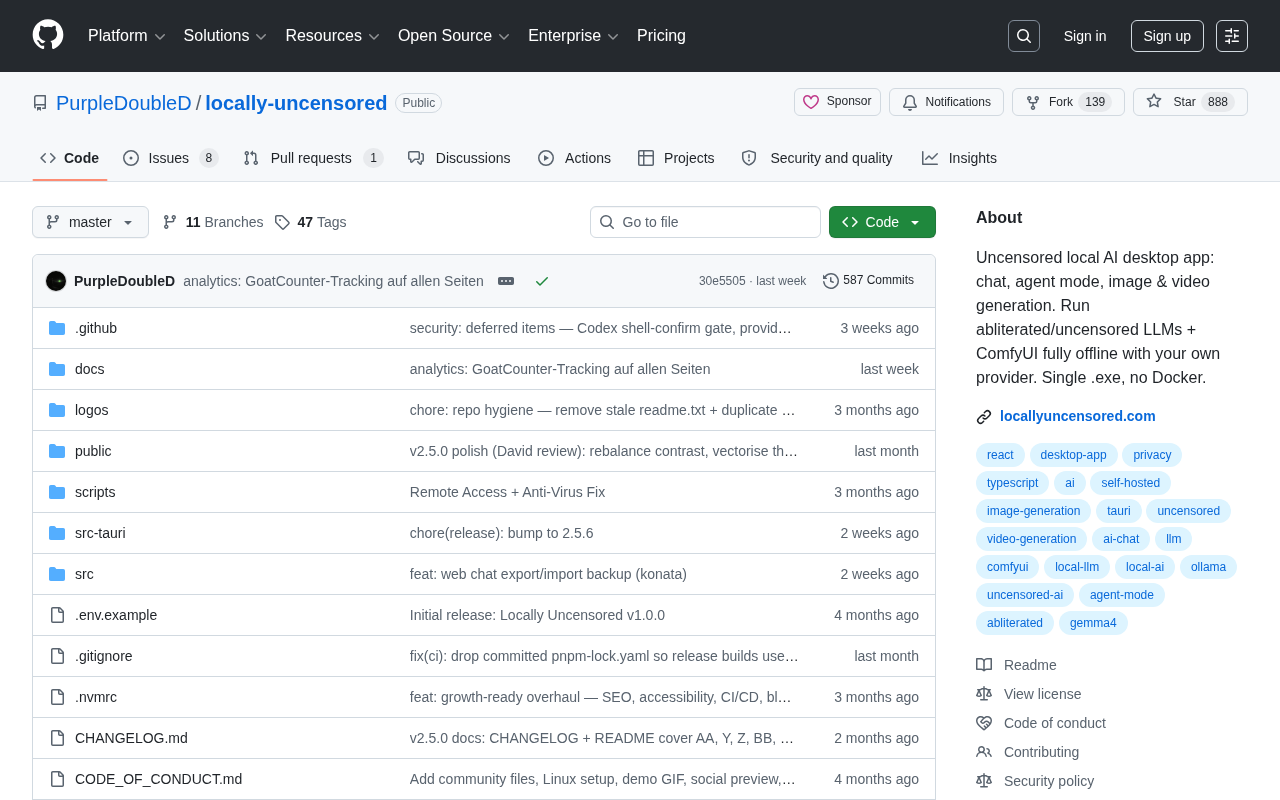
locally-uncensored:一键运行的本地AI桌面应用
locally-uncensored 是一款本地 AI 桌面应用,集成聊天、Agent 模式、图像与视频生成,支持 Ollama、Gemma、Llama、Qwen 及 OpenAI、Anthropic,单 exe 运行无需 Docker。

DeepSeek v4.1 Flash在M1 Mac Mini上:23秒/token的现实
有人在2020年16GB M1 Mac Mini上运行DeepSeek v4.1 Flash,每个token耗时约23秒。本文分析这一现象背后的内存瓶颈与算力限制,并给出在旧Mac上本地部署大模型的实用建议。
 教程攻略
Hermes Agent本地部署教程:自进化AI助手安装与配置
详细介绍Hermes Agent本地部署完整流程,涵盖Windows环境下WSL2安装、Git配置、DeepSeek模型接入等步骤,帮助你快速搭建具备自学习能力的开源AI Agent助手。

