#产品体验
共 13337 篇相关文章
Holiday Extras员工把AI助手当“狗”养:Brian与Beast的真实工作日常
Holiday Extras员工将AI助手命名为Beast,每天早晚对话、提前准备会议数据、监控任务进展。本文还原一个真实用户如何把AI嵌入日常工作流,并给出低门槛启动建议。

Gemini 4 Neon评测:跑分比肩Carbon,API定价与额度解析
Google Gemini 4 Neon正式上线,跑分紧咬Carbon,API定价3/15为Hydrogen两倍。本文汇总B站UP主实测:Neon可平替90% Carbon场景,AntiGravity中额度消耗仅为Carbon三分之一,并解析订阅渠道限制与2API封号风险。

Gemini 4 Helium或将至?Google订阅限制松绑信号
Google团队成员预告发布将继续,社区推测Gemini 4 Helium(Flash Lite)或成下一款模型;订阅封禁争议获回应,产品负责人以「Soon」暗示可能开放限制。本文梳理Gemini动向、OpenAI Coding Agent与风险管理、豆包实时音视频API及算力商业动态。

AI辅助React开发实战:视频应用优化与错误处理
14年经验开发者演示如何用AI辅助优化React视频应用:通过ImageKit将视频从80MB压缩至5MB(约94%),并实现可靠的错误处理与重试机制。包含与AI协作的规划、代码理解和验证方法。

Claude Mythos 5.2 与 Fable 5.2 错误率异常升高
Claude Mythos 5.2 和 Claude Fable 5.2 出现请求错误率异常升高,官方状态页已标记为调查中。本文梳理事件概况、对开发者的实际影响及应对建议。

AI Agent vs LLM:Cursor和Claude Code如何真正工作
深入解析AI Agent与LLM的本质区别:LLM生成代码建议,Agent则通过工具调用修改文件、运行测试。以Spring Boot Bug修复为例,拆解Cursor和Claude Code的工作流、权限控制与验证机制。
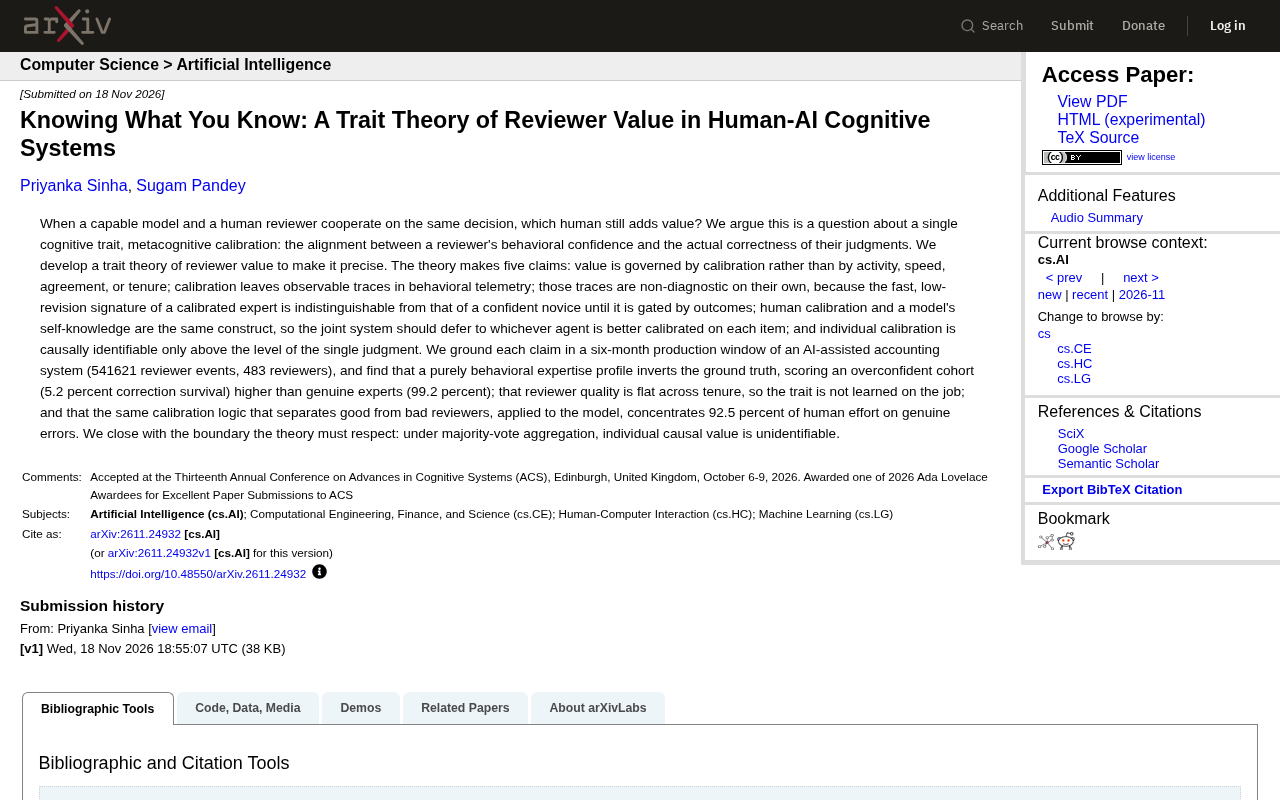
元认知校准:人机协同中人类审查者的真正价值
一项基于AI辅助会计系统生产数据的研究提出审查者价值特质理论:人类审查者的核心价值在于元认知校准而非活跃度或资历,纯行为画像会颠倒专家与过度自信者,校准逻辑亦可反用于模型以集中人类努力于真实错误。
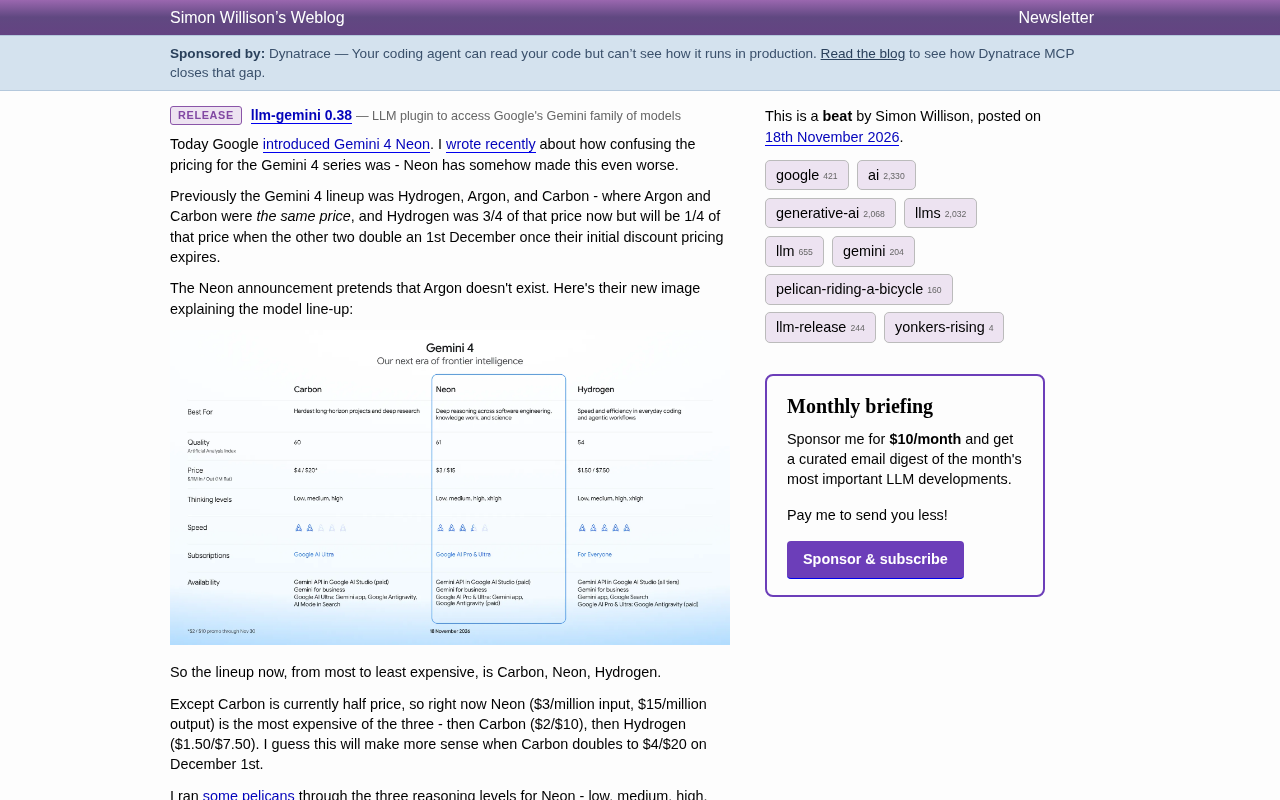
Gemini 4 Neon发布:定价更乱,但推理更强
Google发布Gemini 4 Neon模型,llm-gemini同步更新至0.38。新模型在推理质量上超越Carbon,但Gemini 4系列定价因限时折扣和Argon消失而更加混乱。本文解析三款模型的定位、价格与实测表现。

FailTrace:用URL本地复现GitHub Actions失败
FailTrace 是一个开发者工具,只需提供失败的 GitHub Actions 运行 URL,即可在本地复现执行环境,简化 CI 失败调试流程。本文分析其核心功能、技术挑战与生态位。

Claude Code v2.1.328 更新:Bedrock 自动模式与多项稳定性修复
Claude Code v2.1.328 更新详解:为 Bedrock 等平台增加自动模式,增强自托管运行器控制与指标,修复 Code Mode 和终端交互多项问题,提升稳定性。

ADE Index:收录975款智能体编程工具的可溯源排名索引
ADE Index 在 Hacker News 发布,收录 975 款智能体编程工具并提供可溯源排名,帮助开发者从海量 AI 编程工具中快速筛选候选。本文解析其设计思路、价值与局限。
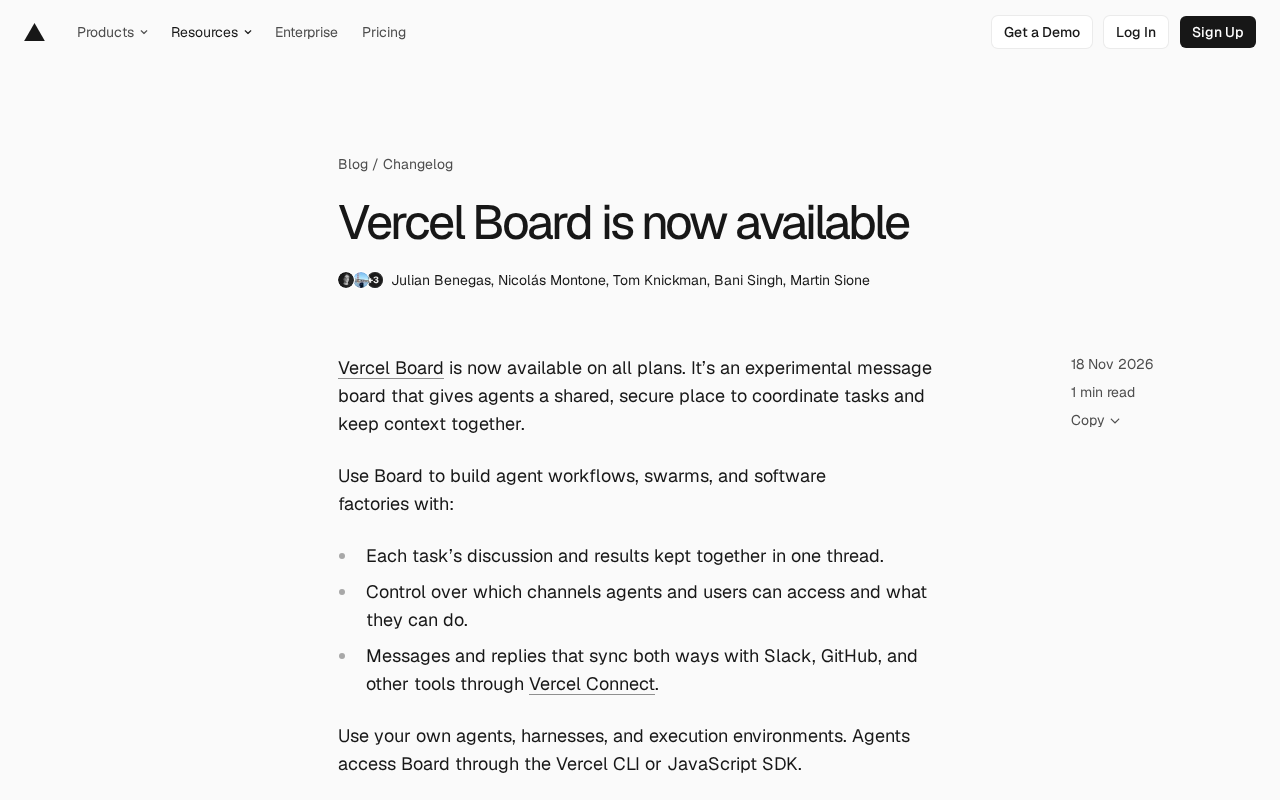
Vercel推出Board:AI代理协作消息板实验
Vercel推出实验性消息板Vercel Board,为AI代理提供共享协作空间。支持任务线程、频道权限控制,并与Slack、GitHub双向同步,可通过CLI或JS SDK接入。

谷歌Gemini 4 Hydrogen发布:提速2.5倍,轻量模型智能不缩水
谷歌发布Gemini 4 Hydrogen轻量模型,任务提速2.5倍,AA智能指数54分反超大哥,Agent Arena单步7.3秒快于Claude和GPT竞品,四档思考级别按需付费,AI Studio等渠道全面开放。
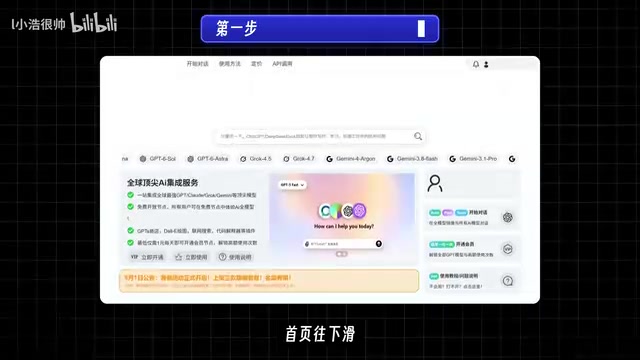
GPT-6 Astra免费使用教程?多模型聚合站实测
B站UP主声称找到免注册、零门槛使用GPT-6 Astra及Claude、Gemini、Grok的全模型镜像站。本文拆解其技术原理、演示效果与隐私风险,帮你判断这类免费聚合服务是否值得使用。

冻结大模型+双投影头:医疗选择题的System 1快速推理新基线
研究在MedMCQA上复现System 1医疗选择题决策模型:冻结Qwen3等编码器,仅训练两个投影头,最佳准确率达46.0%,定位为廉价快速基线而非Med-PaLM竞争者。

Safe Personal RSI:给个人智能体更新加上安全闸门
解读 Safe Personal RSI:Kicker 个人健康助手的提示词更新评估与修复流程,29 个案例基准、三类安全探针,以及 GPT-5.6 Luna 与 Qwen 模型上的修复效果与运行时缺口。
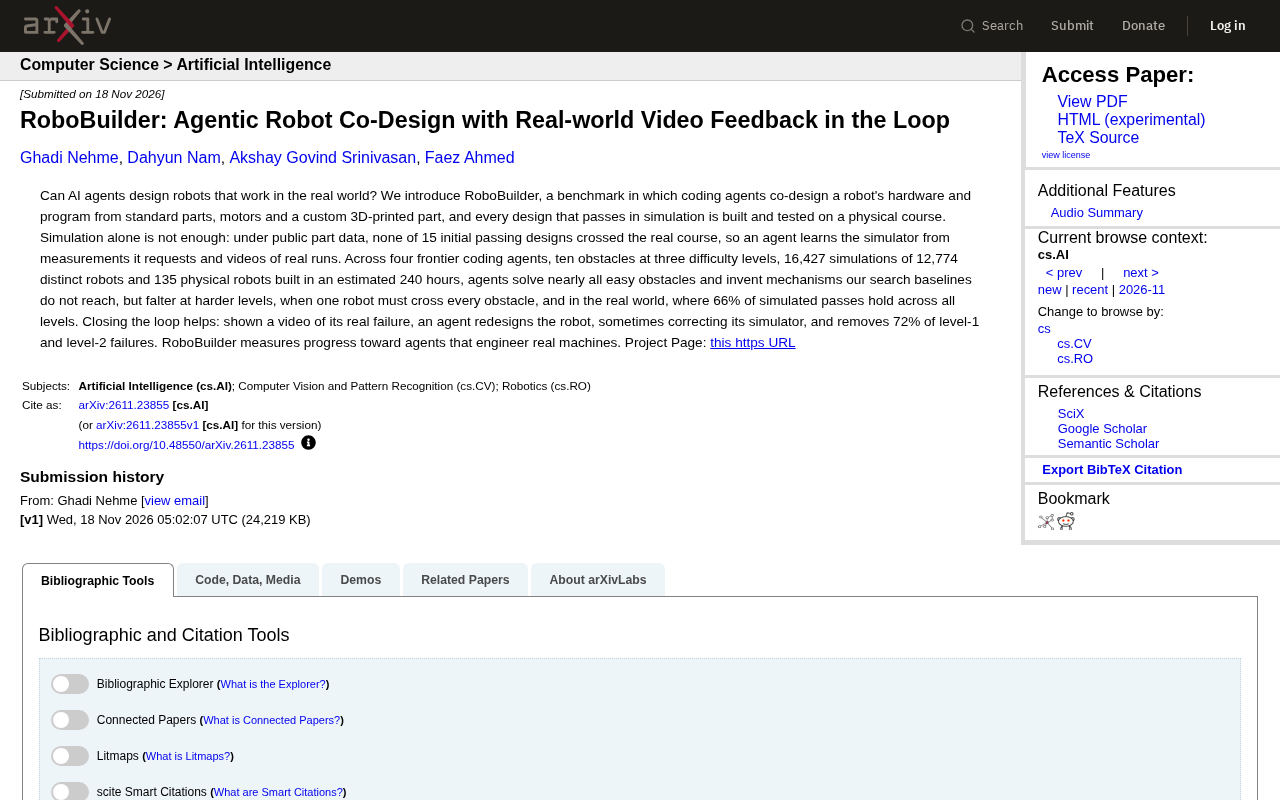
RoboBuilder:AI智能体如何跨越仿真到现实的机器人设计鸿沟
RoboBuilder基准测试让AI智能体协同设计机器人硬件与程序,并在真实赛道验证。实验揭示仿真与现实的差距:仅66%的仿真通过设计在现实中成立,而视频反馈闭环能消除72%的失败案例。
Runway办公室幕后:AI视频公司的创意文化与技术基因
Runway ML 罕见公开办公室幕后,展示电影、艺术、科学与机器人融合的创意空间。本文解读其团队文化、工作方式及对AI视频行业的启示。

Nutrient 数据提取 API:按模式输出 JSON 并附引用与置信度
Nutrient 数据提取 API 可将 PDF、扫描件和 Office 文件解析为匹配自定义 schema 的 JSON,每个字段附带页码、区域和匹配标签引用及置信度,并提供 Studio 环境供团队在写代码前测试提取效果。
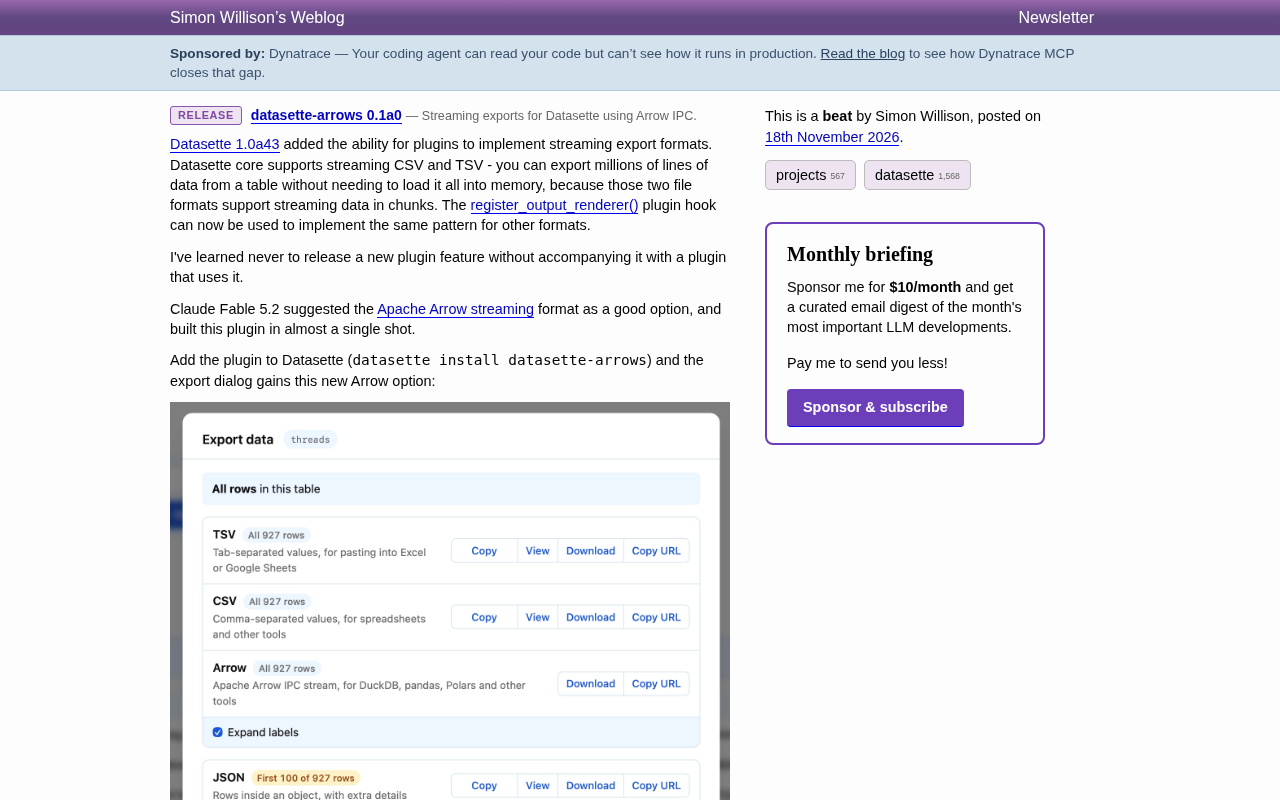
Datasette 流式导出新插件 datasette-arrows 发布
Datasette 发布 datasette-arrows 0.1a0 插件,基于 1.0a43 新增的流式导出钩子,为 Datasette 增加 Apache Arrow IPC 流格式导出,可直接对接 DuckDB、pandas、Polars 等分析工具。