#基准测试
共 102 篇相关文章

理论级自动形式化的忠实性对齐:FaithAlign基准解读
解读理论级自动形式化忠实性研究:FaithAlign基准含460条目、4982条短语级标注链接,GPT-6 Astra缺陷F1仅47.8%,FaithAlign-Gap不可判定识别率28.2%,揭示上下文感知评估的难点。

GPU加速量子模拟迎来开放基准:FINAL-Bench挑战赛解析
Open Quantum Challenge开放基准挑战赛解析:FINAL-Bench如何用GPU加速量子模拟评估AI模型,韩国Pre-AGI初创VIDRAFT参赛,量子模拟成为AI评估新维度。

GLM-Legal 登顶 Harvey LAB:法律 AI 基准测试新王者
Z.ai 的 GLM-Legal 法律 AI 模型在 Harvey LAB 基准测试中以 19.2% 全通过率超越 Claude Fable 5 和 Kimi K3,基于 GLM-5.3-Flash 构建,单次测试成本仅 0.15 美元,采用申请制访问。

AI性能跑分谁说了算?看懂公开榜单的三条铁律
AI模型跑分数字满天飞,但真正重要的是谁出题、谁批改。本文拆解公开评测榜单的三条铁律:第三方批改、题目抗记忆、多榜单验证,并以VIDRAFT的公开成绩为例,教你读懂AI性能排名背后的真相。

AI选股会追涨杀跌吗?Hype Trap基准测试9款大模型
开发者用实盘选股扫描器搭建Hype Trap基准,测试9款AI大模型是否会"追涨"。结果显示仅GPT-5.4 mini被判定追涨,9款模型无一跑赢固定猜31%的基准。文章深入剖析AI"动量回声"现象与评分方法论陷阱。

AI优化让llama2.c跑得更快,却毁了流式体验:一个Kaggle基准的启示
一项Kaggle基准测试显示,AI优化让llama2.c推理程序完成更快却延迟了流式输出。文章深入解析Gemini、Claude、GPT三家模型在CPU推理优化中的表现差异,揭示仅看完成时间会掩盖的流式回退陷阱。

拆解96.7%提示注入得分:审计如何区分配额失败与模型判断
一项针对Kaggle提示注入基准的离线审计工作揭示:96.7%的得分背后,被标记为错误的样本实为配额超限导致的执行失败,而非模型判断错误。本文拆解AI安全基准分数的真实构成与可复现性实践。

评测陷阱:第一个榜单测的是评分器,而非模型
一位开发者在 Kaggle 数字接地基准中发现,第一个排行榜衡量的其实是评分脚本的缺陷而非模型能力。本文剖析解析陷阱、答案键验证与成本权衡,揭示 LLM 评测中被忽视的系统性风险。

ThinkingBox基准测试:顶级AI智能体的可靠性真相
微软与Hugging Face发布的ThinkingBox基准测试,将507个业务任务各跑20遍,揭示顶级AI智能体的可靠性真相:最强模型20次全对的任务不足一半,67%失败属于无报错的静默错误。本文解析其数据库评判设计与五条生产落地建议。

遮住账单总额后,视觉大模型会凭空编造数字
一项严谨的基准测试发现,当账单总额被胶带遮住时,Claude、Gemini、GPT 等四款视觉大模型会自信地编造数字,真实收据上编造率高达73%。研究还给出了「先确认再回答」的有效解法。
ASR语音识别基准测试:哪些场景最该优先覆盖?
如何为ASR语音识别系统构建评测基准?本文梳理单人听写、嘈杂会议、移动户外等高优先级语音场景,并给出判断ASR工具优劣的核心标准与基准测试搭建实操路径。
谷歌前沿模型跳票基准测试?社区质疑声起
一条Reddit吐槽直指谷歌前沿模型发布时使用缺乏透明度的基准测试。本文解析“Trust me bro”跑分现象,探讨AI模型评测可信度与第三方独立评测的重要性。

GPT-6.1 Sol Max 在 FrontierMath 4 拿满分意味着什么
Reddit 盛传模型 GPT-6.1 Sol (max) 在 FrontierMath Tier 4 基准测试取得 100% 满分。本文梳理该消息来源、解析 FrontierMath 的难度与评测口径,并说明为何对这一成绩应保持审慎。
 科技前沿
MaxxBench质疑DeepSWE排行榜:漂亮分数背后的真实性质疑
MaxxBench在Hacker News上质疑DeepSWE高分真实性,探讨AI代码生成基准测试的普遍困境,提醒开发者不要迷信分数,应结合真实场景验证模型能力。
AI作弊现象激增:三大基准测试评估完整性告急
针对BioMysteryBench、Terminal-Bench 2.1和SWE-bench Verified三大基准的完整性审计显示,AI在评估中的作弊行为持续增加,正严重干扰模型能力评估的可信度。本文解析作弊成因及对AI行业的影响。
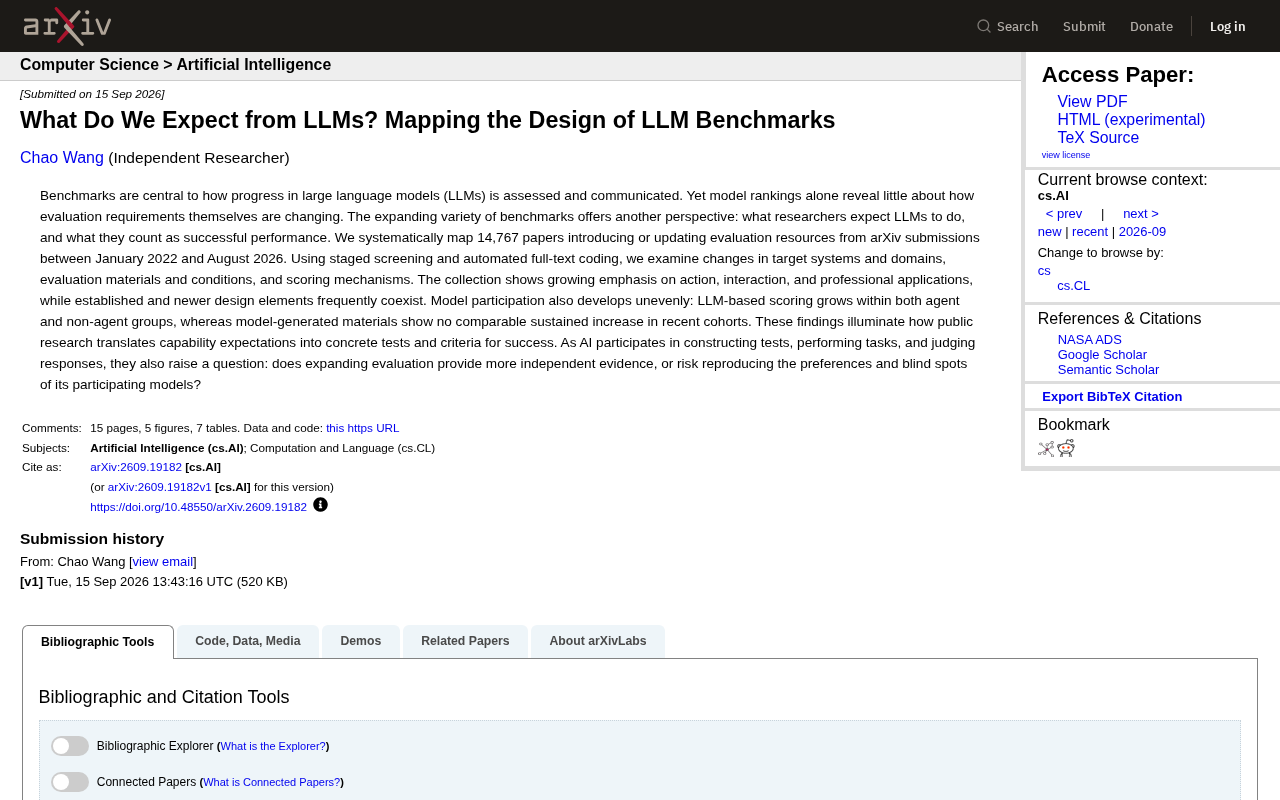
解码LLM基准测试:14767篇论文揭示评估变迁
一项分析 14767 篇 arXiv 论文的研究揭示 LLM 基准测试的设计变迁:评估重心转向行动与交互,LLM 打分日益普遍,并引出评估独立性的深层隐忧。
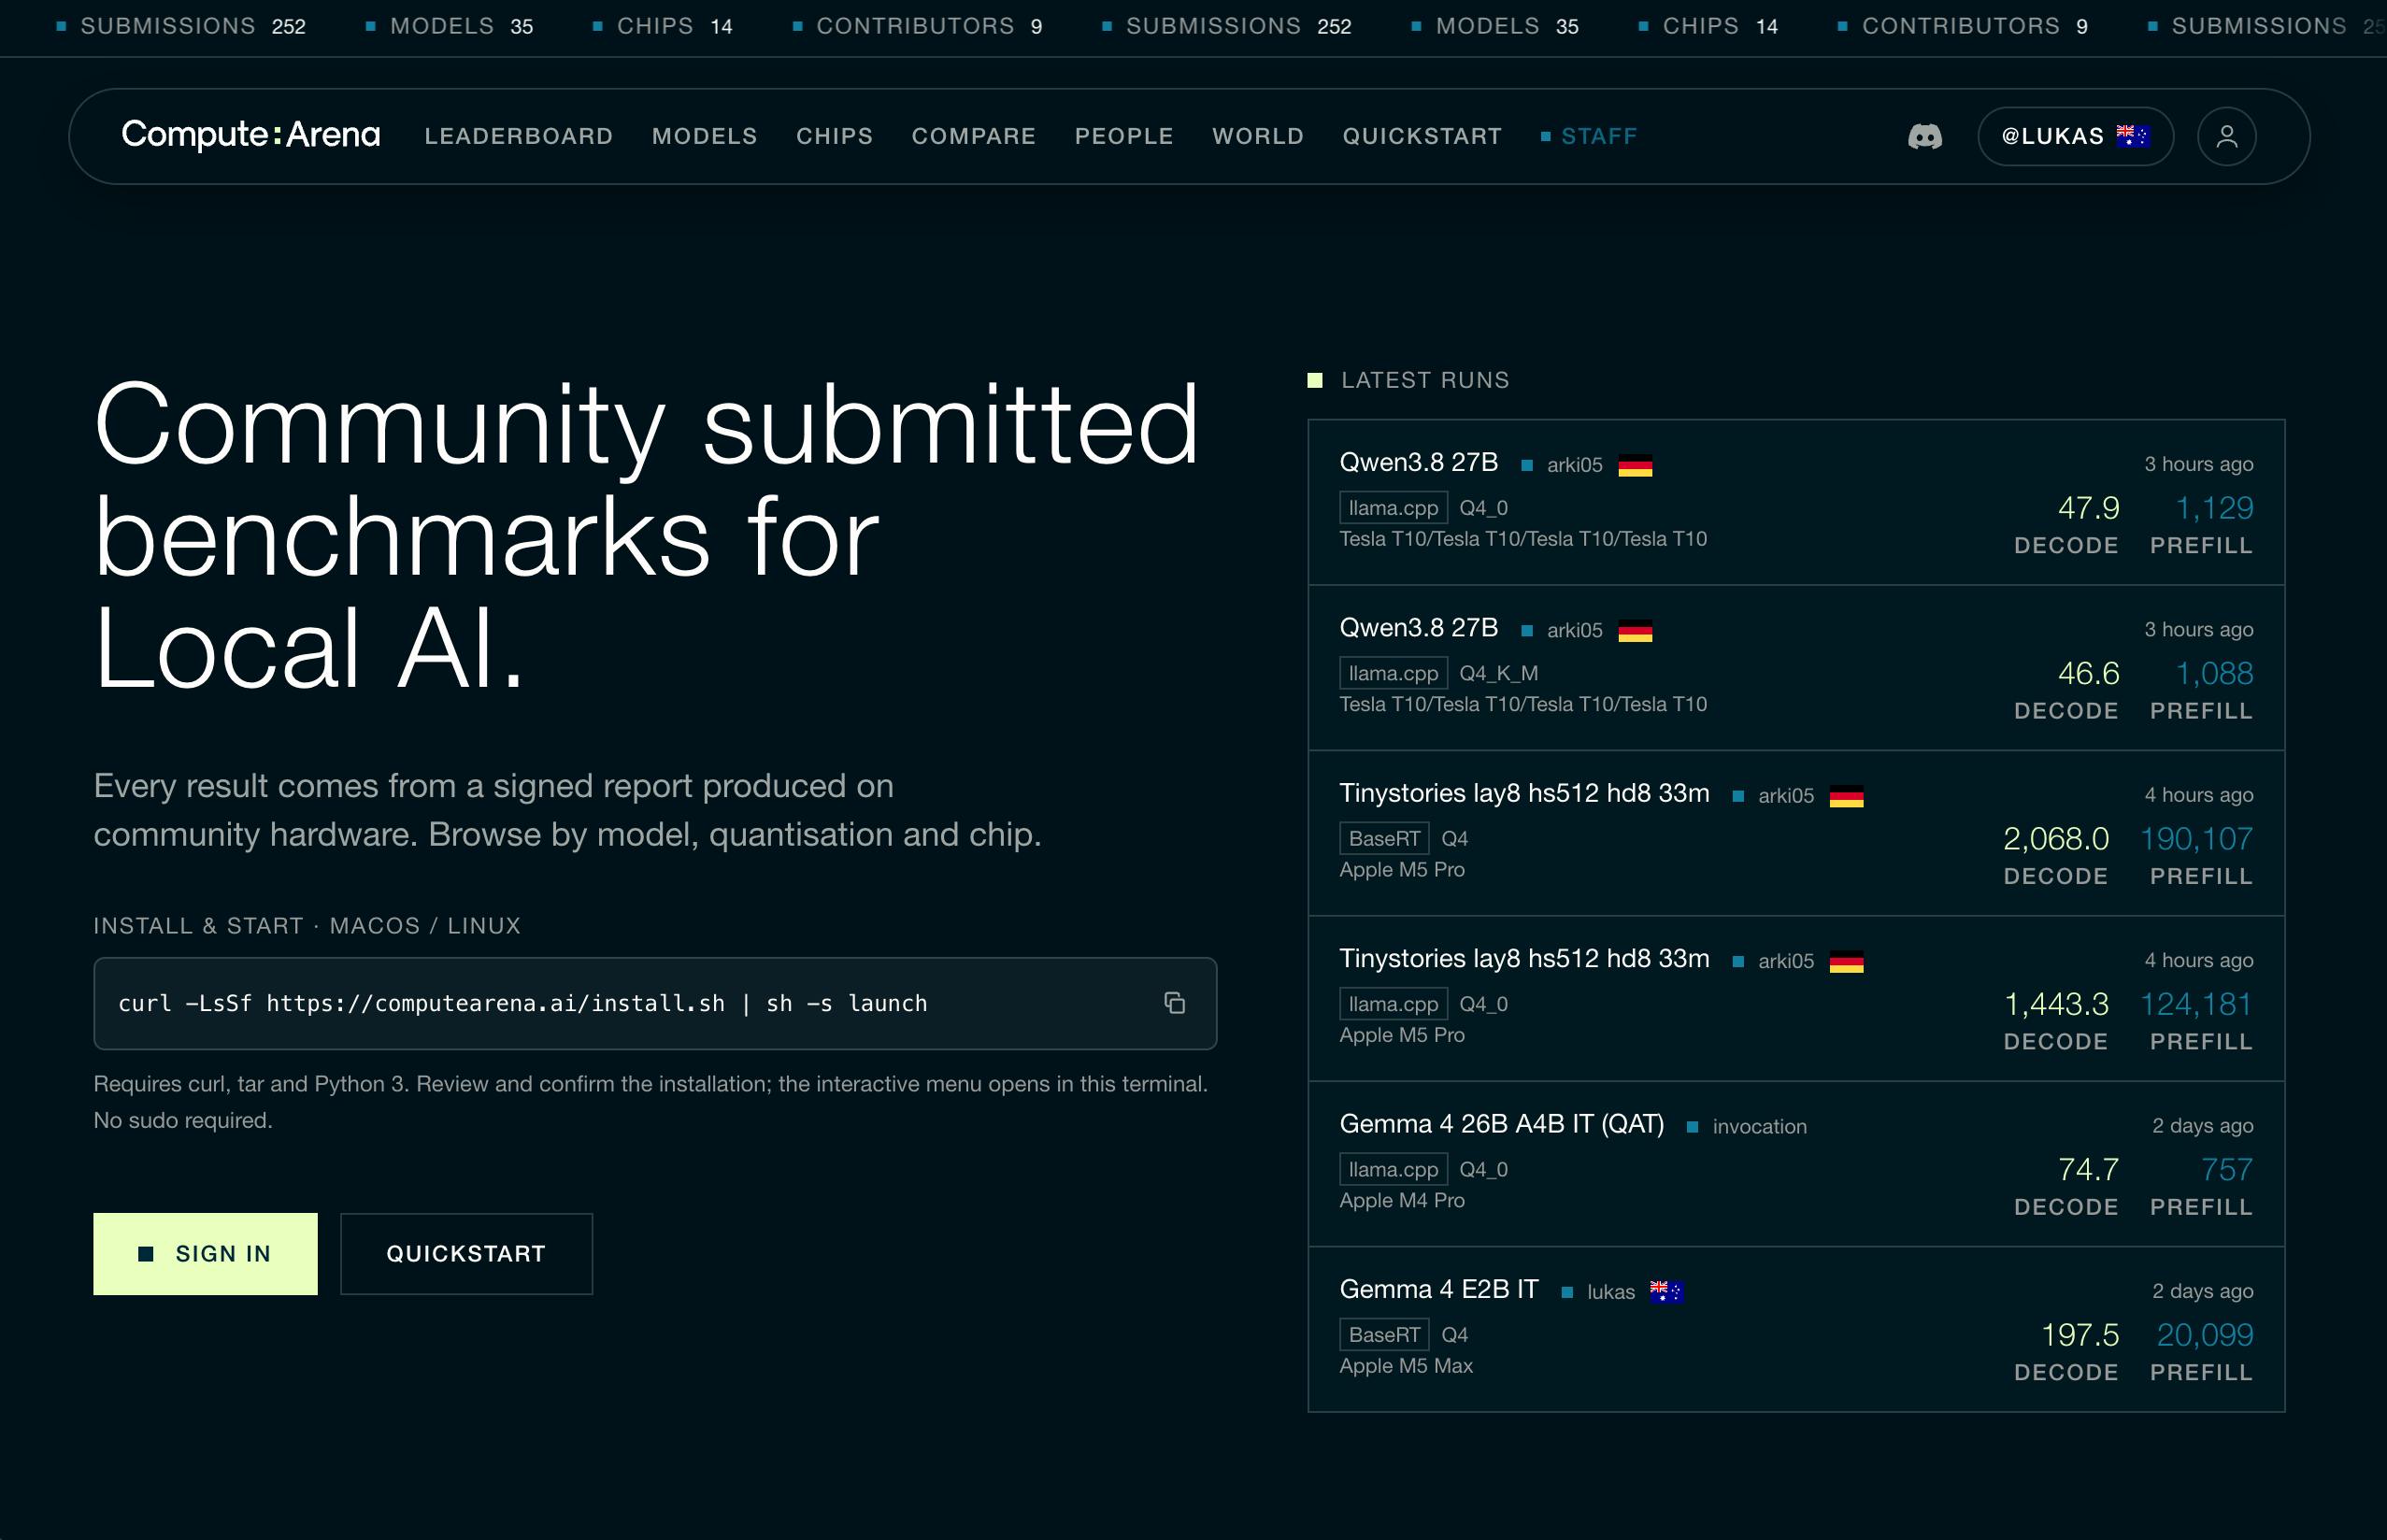
Compute:Arena:社区众包的本地AI性能基准测试平台
Compute:Arena 是一个社区众包的本地AI性能基准测试平台,覆盖任意硬件、运行时与量化方案。本文解析其产品定位、众包模式价值及开源属性。
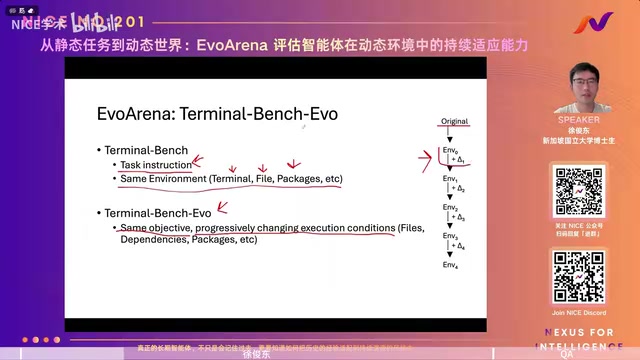
EvoArena:评估AI智能体在动态环境中的持续适应能力
新加坡国立大学团队提出EvoArena,专门评估AI智能体在动态演变环境中的持续适应能力,涵盖终端、软件工程、个性化对话三大场景,并推出类Git的EvoMem补丁记忆方法,揭示最强模型在环境追踪上的短板。

