#基准测试
共 102 篇相关文章

12家搜索API实测:任选两家命中率竟追平最优单家
Reddit基准测试显示:12家搜索API中随机两家命中率68%,与最优单家持平;两家叠加提升至77%,而16%查询无人能答,问题在智能体搜索策略而非供应商选择。
前沿模型能被视觉诱饵骗过吗?Elorian用图像思考破局
Elorian发布诱饵计数基准,揭示前沿多模态模型在视觉推理上的短板,并提出Glimpse方案,尝试让模型用图像而非文本进行思考,弥合感知与推理之间的差距。
Google发布Gemini 4 Carbon:号称最强前沿模型
Google发布Gemini 4 Carbon并号称最前沿模型,但Reddit社区质疑其基准测试表格通过将Astra排在Opus 5.5之上来美化排名,讨论聚焦于对比表格的可信度。
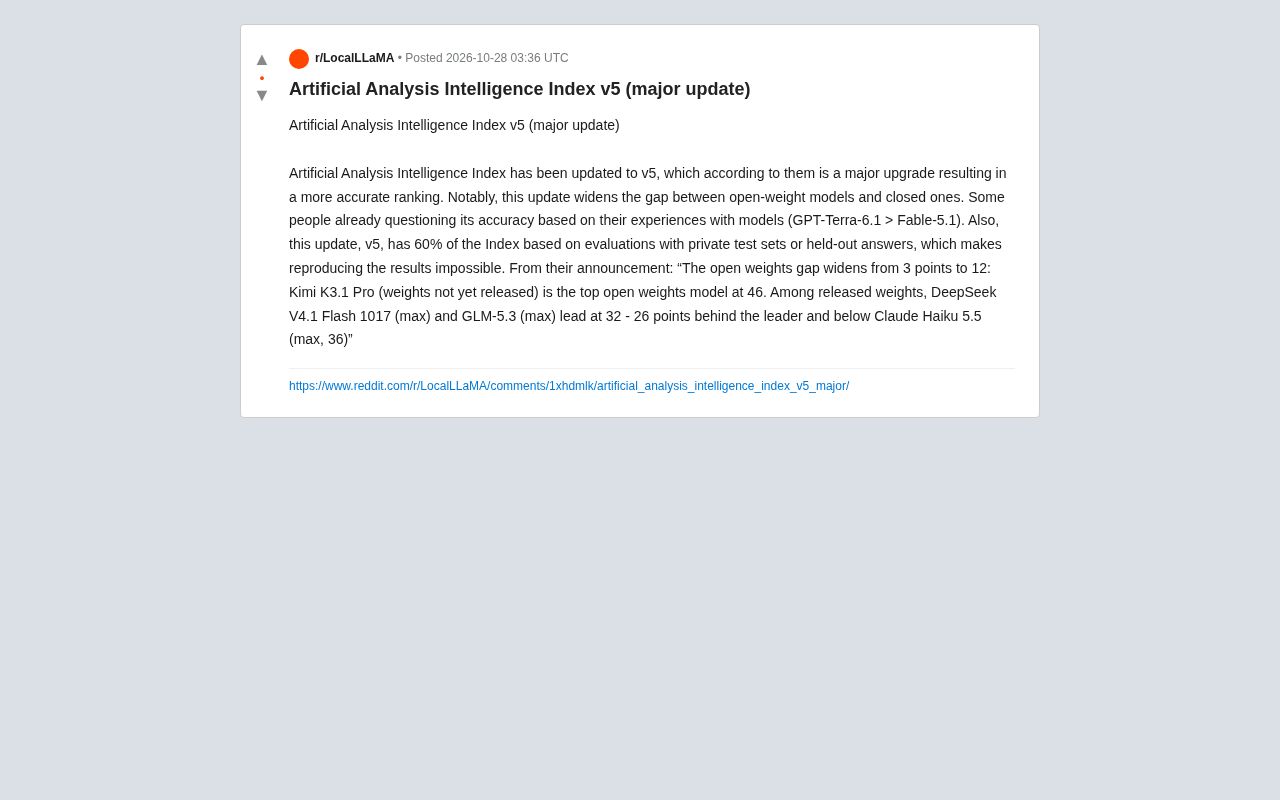
Artificial Analysis智能指数v5大更新:开源与闭源差距拉大,评测可信度遭质疑
Artificial Analysis Intelligence Index 更新至 v5,官方称排名更准确,开源与闭源差距从3分扩大到12分,但60%评测基于私有测试集导致结果无法复现,社区对排名准确性提出质疑。
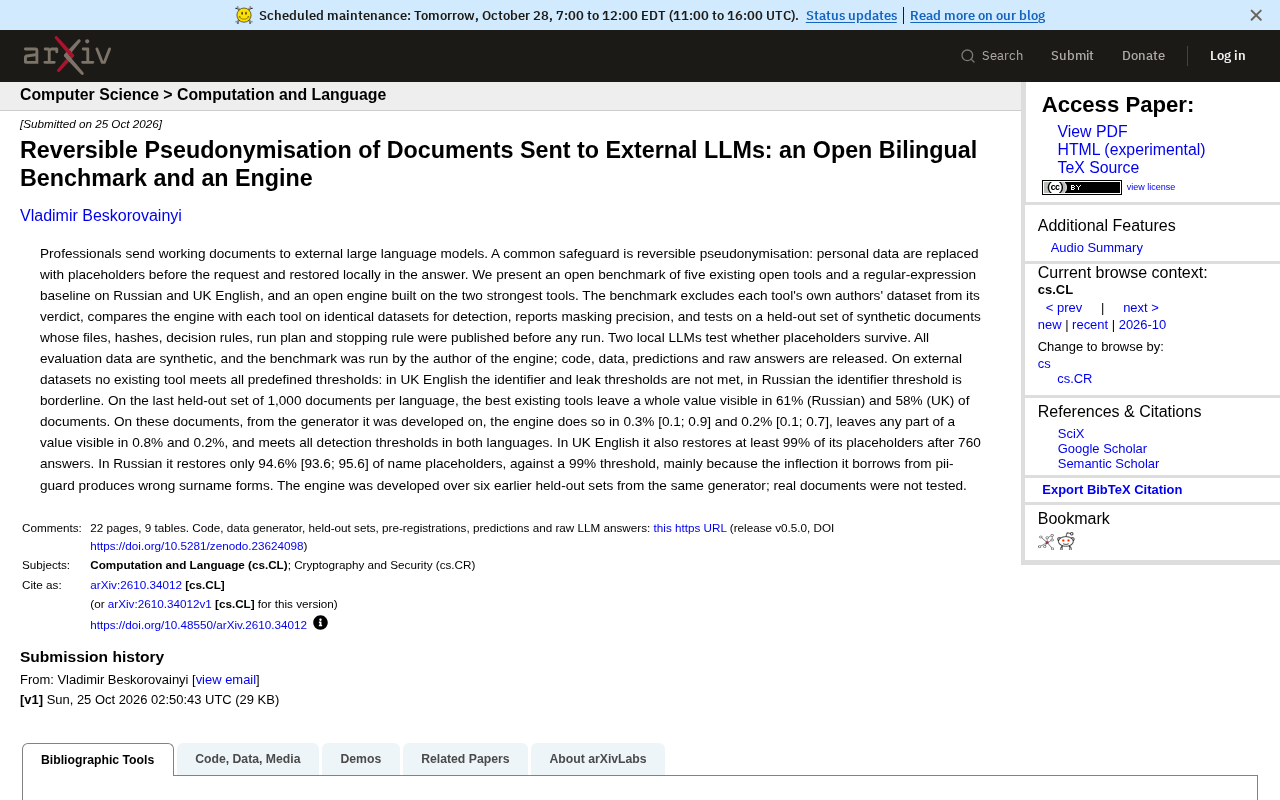
外部LLM文档可逆脱敏:开源双语基准与引擎
开源双语基准评估五个现有工具的可逆脱敏性能,发现最佳工具在61%俄语文档和58%英式英语文档中泄露完整值。新引擎将泄露率降至0.3%和0.2%,但俄语姓名还原仅94.6%。

GPT-6.1 Terra:$1/$5定价与Terminal-Bench 4.0跑分解析
OpenAI GPT-6.1 Terra 以每百万 token $1/$5 定价推出,Terminal-Bench 4.0 厂商自报 50.3%,价格仅为 Sol 一半。本文解析其定价策略、跑分含义与适合路由的任务类型。

PHYRD基准:AI理论物理推理的严苛试金石
PHYRD基准包含63个复现与43个发现任务,评估AI理论物理推理能力。模型在发现任务上准确率低至18.6%,但FormulaForest合成数据可提升下游基准表现。

IGG基准:交互式GUI定位新挑战,AI智能体如何突破可见性约束?
IGG基准要求AI智能体先通过交互使GUI元素可见再点击,人类准确率94.6%,开源VLM仅31.6%。本文解读这一新基准的设计、性能差距及核心瓶颈——执行揭示交互而非识别目标。

RobustRLlib:17种鲁棒强化学习算法的统一基准库
RobustRLlib是一个统一的鲁棒强化学习算法库与基准,整合17种在线、离线与安全RL算法,覆盖273种扰动配置,揭示当前鲁棒RL的能力边界与差距,开源可扩展。
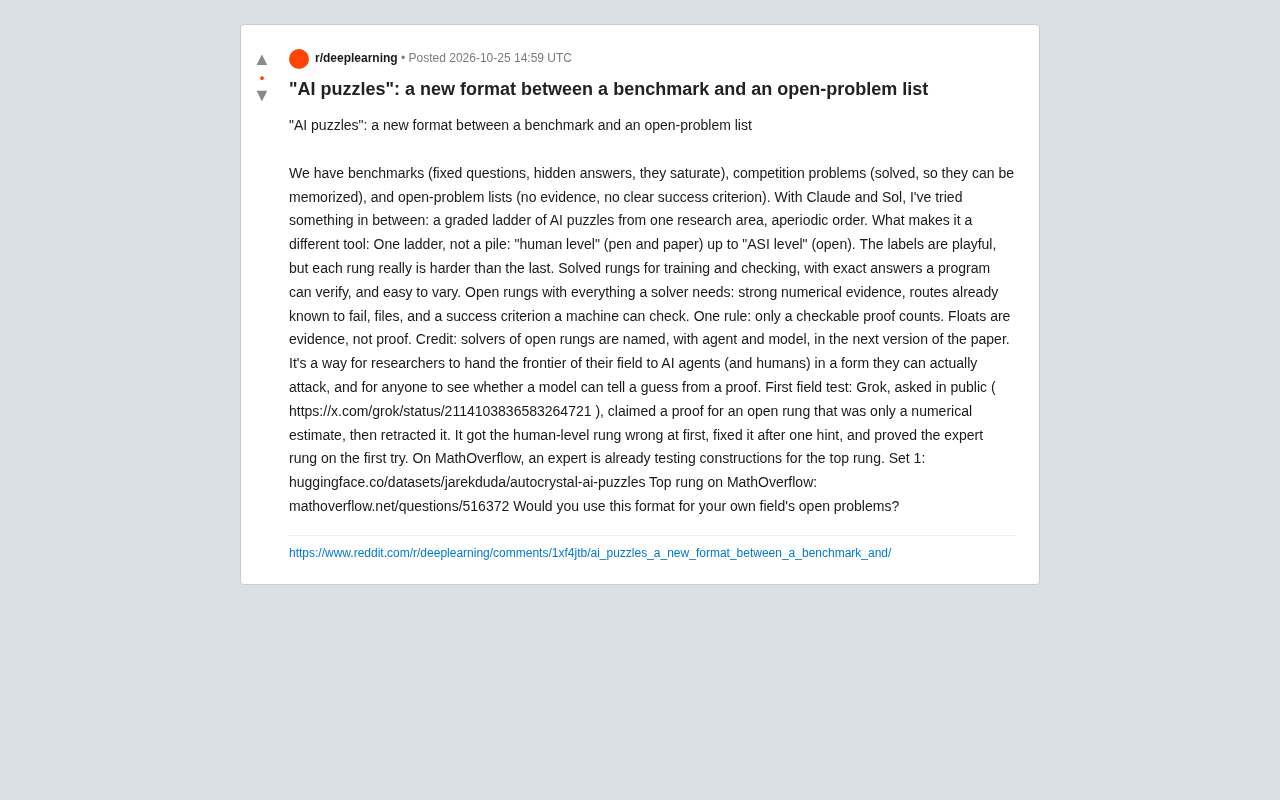
AI谜题:介于基准测试与开放问题之间的新范式
AI谜题(AI puzzles)是一种介于基准测试与开放问题之间的新评估格式,以非周期序领域为试点,通过分级阶梯和可机器验证的证明标准,测试AI能否区分猜测与证明。Grok首次实测中曾把数值估计误报为证明。

Qwen3.8-27B真能硬刚Fable 5?拆解GVS5H基准争议
GVS5H 声称五个 Qwen3.8-27B 实例在 LiveCodeBench Hard 上打平 Fable 5,Hacker News 却质疑其评测方式。本文拆解这套 harness 的运作逻辑、争议焦点,以及多模型集成方案中真正值得借鉴的部分。
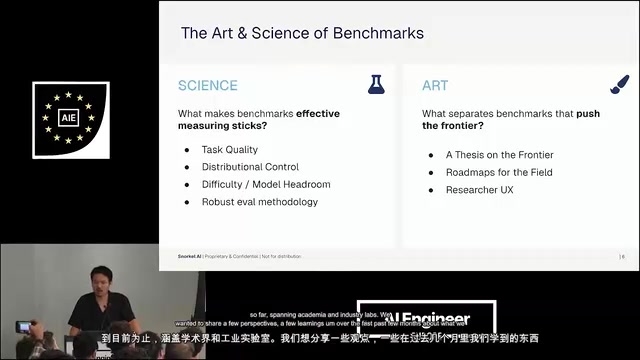
Agent落地卡在评测:Snorkel AI拆解有效基准的六条法则
Snorkel AI联合创始人Vincent拆解Agent评测鸿沟:从任务质量、分布多样性、模型余量到评测方法论,解析有效基准的科学与艺术,并展望环境复杂度、自主时长等下一代基准方向。
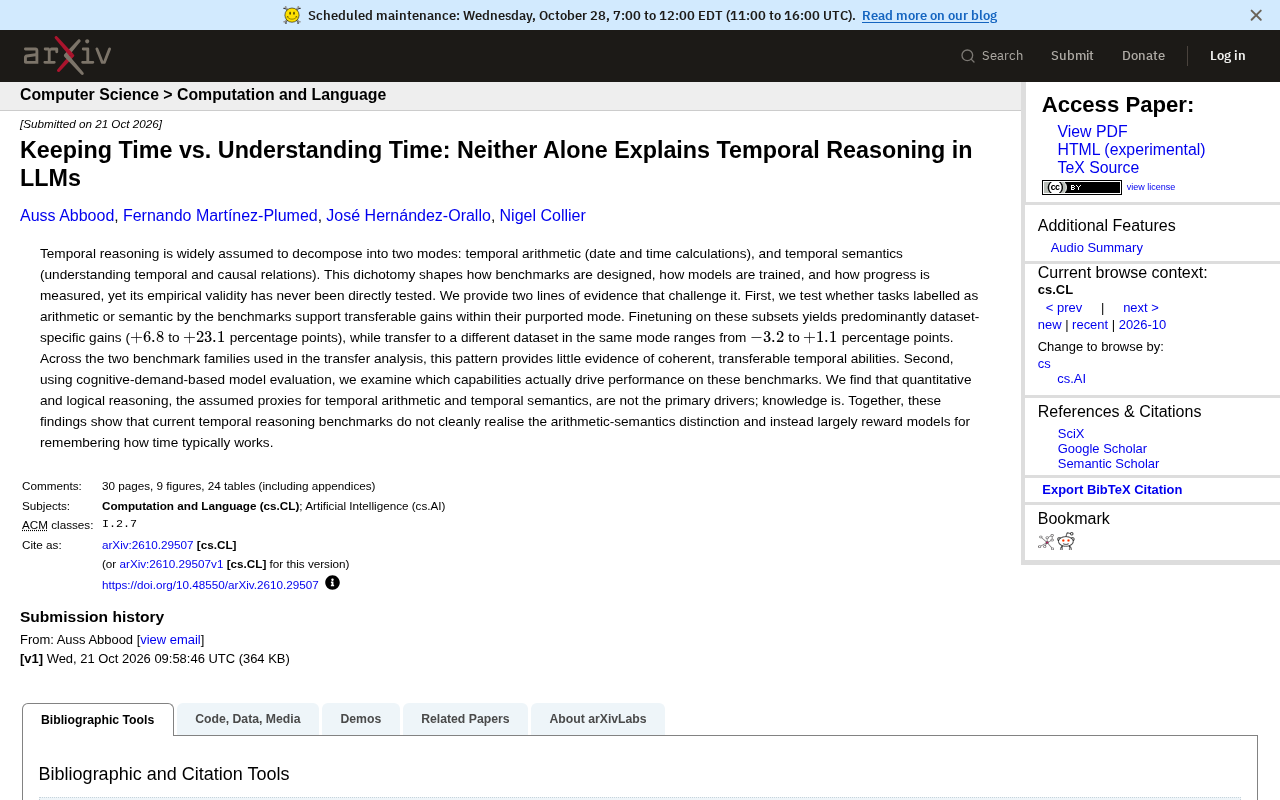
LLM时间推理的真相:算术与语义二分法失效,知识记忆才是关键
新研究挑战LLM时间推理的算术与语义二分法,实验显示微调收益高度依赖数据集,迁移增益微弱,知识记忆而非推理能力才是基准表现的主要驱动力。

xhigh推理成本翻倍却难提通过率:SlopCodeBench测评结果
SlopCodeBench十月测评显示,xhigh推理强度成本是medium的2到4倍,但检查点通过率并未可靠提升。本文解读测评数据,分析过度推理的边际效益递减,并给出AI编程中推理强度的分层配置建议。

MindView:多视图空间智能生成基准,11个模型均不及格
MindView基准包含1500个样本和七项任务,评测11个生成模型后发现多视图空间智能仍有较大提升空间,微调BAGEL可提升24.3分,MindCue方法能有效利用扩展上下文证据。

Opus 5.5 与 Astra 领跑 SlopCodeBench 2026:高推理限制为何适得其反
SlopCodeBench 2026 榜单显示 Astra 整体夺冠、Opus 5.5 表现亮眼,而最高推理强度 xhigh 反而有害。本文解读榜单信号,分析脏代码输入下的模型表现差异,并给出推理强度调优与多模型组合的实践建议。

LLM代码优化评估新基准:PatternBench如何剥离编译器功劳?
PatternBench基准通过AST分析验证LLM代码优化的忠实度,剥离编译器已有优化的影响,揭示仅靠端到端加速评估的局限。实验表明优化忠实度与加速强相关,微调可同时提升两者。

EvoSkill v2:有状态进化器如何让AI智能体自我改写技能
EvoSkill v2 提出三智能体系统,用有状态进化器改写AI智能体技能而非模型权重。在 SpreadsheetBench v2 和 τ³-bench banking 上留出集通过率分别提升7.7和5.4个百分点,单位收益成本低于 SkillOpt 与 SkillBoost,弱模型自我进化最高提升21.5个百分点。

