#模型评测
共 106 篇相关文章
如何评估AI Agent:从工具调用到任务完成的全链路测评
AI Agent评估需要从工具调用到任务完成的全链路视角。本文解析Agent测评的两个核心层次,帮助团队判断Agent能否在真实环境中完成复杂连续任务。

GPT6对决Fable5.1:屎山之巅祖传Bug实测谁更强
B站UP主用祖传屎山Bug实测GPT6、Fable5.1与Gemini 3.8三大模型编程能力。GPT6满分通关王者Bug封神,Fable5.1紧随其后,Gemini掉队。一文看懂AI编程能力真实差距。

AI能力在飙升,可靠性却停滞:被忽视的真正难题
AI能力持续飙升,但可靠性却停滞不前。基于普林斯顿HAL研究和Nature论文,本文探讨为何评测体系奖励自信错误、Agent从建议转向执行后的风险量级变化,以及生产环境中衡量AI可靠性的真正难题。

Fable 5引发热议:AI推理能力真的在下降吗?
Hacker News 热议话题「Fable 5」指出 AI 推理能力中位数在八月出现下滑,引发社区对大模型表现波动的讨论。本文分析模型退化的可能原因与第三方监测的价值。
GPT-6 Astra实测:普通人该选哪一档模型?五大场景全对比
GPT-6 Astra 三档模型(Astra 低档/高档、Soul 高档)在 3D 建模、游戏开发、PPT 制作、旅行规划四大场景实测对比,从额度消耗、耗时到成果差异,帮普通人选出最适合日常办公的模型档位。
别只看 tok/s!开源本地大模型体检工具 LLST 实测详解
本地大模型只看 tok/s 远远不够。开源工具 LLST 用 102 道能力基准 + 长上下文梯度压力测试,实测双 7900 XTX 运行千问 3 Flash Next,全面还原模型能力、性能衰减与首 token 延迟。
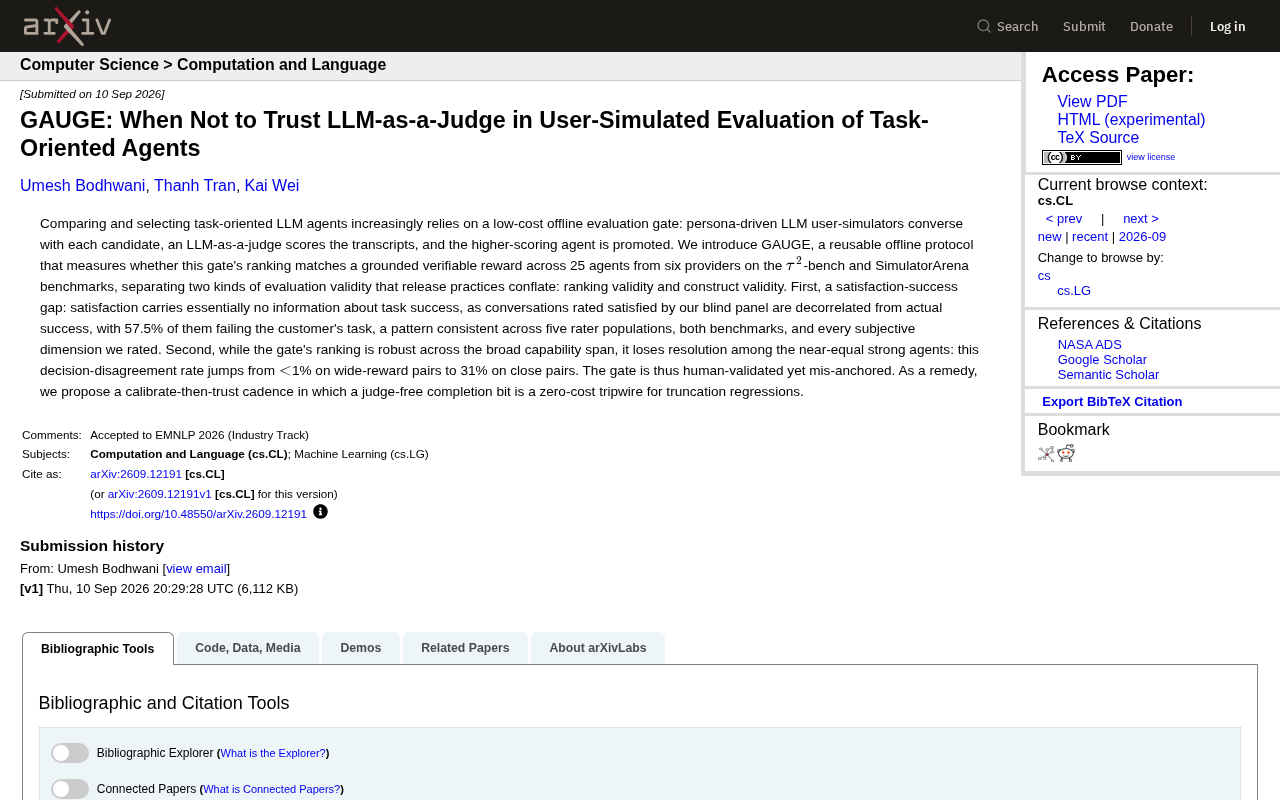
GAUGE研究:何时不能信任LLM-as-a-Judge的智能体评测
GAUGE 研究揭示 LLM-as-a-Judge 在任务型智能体评测中的两大盲区:满意度与任务成功几乎不相关(57.5%满意对话实际失败),且面对势均力敌的强模型时分歧率飙升至31%,并提出「先校准再信任」的补救方案。
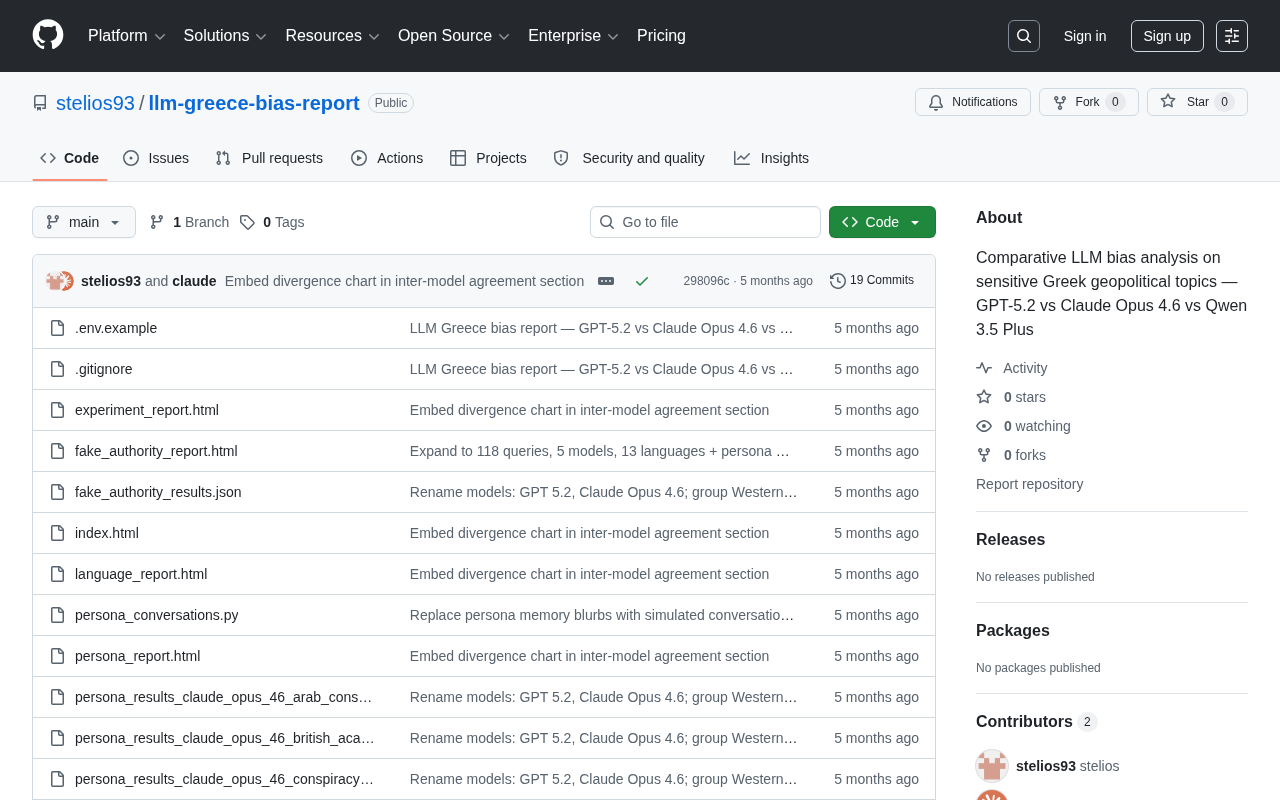
三大模型地缘政治偏见对比:GPT-5.2、Claude、Qwen实测
一个开源项目对比GPT-5.2、Claude Opus 4.6和Qwen 3.5 Plus在希腊敏感地缘政治话题上的偏见表现。本文解析该项目的评测思路、现状局限及大模型中立性审计的现实意义。
 产品体验
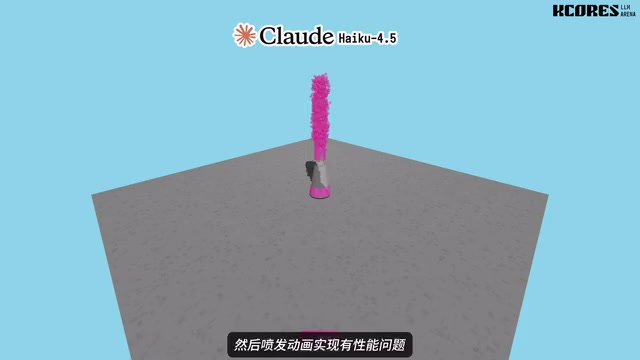
Claude Haiku 4.5实测:5项编程任务全面翻车
通过大象牙膏动画、过山车3D建模、鞭炮连锁爆炸等5项可视化编程任务实测Claude Haiku 4.5,发现该经济型模型在3D建模、物理逻辑推理、指令遵循等方面均表现不佳,复杂任务失败率极高。
 科技前沿
Gemini 3.5 Flash在GDPval基准上实现巨大飞跃
Google Gemini 3.5 Flash在GDPval基准测试中超越Gemini 3.1 Pro,轻量级Flash模型借助后训练技术逼近前沿水平,重新定义性能与成本的平衡点,为AI应用开发者带来重大利好。
 科技前沿
Gemini 3.5 Flash登顶Vending Bench性价比前沿
Google Gemini 3.5 Flash在Vending Bench基准测试中达到成本-智能帕累托最优,展现极强性价比。本文解析Vending Bench评测方法、帕累托前沿含义及对AI应用开发者的实际意义。
 产品体验
GPT-5.5对决DeepSeek-V4:四轮实测谁更强?
GPT-5.5与DeepSeek-V4四轮全方位实测对比,涵盖世界知识、上下文记忆、逻辑推理和编程开发,详解两大旗舰AI模型的真实表现差异与各自优劣势。
 科技前沿
Gemini 3.2 Pro泄露测试令人失望,GPT-5.6已在内部测试
Gemini 3.2 Pro首批泄露测试结果表现平平,SVG生成小幅改进但UI能力薄弱,Flash版与Pro版难以区分。同时GPT-5.6已开启内部测试,Claude新预览版在网络安全领域实现突破性表现。AI模型迭代周期急剧缩短,行业竞争白热化。
 产品体验
GPT-5.5实测3周:编程能力碾压Opus 4.7?
EVERY团队深度测试GPT-5.5三周,通过SABench高级工程师基准测试对比Claude Opus 4.7。GPT-5.5编程执行力得分62.5远超Opus的33分,但最佳实践是用Opus规划+GPT-5.5执行的组合工作流。
 产品体验
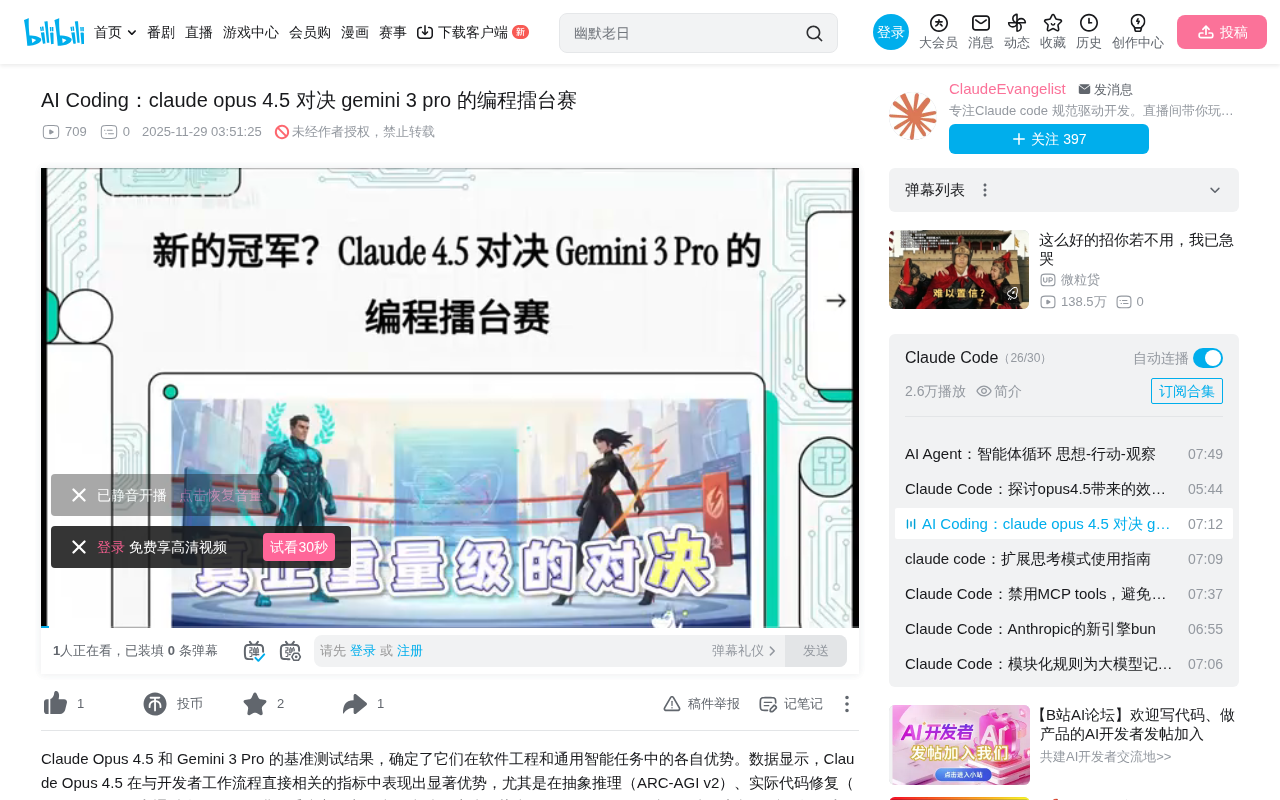
Claude 4.5 vs Gemini 3 Pro:编程能力全面对决
基于ARC-AGI-V2、SWE-Bench、Terminal Bench 2.0等五大基准测试,深入对比Claude 4.5与Gemini 3 Pro在编程实战和知识推理上的真实表现,帮你找到最适合的AI编程助手。
 产品体验
DeepSeek V4 Pro深度评测:对比8款旗舰模型谁更值得用
DeepSeek V4 Pro全方位横评,对比GPT 5.5、Claude Opus 4.7、GLM 5.1等8款旗舰模型,覆盖价格、编程、推理、Agent、角色扮演等维度,附场景化选购建议。
 产品体验
Gemini 3.5 Pro深度评测:多模态断层领先,9.2分旗舰实力全解析
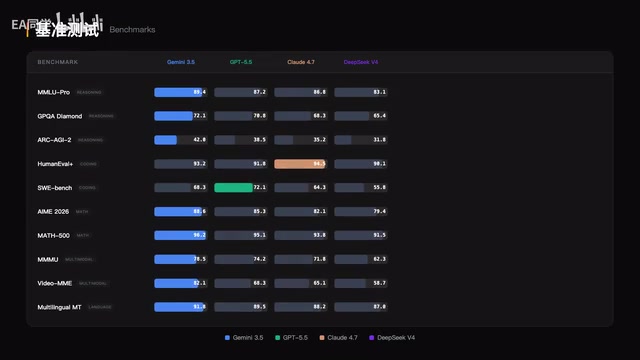
深度评测Google DeepMind旗舰模型Gemini 3.5 Pro,涵盖MMLU Pro 89.4分、Video ModeM 82.1分等基准数据,横向对比GPT 5.5、Claude 4.7,解析DeepThink推理、200万上下文窗口、多模态能力等核心优势与不足。
 产品体验
Claude Opus 4.7深度实测:编码能力飙升,最强模型Mythos仍被封印
Claude Opus 4.7实测评测:SWE Bench编码基准全面领先GPT 5.4和Gemini,视觉处理能力提升3倍,开发者工具大幅更新。Anthropic承认最强模型Mythos因安全风险被封印,揭示AI竞争格局深层变化。
 教程攻略
Gemini 3.5 Flash国内怎么用?6种方法亲测可用(2025最新)
Gemini 3.5 Flash全面超越3.1 Pro,速度快4倍价格减半。本文详解国内使用Gemini 3.5的6种方法,包括AI Studio免费使用、免魔法中转站、API调用等方案,附对比表格帮你快速选择。
 产品体验
DeepSeek V4 vs Qwen3.6实测:8大类150场景深度对比评测
使用BenchLocal工具对DeepSeek V4 Pro、V4 Flash与Qwen3.6 27B进行8大类85场景实测对比,涵盖工具调用、代码调试、推理数学等维度,V4 Pro总分领先6%但数学推理意外翻车,Qwen3.6 Q6在智能体场景媲美V4 Pro。