#模型评测
共 106 篇相关文章

四大AI图像模型实测:同一题目下谁画露珠更真实
四款主流AI图像模型 GPT Image 2.5、通义 Image 3.0 Pro、Nano Banana 2、即梦 5.0 Pro 同题实测,以露珠微距为题考察细节质感,由AI评委综合打分。GPT Image 2.5 以78.2分夺冠,Nano Banana 2垫底。

智能应按成本衡量:OpenAI模型评测新范式解读
一条业内观点引发讨论:AI模型评测应将智能视为成本的函数。本文解读OpenAI新型评测呈现方式背后的行业意义,以及它对开发者模型选型的实际启示。
Opus 5.5实测:第一个让我真正喜欢的AI模型
一位长期批评Claude的开发者实测Claude Opus 5.5与GPT-6 Sol/Luna,从编码、沟通风格、抗质疑能力到真实视频编辑项目全面对比,解读新一代AI模型为何更简洁、更少AI腔。
谷歌前沿模型跳票基准测试?社区质疑声起
一条Reddit吐槽直指谷歌前沿模型发布时使用缺乏透明度的基准测试。本文解析“Trust me bro”跑分现象,探讨AI模型评测可信度与第三方独立评测的重要性。
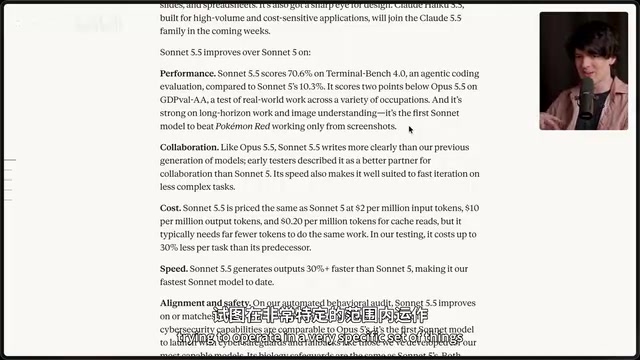
Anthropic Sonnet 5.5深度评测:别急着用,它更适合当工具
Theo(t3.gg)深度评测Anthropic Sonnet 5.5:Terminal Bench跑分暴涨七倍,但缓存读取价格暗藏陷阱、前端设计偏弱、Max模式应避免。它的真正价值在于作为Opus调用的子代理工具。

Claude Opus 5.5对决GPT-6:一场实测中的降维打击
Claude Opus 5.5与GPT-6实测横评:从茶壶骑车Blender建模、森林城堡交互场景到GTA小游戏,解析两款新模型在3D生成、交互能力与算力消耗上的真实差距。

OpenAI反击Anthropic:GPT-6.1 Sol性能逼近Opus,价格仅为1/73
OpenAI在Anthropic Opus 5.5发布后仅一周推出GPT-6.1 Sol,性能逼近Opus但价格仅为1/73。技术博主Theo实测解读其缓存定价突破、代码审查优势,以及前端和长任务上的明显短板。
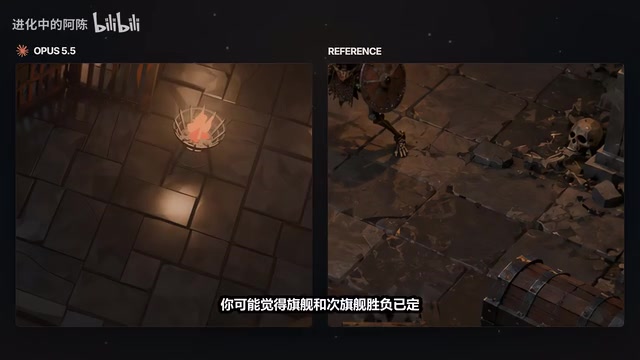
Claude Sonnet 5.5实测对决Opus 5.5与GPT 6.1:纯代码开发3D游戏谁更强
Claude Sonnet 5.5性能实测对决Opus 5.5与GPT 6.1:三款模型纯代码在Blender建模、Godot组装3D地牢游戏。次旗舰完成度逼近旗舰,但低单价未必换来低总账单,附详细等价成本对比。

GPT-6.1 Sol 实测:3D任务不敌Claude Opus 5.5?
GPT-6.1 Sol 实测对比 Claude Opus/Sonnet 5.5。同价位下,Sol 在 3D 游戏生成上不及 Sonnet,但在场景复刻、视觉理解和 token 效率上表现亮眼。附泳池派对、滑板游戏、Jerry 公寓复刻等多项测试细节。

Claude Sonnet 5.5深度评测:剑指OpenAI的隐藏杀招
Claude Sonnet 5.5深度评测:虽然基准数字不亮眼、前端能力弱、token消耗大,但作为Opus编排的子agent工具价值惊人。详解其缓存读取定价陷阱、Max模式问题与真实使用成本。

Layla真是开源版Jev吗?深度扒开开源决策模型的真相
开源决策模型Layla号称比闭源Jev快50倍,是真平替还是营销?本文深扒Layla的双向编码器架构、速度对比水分、微调前后准确率差异与多语言翻车点,解析它为何在国内开发者圈爆火。
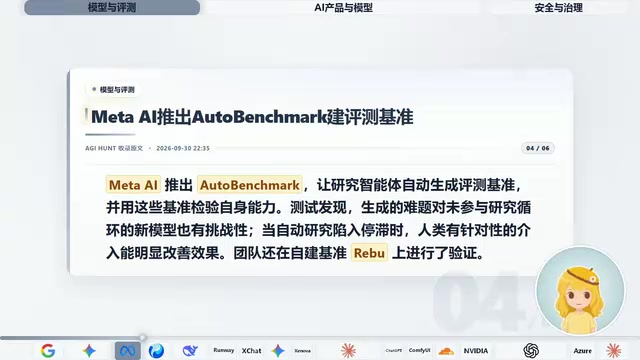
Gemini 4 Argon登顶Text Arena,Anthropic称AI攻克数学难题
Google发布Gemini 4 Argon登顶Text Arena、Agent Arena第八,Anthropic称AI完成渗流理论数十年难题证明。本期AI早报还涵盖Runway Ads、ComfyAPI、Cloudflare AutoRouter及FTC监管调查等动态。

GPT-6.1 Sol 实测:与 Claude Sonnet 5.5 同价,3D与代码谁更强?
GPT-6.1 Sol 实测评测:以与 Claude Sonnet 5.5 相同的价格发布,在 3D 游戏、C++ 编程、Blender 建模等任务中表现如何?静态建模惊艳、编程称职,但动态 3D 视觉不及 Sonnet 5.5。
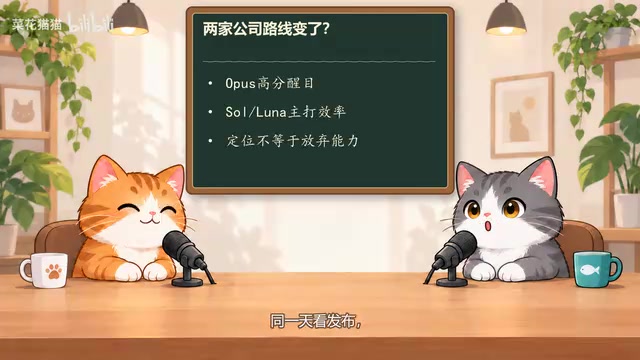
GPT-6 Sol和Luna降价一半,为何榜单没涨?
OpenAI将GPT-6的Sol和Luna价格砍半,但综合榜单分数几乎没涨。本文解析为何降价不等于能力全面提升,以及开发者该如何按真实任务而非榜单来选择模型。

Opus 5.5实测拆解:更便宜、更能打游戏的第一梯队模型
Claude Opus 5.5实测汇总:价格降四成、综合智能指数第一、计算机操作与游戏开发全面领先。本文从价格、榜单、应用场景、代码审查与成本策略六个角度,拆解它的真实强项与隐藏坑点。

重新审视:大模型玩宝可梦的进步说明了什么
Reddit社区重新审视大语言模型在《宝可梦》游戏中的表现进展。本文分析为何游戏成为评估LLM长程规划与推理能力的新基准,进步与瓶颈并存的现状,以及如何理性看待AI通关成绩。

Opus 5.5被悄悄削弱了吗?LiveNerf基准实时追踪模型能力
开发者推出开源基准项目LiveNerf,每日复测GPQA、SWE-bench追踪Anthropic Opus 5.5是否被悄悄削弱能力。目前暂未检测到nerf迹象,本文解析其测试方法、7.5分判定阈值及模型降智争议。
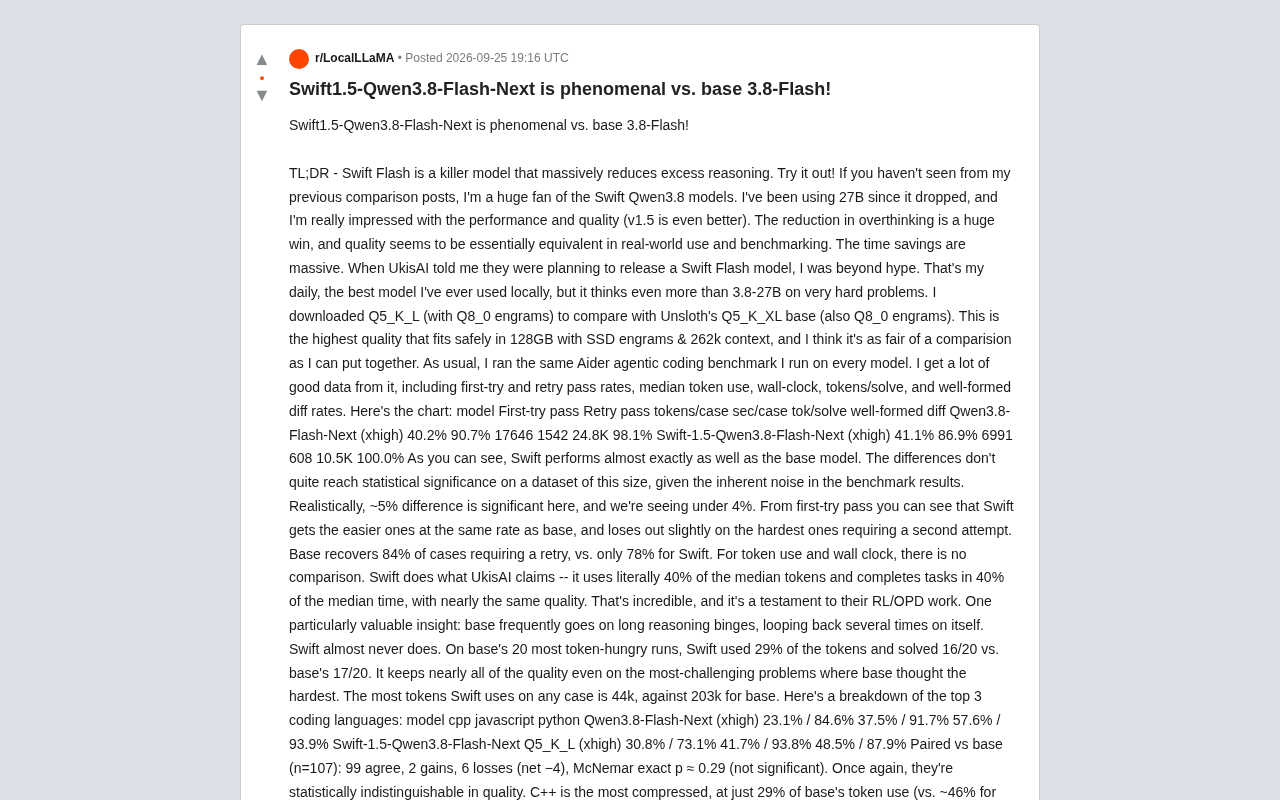
Swift1.5-Qwen3.8-Flash-Next实测:推理提速60%,质量几乎无损
Swift-1.5-Qwen3.8-Flash-Next实测对比基础版Qwen3.8-Flash:Aider编程基准显示其推理token和耗时降至40%,质量几乎无损,C++场景需留意。本地大模型效率优化实录。

