#NVIDIA
共 65 篇相关文章

用NVIDIA NeMo Relay追踪Agent执行路径:让效率可见
NVIDIA NeMo Relay通过追踪Agent Harness执行行为,帮助开发者发现智能体完成任务背后的低效路径。本文解析Agent可观测性为何重要,以及如何从任务成功率转向过程质量评估。
NVIDIA VSS Blueprint 3.3:降低视觉AI智能体的构建与运行成本
NVIDIA 推出 VSS Blueprint 3.3,聚焦降低视觉AI智能体的构建与运行成本。本文解析视频搜索与摘要蓝图的定位、成本优化思路及其对开发者和企业落地视觉AI的实际意义。

NVIDIA DSX MaxLPS:如何榨干AI工厂的每一瓦性能
NVIDIA DSX MaxLPS 通过动态功率调度打破AI工厂按峰值供电的冗余困境,在既定电力预算下容纳更多GPU,最大化算力吞吐量与能效。本文解析其技术思路与经济价值。
NVIDIA PAIR:把家里闲置算力串成本地AI集群
NVIDIA PAIR 是一款免费软件,能把家中闲置电脑的算力整合成本地AI算力池,自动调度智能体任务,支持Apple设备,主打本地运行与隐私保护。
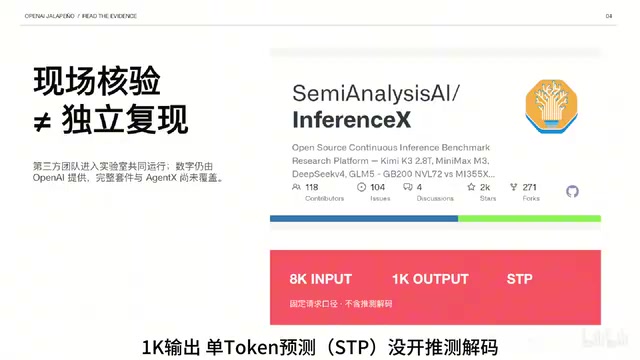
OpenAI Jalapeño 推理芯片首测拆解:胜负写在每瓦 Token 上
OpenAI 自研推理芯片 Jalapeño 首批测试成绩拆解:在 gpt-oss、DeepSeek R1、Kimi K2 三组跑分中,对标 NVIDIA GB200/GB300 实现约 1.5-1.9 倍每瓦吞吐与更低延迟。本文冷静剖析测试边界、Prefill/Decode 架构设计与推理芯片竞争格局。

NodeWright:破解 Kubernetes 节点集群运维难题
NVIDIA 推出 NodeWright,将 Kubernetes 节点集群的内核配置、软件包、存储与安全管理纳入声明式框架,破解大规模 GPU 集群的节点运维难题。

SWE-Serve:为何AI编码智能体测试通过却在真实服务中失效
NVIDIA推出的SWE-Serve基准揭示了AI编码智能体的关键短板:补丁能通过本地测试却在真实模型服务中失效。本文解析推理服务软件评测难题及其对开发者的意义。
NVIDIA机密计算:让高性能AI推理兼顾隐私与安全
NVIDIA机密计算技术如何在GPU加速的AI推理中同时实现数据隐私保护与高性能?本文解析可信执行环境、硬件级加密与认证机制,及其在受监管行业的落地价值。

NVIDIA DLSS 5发布:3D引导神经渲染与RTX Kit新能力解析
NVIDIA发布DLSS 5,引入3D引导神经渲染技术,配合NVIDIA ACE更新与RTX Kit新能力,为游戏开发者提供更逼真的光照材质与更精细的画面控制。本文解析这次更新的技术要点与行业意义。
用AI Agent加速ROS 2节点:NVIDIA Isaac ROS实践解析
NVIDIA Isaac ROS结合AI Agent加速ROS 2节点开发。本文解析为何GPU加速不等于ROS 2图加速,以及如何通过零拷贝优化数据流转、降低机器人高性能开发门槛。
TensorRT多设备推理:简化Dynamo-Triton的多GPU模型部署
NVIDIA在Dynamo-Triton中引入TensorRT多设备推理能力,简化跨多GPU的大模型部署,解决单卡显存与算力不足问题,为生成式AI生产环境提供更高效的推理服务方案。

NVIDIA Earth-2:用实时观测数据驱动天气决策的AI平台
NVIDIA Earth-2 借助 GPU 加速与 AI 天气模型,帮助能源、物流、农业等气象敏感行业将实时观测数据转化为及时的天气决策,提供更高分辨率、更本地化的预测能力。
NVIDIA Isaac for Healthcare:用GPU医学物理仿真训练医疗机器人
NVIDIA Isaac for Healthcare 推出 GPU 原生医学物理仿真平台,通过数字孪生、经典物理与 Cosmos 生成式世界模型,解决医疗机器人训练中数据稀缺、原型迭代慢的难题,覆盖手术、内窥镜、血管介入与机器人超声等场景。
NVIDIA NeMo Data Designer:多模态合成数据生成的开源框架解析
NVIDIA 开源多模态合成数据生成框架 NeMo Data Designer(NDD)深度解析:声明式配置、预览-修订循环、插件扩展与运行时调度,助力大模型训练与企业级数据生产。
TensorRT Edge-LLM实测:Jetson AGX Thor跑MLPerf边缘Agent基准快6.4倍
NVIDIA TensorRT Edge-LLM在Jetson AGX Thor上完成MLPerf边缘Agentic基准测试速度提升6.4倍。本文解析边缘智能体工作负载特点、基准意义及软硬件协同优化对边缘AI落地的价值。
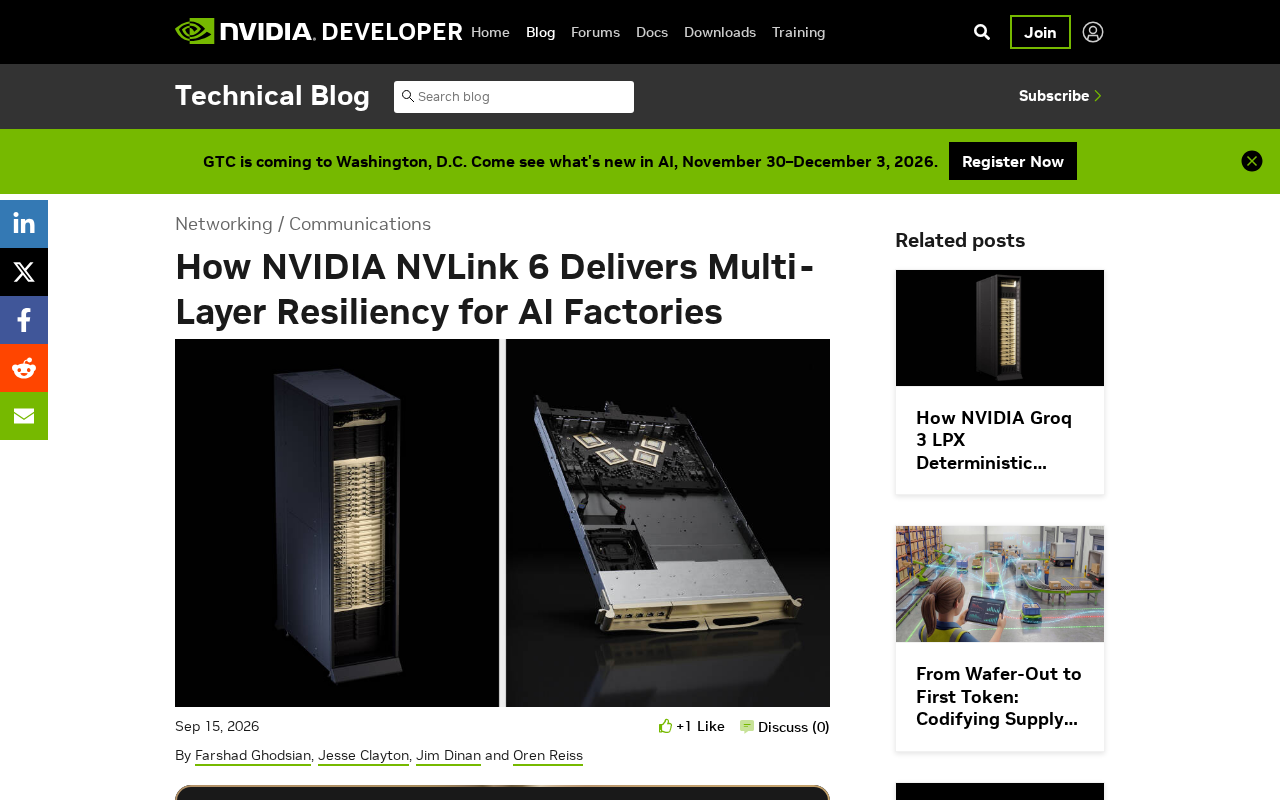
NVLink 6 多层容错:NVIDIA如何保障AI工厂持续算力
NVIDIA NVLink 6 通过多层容错机制为大规模AI工厂提供持续算力保障。本文解析其链路冗余、故障隔离与系统监测的分层设计,以及对超大规模AI训练可用性的实际意义。
NVIDIA FLARE联邦学习实战:跨Docker、K8s与Slurm扩展部署
NVIDIA FLARE开源联邦学习框架支持跨Docker、Kubernetes与Slurm部署,解决异构基础设施下的FL扩展难题,助力医疗、金融等隐私敏感行业从原型走向生产落地。
JAX中加速Dropless MoE训练:NVIDIA Transformer Engine解析
本文解析如何在 JAX 框架中借助 NVIDIA Transformer Engine 加速 Dropless MoE 训练,涵盖 MoE 架构原理、token 丢弃问题、FP8 低精度与分组 GEMM 优化等关键技术。
HP ZGX Fury开放订购:搭载GB300超级芯片与748GB统一内存
HP ZGX Fury AI工作站现已开放订购,搭载NVIDIA GB300超级芯片与748GB统一内存,面向需要本地运行大规模AI模型的开发者与研究团队。本文解析其核心配置、应用场景与社区讨论焦点。
 科技前沿
GitHub Agent HQ发布:AI编程工具进入平台化竞争时代
GitHub Universe大会发布Agent HQ平台,统一管理编码Agent,Copilot升级支持多模型集成。同期OpenAI完成重组,Anthropic新模型测试,NVIDIA开源系列AI模型,AI编程工具格局加速整合。