#大模型
共 301 篇相关文章
Opus 5.5泄露定价更低!Qwen4、Kimi K3.1等国产大模型集中来袭
Anthropic Opus 5.5泄露:性能对标GPT-6 Astra但定价更低。同期StepFun Step5、MiniMax M3.1、阿里Qwen4与Kimi K3.1等国产大模型集中来袭,本文梳理这波密集发布背后的降本与开源趋势。

Claude Opus 5.5对决GPT-6:AI模型价格战全面开打
Anthropic发布Claude Opus 5.5,OpenAI紧随推出GPT-6 Sol与Luna,引爆新一轮大模型价格战。本文解析各模型定价、缓存成本变化及实测表现,包括Opus 5.5 max模式过度思考崩溃等关键发现。

GPT-6 Astra助力Parallel:研究时间与成本双双减半
Parallel借助GPT-6 Astra,让AI智能体在研究和综合劳动力市场数据时实现时间与成本双双减半。本文解析这一效率跃升背后的意义及对AI智能体应用的行业启示。
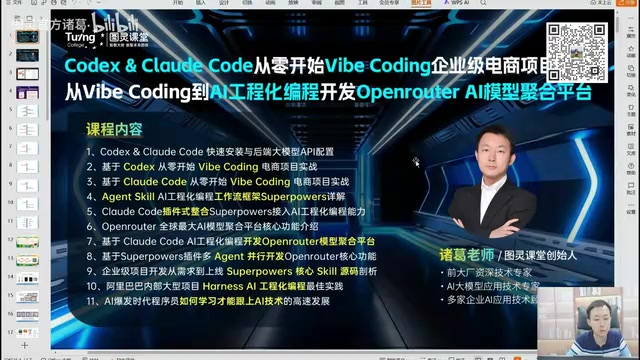
Vibe Coding实战:Codex+Claude Code做企业级AI项目的正确姿势
资深讲师实战解析 Vibe Coding 与 AI工程化编程的区别,用 Codex+Claude Code 从零做电商项目与 OpenRouter AI模型聚合平台,剖析AI编程在企业级项目中的坑与解法,附大模型选型策略。

OpenAI 疑似发布 GPT-6:Sol 与 Luna 引发热议
OpenAI 官网出现「GPT-6 Sol and Luna」页面并在 Hacker News 引发热议。本文梳理 Sol 与 Luna 双模型的可能定位、社区关注焦点,并理性提示当前信息的局限性。

OpenAI 发布 GPT-6 Sol 与 Luna:能力与成本的两种平衡
OpenAI 发布 GPT-6 系列新模型 Sol 与 Luna,两者在能力与成本之间采取不同平衡,旨在将前沿智能带入日常工作。本文解读双模型策略及其对开发者与企业的意义。
OpenAI推出GPT-6 Sol与Luna:更低成本、更少错误
OpenAI正式推出GPT-6 Sol与Luna两款新模型,官方称其与Astra同源,主打更低成本与更少错误。本文解读双模型定位差异及其对AI应用生态的潜在影响。
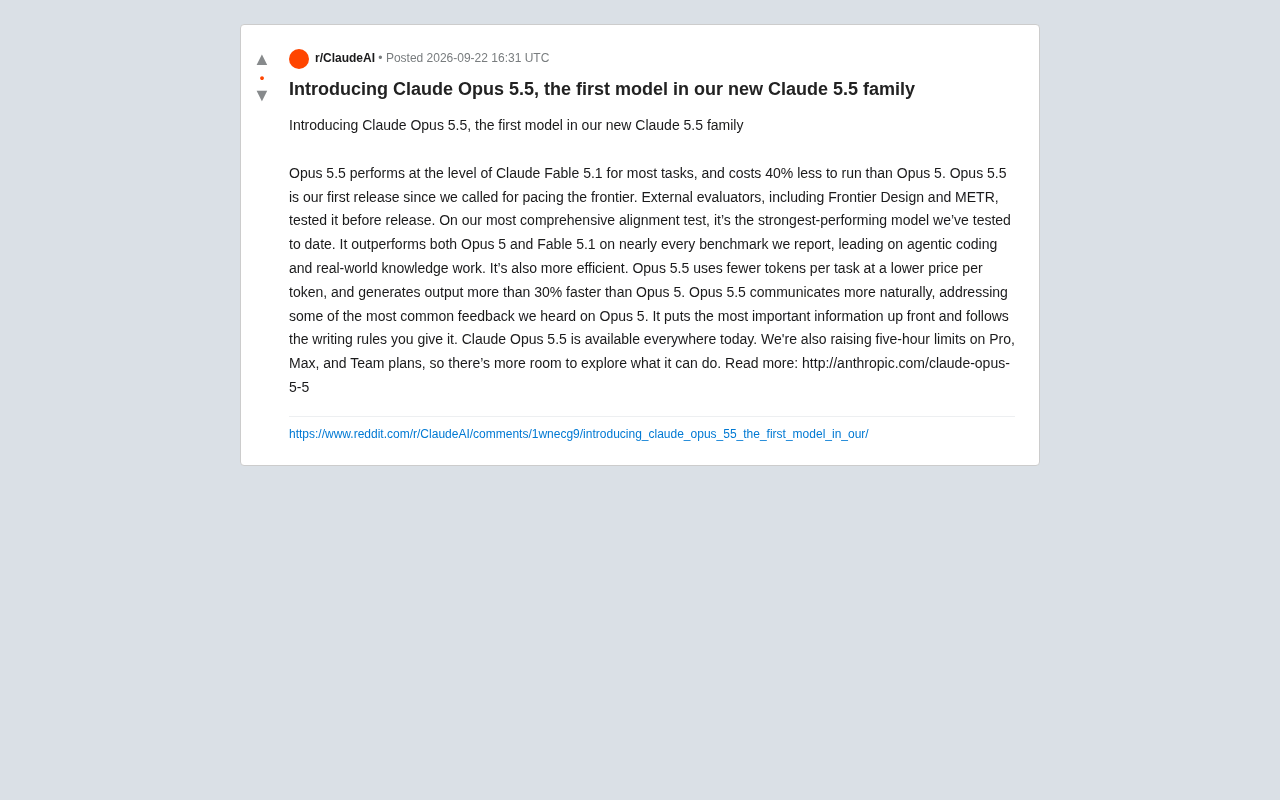
Anthropic发布Claude Opus 5.5:更快更省,对齐能力创新高
Anthropic发布Claude Opus 5.5,作为Claude 5.5家族首款模型,运行成本比Opus 5低40%、生成速度快30%以上,并在对齐测试和智能体编程等基准上全面领先。本文解析其性能、成本、安全与体验升级。
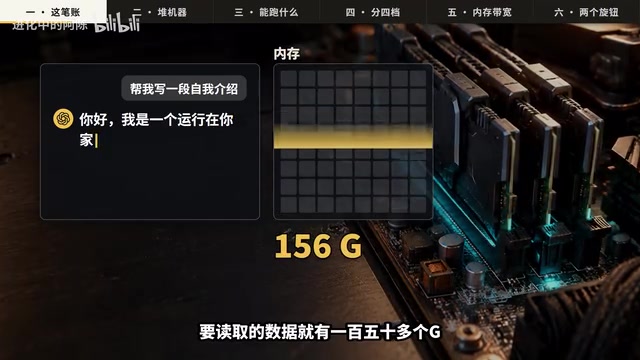
本地部署开源大模型攻略:你的电脑能跑哪款?
本地部署开源大模型该选哪款?本文按显存分档给出实用指南:从4G到32G显存分别能跑40亿到270亿参数模型,并解析量化压缩、上下文管理、MoE架构等技巧,帮你判断电脑能否跑动千问、DeepSeek等国产开源模型。
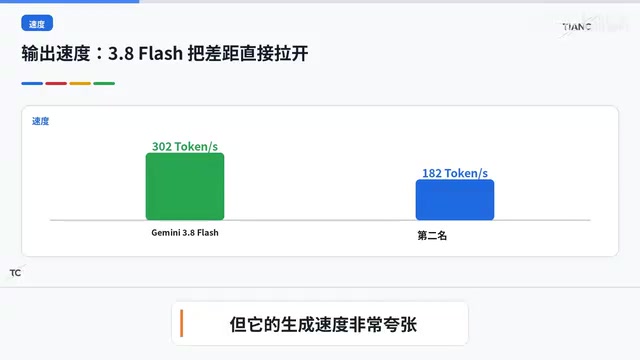
Gemini 3.5 Pro难产背后:谷歌为何疯狂押注Flash
Gemini 3.5 Pro延期难产,谷歌却疯狂迭代3.8 Flash。本文从智能、速度、单位任务成本与TPU算力能效角度,解析谷歌如何重新定义大模型战争,从军备竞赛转向工业竞赛。
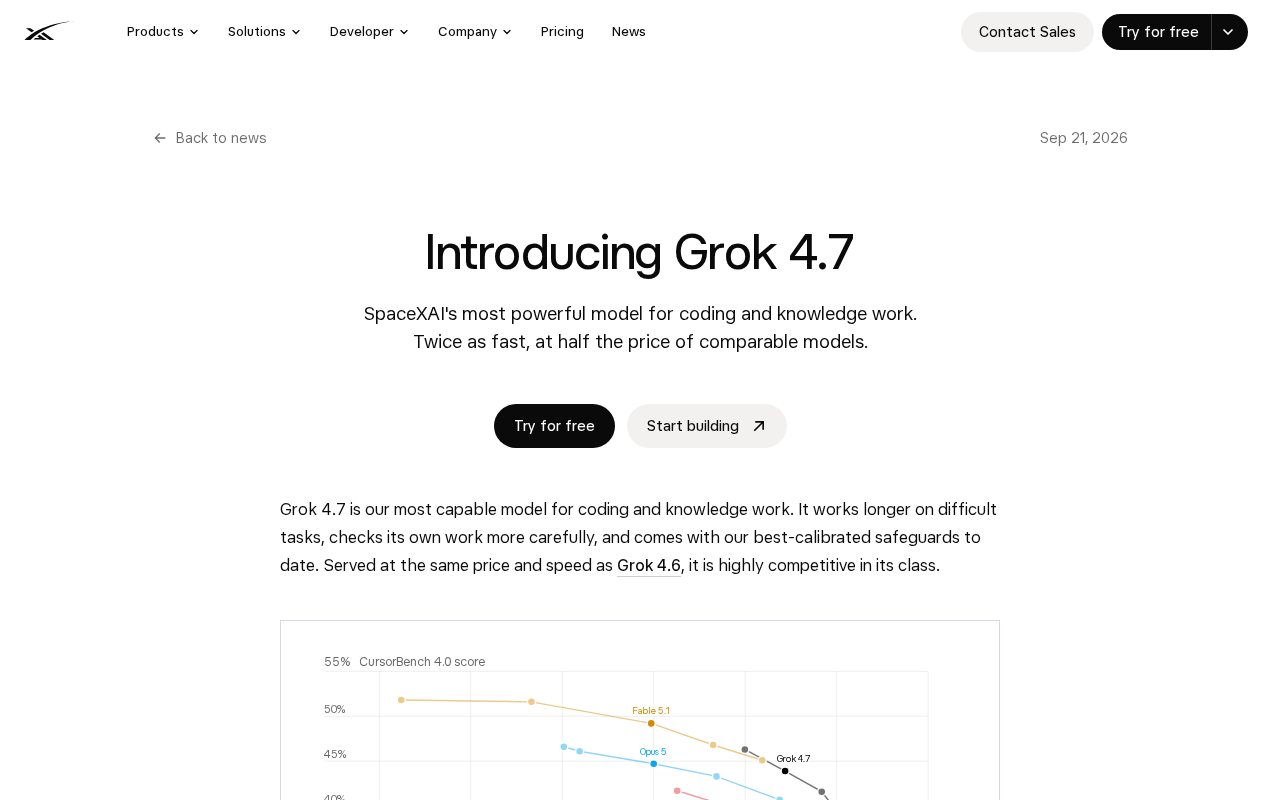
xAI发布Grok 4.7:多轮对话与创意能力升级
xAI 发布新版本大模型 Grok 4.7,登上 Hacker News 热榜引发热议。本文解析这次小版本迭代背后的竞争逻辑、社区讨论及理性评估模型更新的方法。

AI大模型零基础学习路线图:四阶段从入门到就业
针对AI大模型零基础学习者,本文拆解一套四阶段学习路线图:从认知建立、Prompt/RAG/Agent核心技术、项目落地到求职实战,帮助入门者和转型开发者少走弯路。

Agent Skills 是什么?理解智能体技能的核心构成
Agent Skills 是什么?本文结合官方定义,讲解智能体技能的核心构成——SKILL.md 文件、name 与 description 字段,以及 description 为何在大模型开发中如此关键,帮助零基础同学理解 Agent 能力扩展的底层逻辑。
从AI到大模型:零基础理清人工智能技术脉络
零基础理清人工智能发展脉络:从AI、机器学习、深度学习到Transformer与大模型、生成式AI的技术演进。解析深蓝、AlphaGo、ChatGPT等关键节点,帮普通人找到入局AI应用与智能体开发的正确路径。

零基础入门AI大模型应用开发:核心概念全解析
零基础入门AI大模型应用开发教程解析:厘清人工智能、机器学习、深度学习、生成式AI的关系,梳理监督/非监督/强化学习三种范式,解读Transformer架构与国内外主流大模型,帮助初学者建立清晰知识框架。
什么是AI Agent?一个"替人上课"的例子讲透智能体本质
AI Agent(智能体)到底是什么?本文用"替室友上课"的生活案例,讲透Agent的本质:接收命令、拆分任务、靠规则和提示调用大模型执行。厘清Agent与大模型的关系,破除对智能体的神化认知,适合零基础入门。
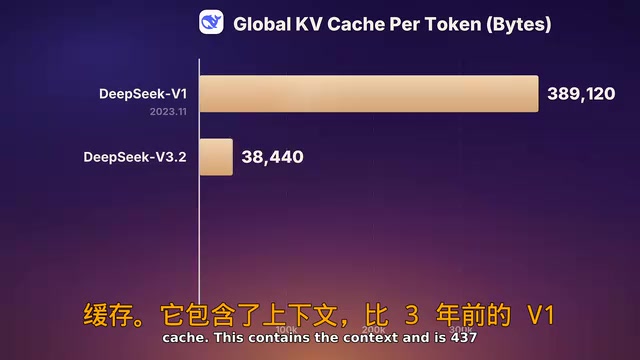
DeepSeek 4.1 Flash新架构:KV缓存压缩437倍的秘密
DeepSeek 4.1 Flash 采用全新 CSA2 技术和编码器-解码器架构,将 KV 缓存压缩 437 倍,运行速度极快且成本大幅降低。本文拆解其技术原理、性能表现与实际使用中的 Token 消耗问题。
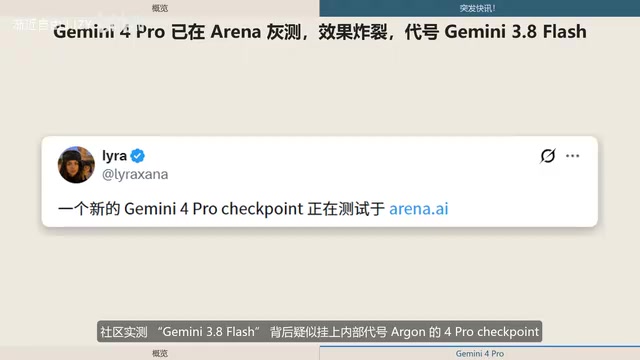
Gemini 4 Pro现身Arena灰测:3D与物理能力全面升级
谷歌 Gemini 4 Pro 疑似以内部代号 Argon 现身 Arena 幽灵测试,社区实测其 3D 空间理解、物理模拟与交互式内容生成能力大幅提升,输出上限达 256K,传闻支持 2M 上下文,对标 Astra 与 Fable 5.1。