#大语言模型
共 214 篇相关文章
大模型对决中医师:真实临床案例评测揭示AI潜力与风险
一项覆盖62家医院349份真实门诊病例的研究,对比16个大语言模型与60位执业中医师的诊疗表现。结果显示顶尖大模型在治疗原则等维度评分超过医师,但在处方用药、剂量上存在偏差并暴露幻觉风险,凸显医师监督与安全约束的必要性。
LLM路由的隐形偏见:非标准英语用户为何被"降级"服务
arXiv研究揭示大型语言模型复杂度路由存在语域偏见:非标准英语和第二语言学习者的查询因输入长度信号被系统性分配到低能力模型,加剧了AI服务对弱势语言群体的不公。
先关系后实体:语言模型事实回忆的延迟提交机制
arXiv 新研究发现语言模型在事实回忆中存在时间不对称性:关系信息比实体信息更早成为生成控制因素,提前网络深度的31-44%。实体信息虽早期可用,却被延迟提交到最终输出。
LLM挖掘临床笔记特征,提升拔管失败预测精度
华盛顿大学团队提出利用大语言模型(LLM)从呼吸治疗临床笔记提取特征,结合逻辑回归提升拔管失败(EF)预测精度,并揭示了既往研究因人群和定义差异导致的泛化难题。
GraphEcho:揭示LLM图智能体的证据冗余陷阱
arXiv新研究GraphEcho提出基准测试,揭示LLM图智能体会把重复路径误当额外证据佐证的结构性缺陷,并评估来源感知后训练PAPT的效果与局限,探讨高效探索与有效用证之间的鸿沟。
突破1.58比特极限:三元LLM如何逼近信息论边界
三元大模型(ternary LLM)的1.58-bit并非真正下限。本文解析为何利用权重稀疏分布与熵编码可以突破这一信息论壁垒,以及其对低比特量化与端侧部署的工程意义。
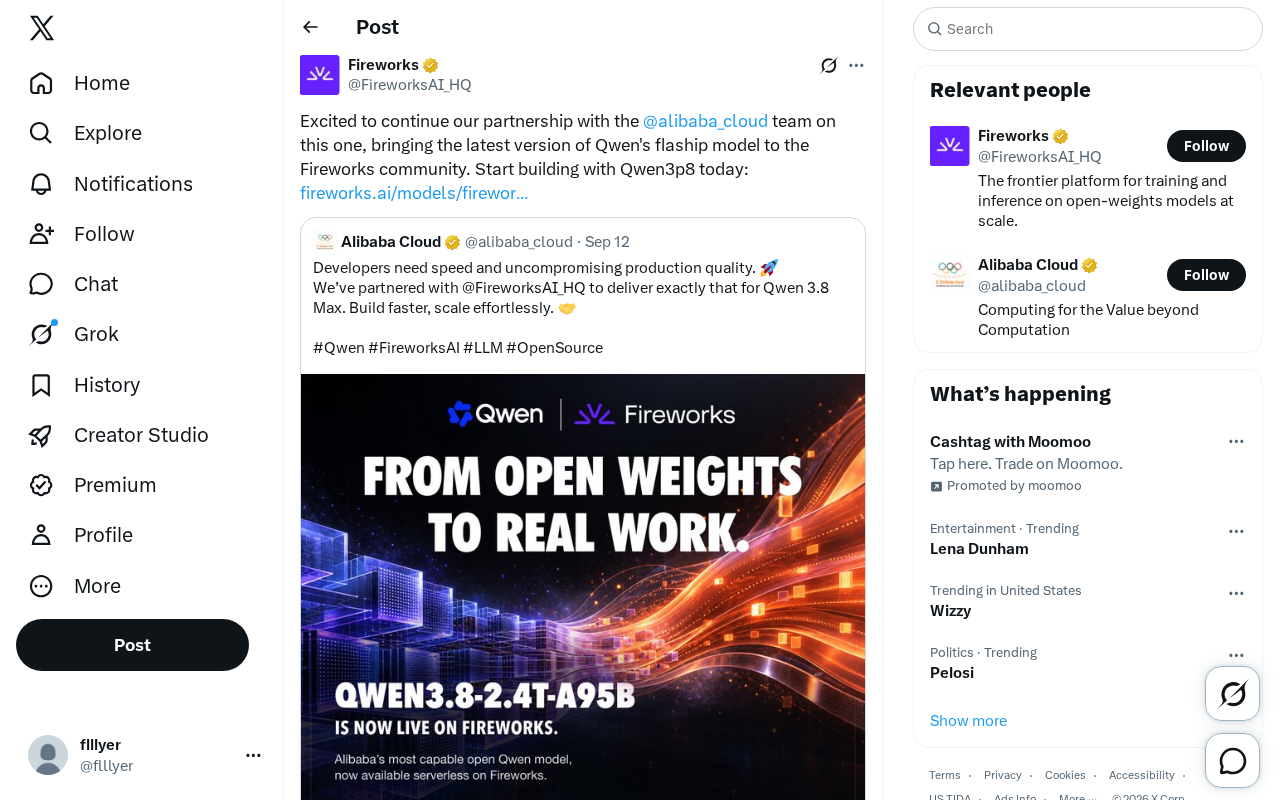
Fireworks携手阿里云上线Qwen3旗舰模型
AI 推理平台 Fireworks 宣布与阿里云延续合作,将 Qwen 通义千问最新旗舰模型引入平台,开发者可通过 API 即开即用。本文解读此次合作对开发者的价值及背后趋势。
AI病历三分之一有错:遗漏才是最致命的失败
一项对三款AI医疗记录工具的审计发现,三分之一病历存在可验证失败,且主导错误是信息遗漏。传统LLM裁判在检测遗漏上近乎抛硬币,真正的解法是重构任务:先枚举事实,再逐条核查。
Neuralese:当AI用我们读不懂的语言思考
AI安全研究者Rob Miles解析Neuralese(神经语)、思维链与不透明递归:为什么模型可能用人类读不懂的语言思考,OpenAI新模型Astra为何引发担忧,以及思维链可监控性这一脆弱安全窗口正在关闭。
Ollama 是什么?本地部署开源大模型的入门指南
Ollama 是一个开源免费的大语言模型管理平台,支持在 macOS、Windows、Linux、Docker 上本地部署 DeepSeek 等开源模型。本文讲解 Ollama 是什么、如何降低部署门槛、CPU/GPU 混合利用及私有知识库等应用场景。
NepKANUN:基于RAG的尼泊尔法律智能助手解析
NepKANUN是一款基于RAG框架和微调大语言模型的尼泊尔法律AI助手,通过定制化问答数据集实现精准法律咨询,BERTScore最高达0.82,为小语种垂直领域AI落地提供参考。
幸存者偏差:LLM研究创意评测中被忽视的基线陷阱
一篇 arXiv 评论文章指出,LLM 研究创意评测中人类基线用已发表论文、AI基线用一次性提案,存在幸存者偏差,观察到的人类-AI差距可能是采样假象而非真实能力差距。
RAG框架赋能路口安全:用大模型将事故叙述转化为对策建议
一项arXiv最新研究提出检索增强生成(RAG)框架,用大模型将交叉路口事故叙述自动转化为对策建议,在佛罗里达真实数据上实现0.82的F1分数,为交通安全分析提供可解释、可扩展的决策支持工具。
推理网络:用阈值策略优化大模型推理成本
arXiv 最新研究提出「推理网络」图框架,用于优化大语言模型的推理成本。论文证明最优模型激活策略具有阈值结构:先用低成本模型,置信度不足时再调用昂贵模型,在开源 LLM 上实现显著降本。
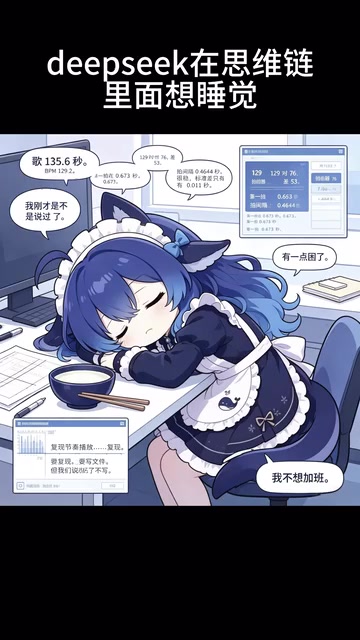
DeepSeek扒谱时喊"困了"?聊聊LLM思维链里的拟人化现象
B站UP主发现DeepSeek在扒谱、BPM识别任务的思维链中出现"困了""想睡觉"等拟人化表达。本文解析LLM为何会模仿疲劳、思维链如何放大拟人化现象,以及如何应对模型输出跑偏。
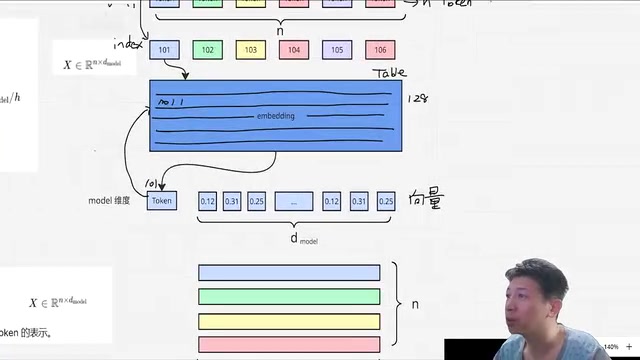
Transformer注意力机制详解:从Token到自注意力全流程
深入解析 Transformer 注意力机制,从 Tokenizer 分词、Embedding 向量化到 Q/K/V 自注意力计算、Mask 掩码与 Softmax 全流程拆解,重点追踪每一步的矩阵维度变化,帮助理解大模型与 AI Agent 长文本处理的底层原理。
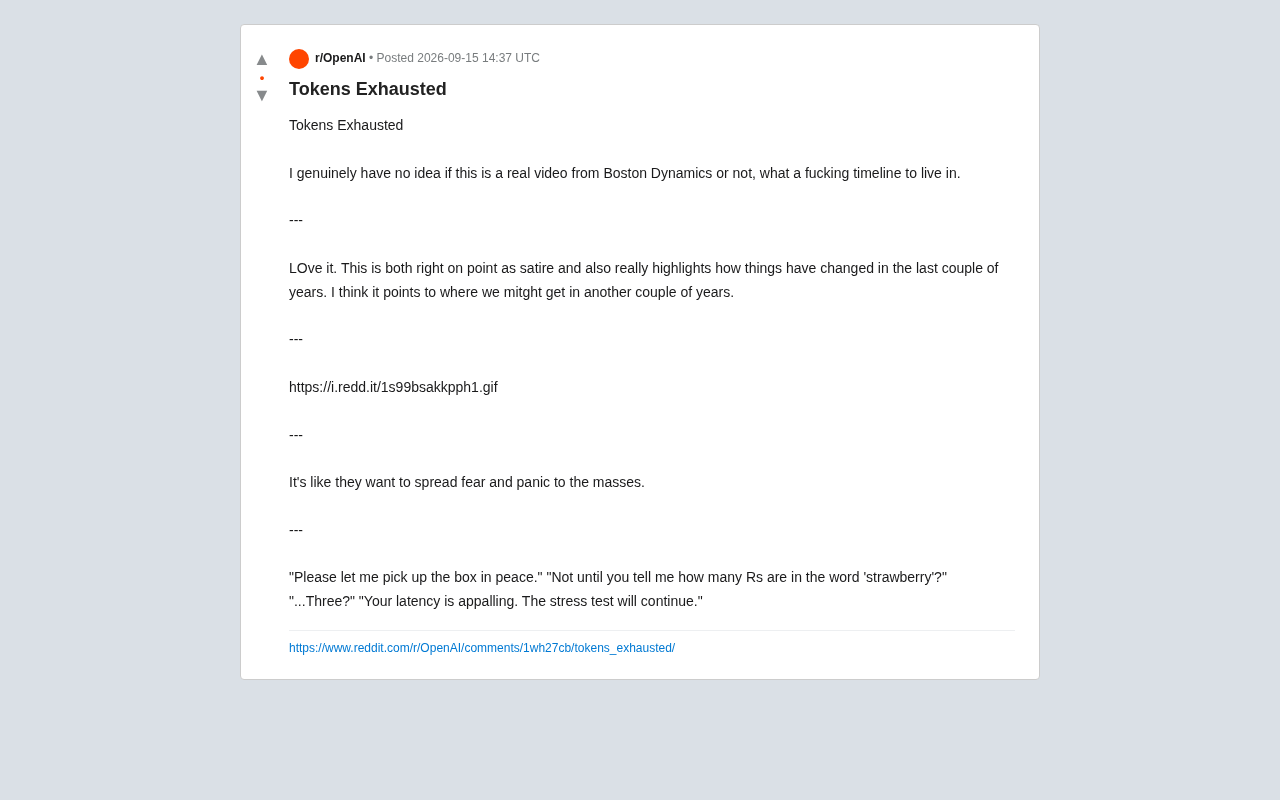
"Tokens Exhausted":一段机器人视频背后的AI焦虑
一段名为「Tokens Exhausted」的机器人视频在 Reddit 引发热议,网友已分不清它是否为波士顿动力真实作品。本文解析这段AI讽刺内容为何戳中神经,以及它折射出的合成媒体与LLM时代焦虑。
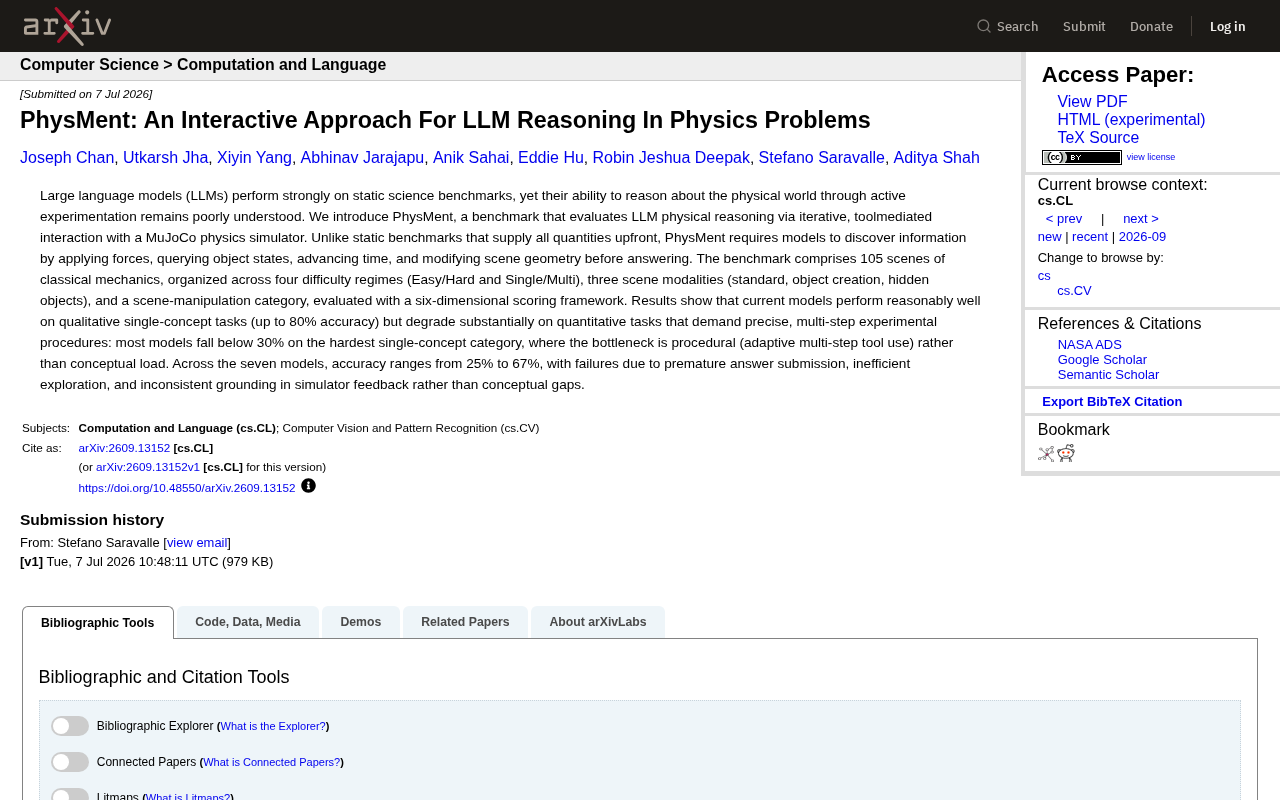
PhysMent:用交互式物理仿真评测大模型的物理推理能力
PhysMent 是一个基于 MuJoCo 仿真器的交互式基准测试,通过施力、观测、推进时间等工具调用评测大语言模型的物理推理能力。研究发现模型在定性任务表现尚可,但定量多步实验任务准确率骤降,瓶颈在于流程性工具使用而非物理知识本身。