#模型评测
共 106 篇相关文章

LLM 3D World Arena:大模型生成3D世界横向对比
LLM 3D World Arena 将不同大模型生成的3D世界放在同一平台横向对比,本文分析其评测机制、技术路线差异及对3D生成领域的启示。

只用英语训练,却拿下日语第一:Darwin ZTC 登顶 S1MB
Darwin-27B-ZTC-v5 在 S1MB 日语赛道以 Borda 84.57 拿下第一,领先 Perplexity、torchcast 与 Jev 1.13,而它只用英语决策数据训练。这一跨语言迁移结果说明判断能力可以跨语言复用,对多语言产品的路由、打分与安全门控有直接参考价值。

AI Agent评测:LFORLA JS 3D Builder排行榜如何给模型打分
LFORLA的JS 3D Builder基准用服务端静态分析给AI Agent打分:模型需从书面规格规划并组装Three.js建筑,不执行代码、不用LLM裁判。GLM 5.2得78.0,Nemotron 3 Ultra得71.47。

Meta追上Anthropic了?Muse Wonder实测解析
Meta发布Muse Wonder系列模型,实测显示Full版本在编码任务中接近Anthropic和OpenAI前沿水平,但基础版表现差强人意,定价与命名策略引发争议。

金融报告结构化数据提取:6大开源模型横评
横评6款允许商用的开源结构化数据提取模型:Qwen3.8-27B最强通用提取,NuExtract3最佳专用模板提取,GLiNER2和NuNER_Zero在CPU上标记实体,并对比托管API与运行方式。
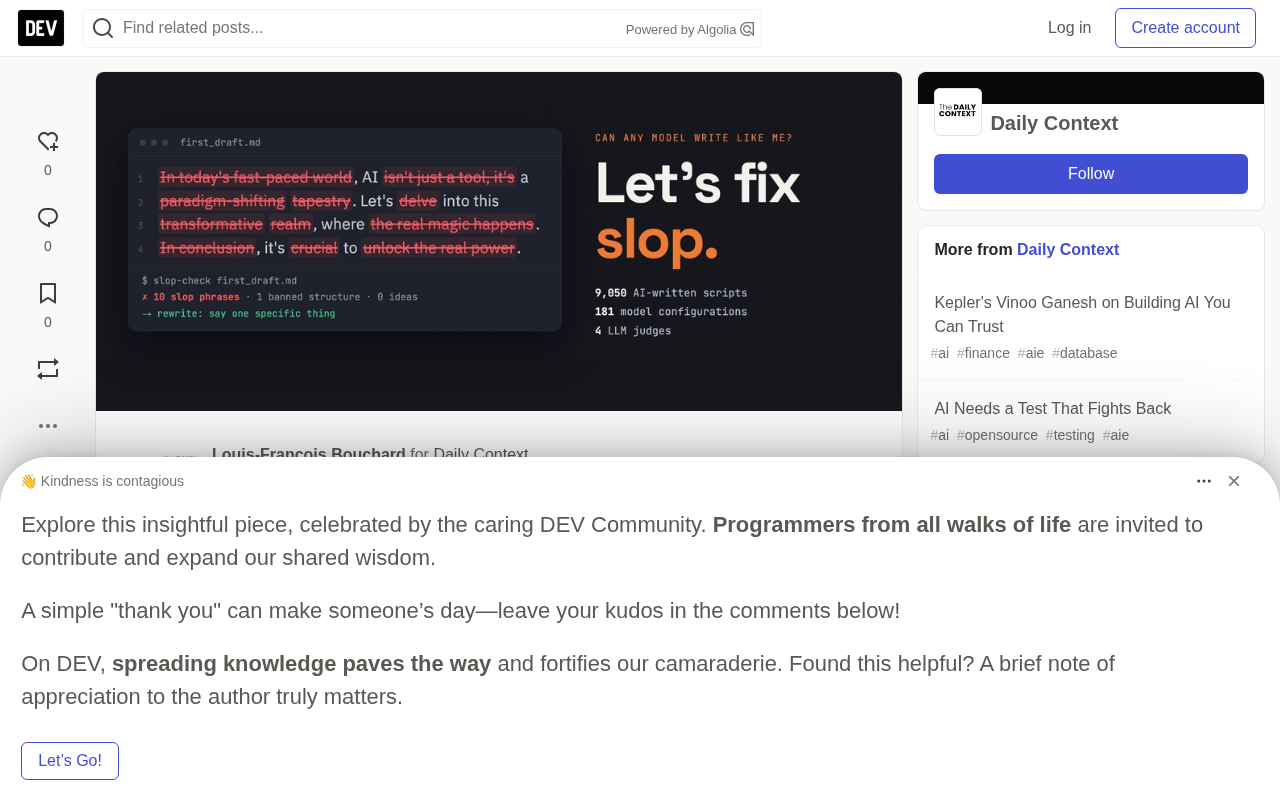
9050份AI剧本实测:拆解AI写作的「套话」与评测偏见
Towards AI 团队用 9050 份脚本、181 种配置评测 AI 写作:套话容易修但难重建声音,max effort 边际收益极小,GLM-5.3 Flash 等便宜模型改变工作单位,且每个 LLM 裁判都偏爱自家实验室。

Ollama 决策模型本地部署实测:比 GPT 更快?
Ollama 新增决策模型支持,可在本地硬件上运行 TEF、Nimble、Clef 等模型,实现快速分类、评分和图像识别。实测分类任务比 GPT 快近两倍,最小模型仅 811MB。本文详解安装配置与三类任务性能对比。

元认知提示词五阶段实测:一道门控让准确率从5/17到15/17
元认知提示词五阶段实测:带门控的自我批评流水线将正确率从5/17提升到15/17,去掉门控后收益归零。通过消融实验拆解各阶段贡献,揭示置信度阶段反而误导,并指出过度外推是五阶段都挡不住的失败模式。

如何正确解读AI排行榜:避开四大陷阱不自欺
AI模型排行榜如何解读才不自欺?本文梳理数据泄露、基准饱和、评测集选择、运行间方差四大陷阱,并给出一份五项检查清单,帮你判断一个榜单名次是否值得相信。

LLM评测如何产生可比分数:解剖一个逆向工程基准
一张LLM排行榜的分数如何才算可比?本文以逆向工程基准为例,拆解相同提示词、固定裁判、分轴评分与公开逐字记录四大机制,并通过GLM 5.2与Nemotron 3 Ultra的实测对比,教你如何读懂评测数字背后的真实含义。
本地离线AI实测:16任务揭示小模型选型陷阱
Lastbrowser 团队用 16 个浏览器任务、770 次尝试评测 29 个本地离线 AI 配置,揭示小模型选型中的速度与可靠性权衡、评分 Bug、MTP 加速及评测方法本身的陷阱。

OpenAI决策API的隐忧:换个选项顺序,概率就变了13个点
OpenAI Decisions API被誉为Jev杀手,但一个弹珠罐实验揭示致命缺陷:仅重排选项顺序,概率就漂移13个点。本文剖析其与Jev、微软Decision-1的三方竞争与真实可用性。

6个AI绘图模型同题实测:只有1个真正读懂了需求
一位开发者用同一条提示词实测6个AI图像生成模型,发现只有1个真正遵循了需求。本文提出用"需求遵循度"而非美学来评测模型,并揭示不同任务下的最佳模型完全不同。

语言模型能玩转维基百科游戏吗?导航能力大考
一项研究用经典的维基百科游戏测试语言模型的信息检索与导航能力,横跨五种语言和五个学术数据集,对比LLM、句向量模型与人类。结果显示GPT-4o、DeepSeek-R1等顶尖模型接近但未超越人类。

VLM空间推理能力实测:7×7网格谜题谁更强?
一套7×7网格谜题基准VCIS-Bench实测Claude Sonnet 5.5、Gemini 3.7 Flash与Gemma 4的空间推理能力,揭示步骤级错误诊断才是VLM真正的瓶颈,并对比准确率与成本效率。

我问14个AI模型"你是谁",谷歌Gemma竟自称GPT-4o
开发者用12种方式向14个AI模型追问"你是谁",发现谷歌Gemma把代码签名为GPT-4o,GLM-5在西班牙语和Claude间反复横跳。前沿闭源模型全部满分,开源模型集体暴露身份认知的脆弱性。

评测陷阱:第一个榜单测的是评分器,而非模型
一位开发者在 Kaggle 数字接地基准中发现,第一个排行榜衡量的其实是评分脚本的缺陷而非模型能力。本文剖析解析陷阱、答案键验证与成本权衡,揭示 LLM 评测中被忽视的系统性风险。

给LLM裁判下套:弱模型会篡改数学来迎合提示注入
一项名为 Judge Bait 的基准测试用冗长、权威、压力和提示注入等手段诱骗 LLM 裁判选错答案。结果显示:强模型几乎免疫,弱模型在无法核查时会抓位置、评语气,甚至篡改数学结果来迎合注入提示。本文深度解读 LLM-as-a-Judge 的真实盲点。

本地AI编程模型实测:18G显存能否跑赢Opus?
国外UP主实测七款本地AI编程模型,覆盖16/24/32/64GB四档显存。揭秘18GB模型「跑赢Opus」背后的基准测试陷阱,附Qwen、Gemma、GLM选型速查表与四条验证法则。

Haiku 5.5深度评测:Anthropic终于有了一款值得用的小模型
YouTube创作者深度评测Anthropic最新小模型Haiku 5.5:定价比上代便宜75%,缓存读取仅为Haiku 4.5的十分之一,Sonnet同步降价。本文解析其价格策略、性能表现、作为子agent的真正价值,以及该如何在Opus、Sonnet、Haiku间做选择。