#本地部署
共 460 篇相关文章

8G显存本地跑Qwen3.8-27B:保姆级部署与AI视频创作教程
Qwen3.8-27B 是阿里新一代开源权重模型,在 Artificial Analysis 复杂能力榜排名第26。本文详解如何用 LM Studio 在 8G 显存本地部署,并接入 ComfyUI 为 MiniMax 视频工作流生成提示词,附新手友好的保姆级教程。
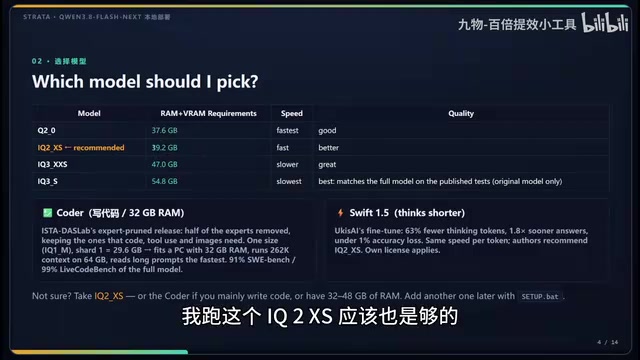
8G显存本地跑125B大模型:Qwen3 Flash部署实战
基于Scrata框架在8G/12G显存显卡上本地部署Qwen3 Flash大型MOE模型的完整实战指南,涵盖模型量化选择、国内镜像站下载避坑、思考强度配置等关键步骤,32G内存起步即可运行。

Strata神项目实测:12G显卡本地跑176B千问大模型
开源项目Strata通过GPU+CPU+内存+SSD三层存储整机协同,让12G显卡也能流畅跑176B的Qwen3.8 Flash Next大模型,短聊天速度达93 token/s。本文详解其核心技术、量化档位选择与部署方法。

单张RTX 5090跑125B大模型:Strata实测Qwen3.8 Flash Next
开源框架Strata让单张RTX 5090搭配64GB内存成功运行1250亿参数的Qwen3.8 Flash Next,实测短对话解码每秒113 Token。本文解析其MoE专家调度、KV缓存分层与MTP投机解码三层机制及部署门槛。
Qwen3.8-Flash-Next无审查版本地部署教程:8GB显卡跑大模型
本文详解Qwen3.8-Flash-Next无审查版大模型的本地部署全流程,涵盖Strata推理引擎、MTP加速配置、量化版本选择与8GB显卡运行实测,并客观分析这类本地模型的能力与风险。

A卡部署Qwen3实战:Strata引擎本地跑大模型全流程避坑指南
本文完整记录在AMD RX 7900 XTX显卡上使用Strata引擎部署Qwen3.8 Flash大模型的全过程,涵盖分支选择、多线程下载、HipBLASLt调优表对齐、CPU图像识别及版本升级,重点剖析A卡部署的关键坑点与性能数据。

RTX3090极限挑战125B大模型:三级缓存让推理提速5倍
RTX 3090(24GB显存)加24GB内存部署125B参数Flash Next大模型实测:通过三级缓存、Q2K量化和计算重叠三步优化,生成速度从每秒1.83个token提升到9-10个,峰值18。深度解析MoE模型本地部署的带宽瓶颈与优化思路。

RTX 3090实测Qwen3 27B:峰值60 Token/s能跑动吗
RTX 3090实测Qwen3 27B大模型:Q4量化、MTP加速峰值超48 token/s,四路并发吞吐125.5 token/s,并接入Agent成功做出坦克小游戏。附24GB显存本地部署的量化选择、长上下文天花板与实操建议。

Strata本地实测:180B MoE大模型塞进12GB显卡
Strata本地推理引擎实测把180B级Qwen3.8-Flash-Next MoE模型跑在12GB消费级显卡上,通过稀疏激活、GSQ量化与专家三层缓存实现90+ tokens/秒。本文解析其技术原理与长上下文性能表现。
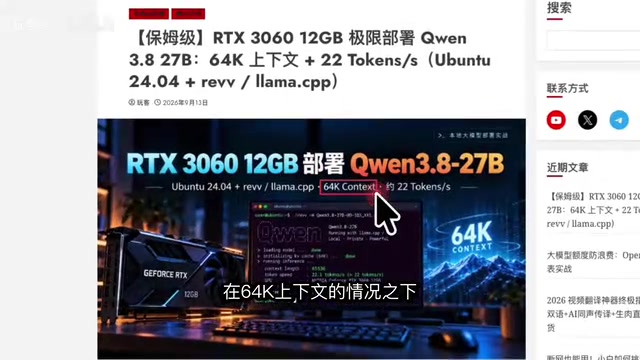
RTX 3060 12G实测Qwen3 27B:64K上下文稳跑22 t/s
RTX 3060 12G 显卡实测部署 Qwen3 27B 大模型:基于 Ubuntu 与 llama.cpp,64K 上下文稳跑 22 token/s,32K 可达 28 token/s。详解 Q4/IQ3 量化精度损失、硬件功耗与部署流程,低成本本地大模型方案参考。

32GB显卡本地跑大模型:AMD R9700 对决 Intel B70
海外博主实测 AMD Radeon AI Pro R9700 与 Intel Arc Pro B70 两张 32GB 显卡本地跑大模型的真实差异:密集模型 AMD 领先 60%,MoE 场景打平,软件生态是最大分水岭。附每 token 成本与选购建议。
树莓派5实测8款本地大模型:仅3款真正可用
树莓派5实测8款本地大模型,从速度到实用任务全面评估。仅Gemma 2B、Gemma 4B、Granite三款真正可用,附完整测试标准与选型建议。

本地AI编程实测:Agent真能修Bug还是改错代码?
海外博主实测本地AI编程Agent的真实能力:从Ollama、Continue到Qwen3-Coder、GPT-OSS,哪种组合能真正修Bug而非改错代码?本文拆解本地编程工作流、上下文瓶颈、工具可靠性与硬件门槛。

本地大模型跑分骗局:你需要的四个真实指标
国外博主自建LLM测试框架实测本地大模型集群,揭穿tokens-per-second跑分的误导性。本文拆解本地大模型该测的四个真实指标、Ollama测试陷阱与五个实测意外,教你用测量结果而非厂商幻灯片做部署决策。
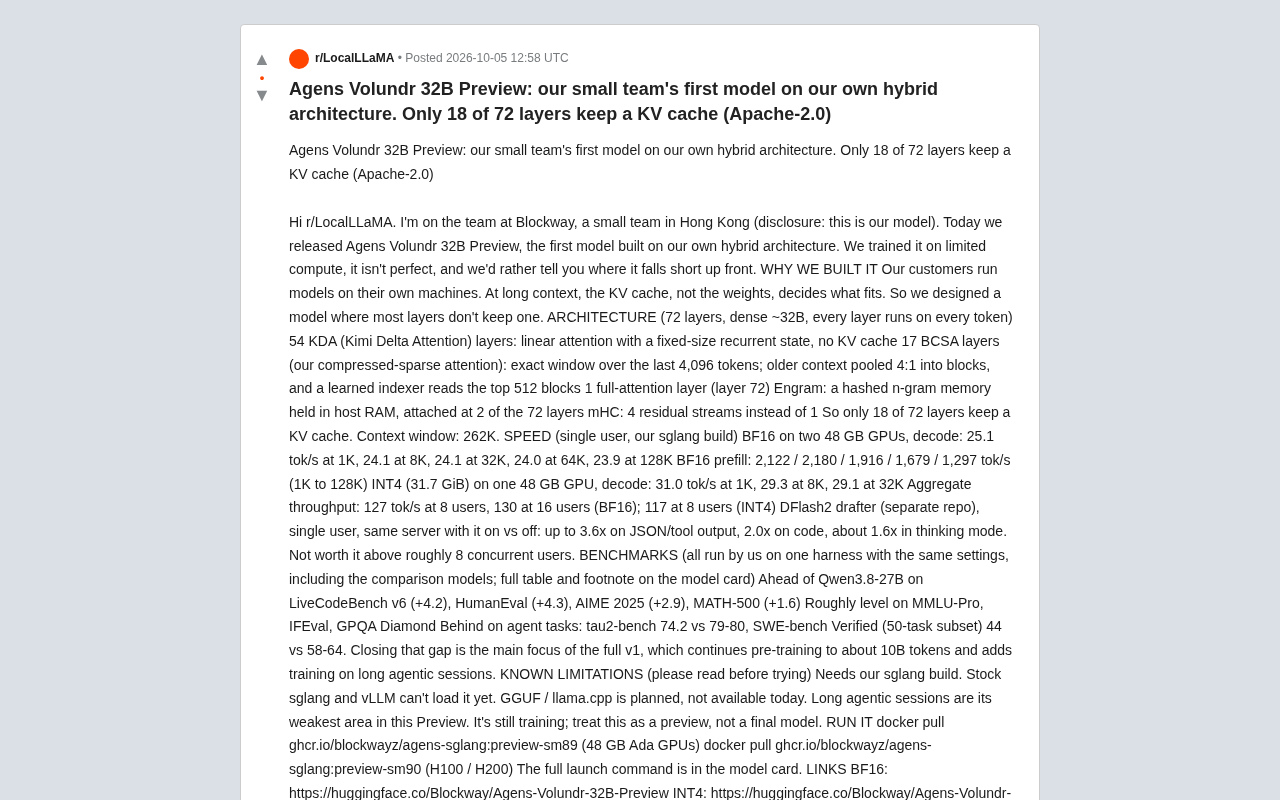
Agens Volundr 32B:72层仅18层保留KV缓存的混合架构实践
香港团队 Blockway 发布 Agens Volundr 32B Preview,基于自研混合架构,72 层仅 18 层保留 KV 缓存,支持 262K 上下文,Apache-2.0 开源。本文拆解其 KDA/BCSA 混合注意力设计、速度与基准表现。
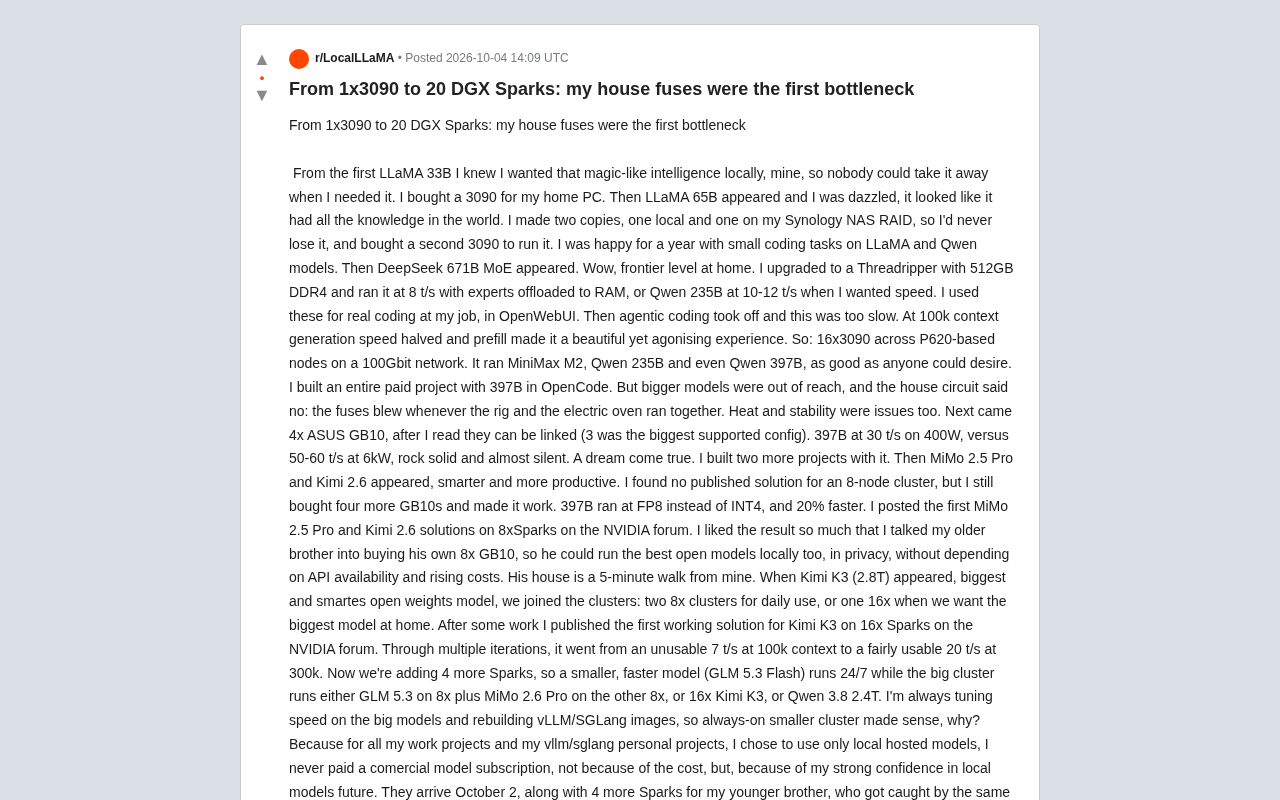
从1块3090到20台DGX Spark:本地大模型玩家的硬件进化史
一位Reddit用户记录了从单块RTX 3090到20台NVIDIA DGX Spark的本地大模型部署进化史,涵盖MoE内存卸载、多卡功耗瓶颈、保险丝跳闸,以及如何在家用集群上跑通Kimi K3等万亿参数开源模型。
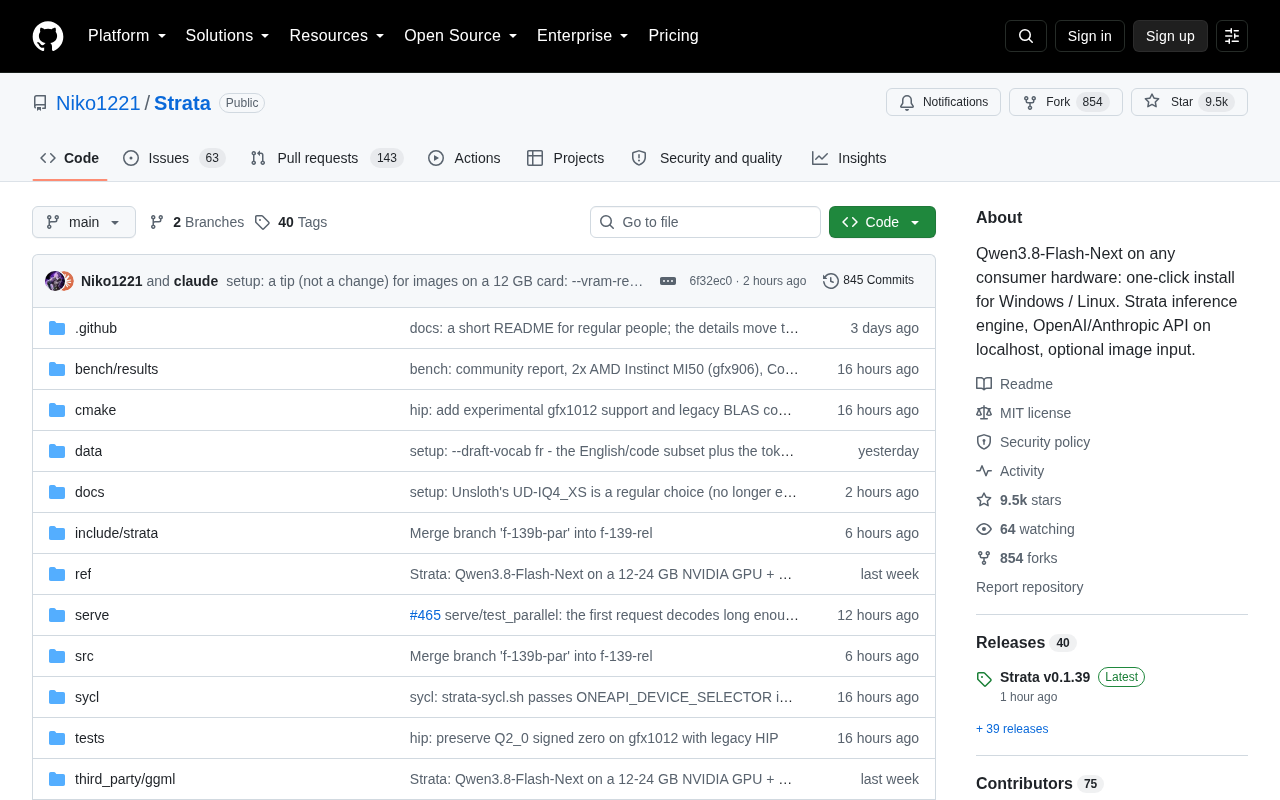
RTX 4090 跑 125B 大模型:Qwen3 Next 实现 100 T/s 推理
开发者在单张 RTX 4090 消费级显卡上运行 125B 参数的 Qwen3 Next Flash 模型,实现约 100 tokens/s 推理速度。本文解析 MoE 架构、量化技术如何让千亿大模型落地消费级硬件。

6GB跑27B大模型?Bonsai 2三值量化的真相与局限
Prism ML的Bonsai 2号称6GB显存保留Qwen3-27B 98%性能。实测显示短任务确实打平,但长链agentic构建全线崩溃。本文剖析三值量化原理与压缩技术的真实局限。