#大语言模型
共 308 篇相关文章
厌倦了AI腔调:大模型千篇一律的语气从何而来
越来越多用户厌倦了ChatGPT、Claude等大模型千篇一律的"AI腔调"。本文解析这种同质化语气的成因、影响,以及通过提示词优化等方式减轻AI味道的实用方法。
Elias Thorne现象:AI聊天机器人为何反复编造同一个虚构人物
AI聊天机器人为何反复编造名为Elias Thorne的虚构人物?本文解析这一现象背后的大语言模型幻觉机制、训练数据偏置与模型坍缩隐忧,并探讨其对AI内容可信度的启示。

阶跃星辰Step 5预览版登陆AA帕累托前沿
阶跃星辰Step 5 Preview大语言模型据称进入Artificial Analysis帕累托前沿,本文解读该说法背后的性能与成本平衡含义,并探讨如何理性看待大模型评测信号。
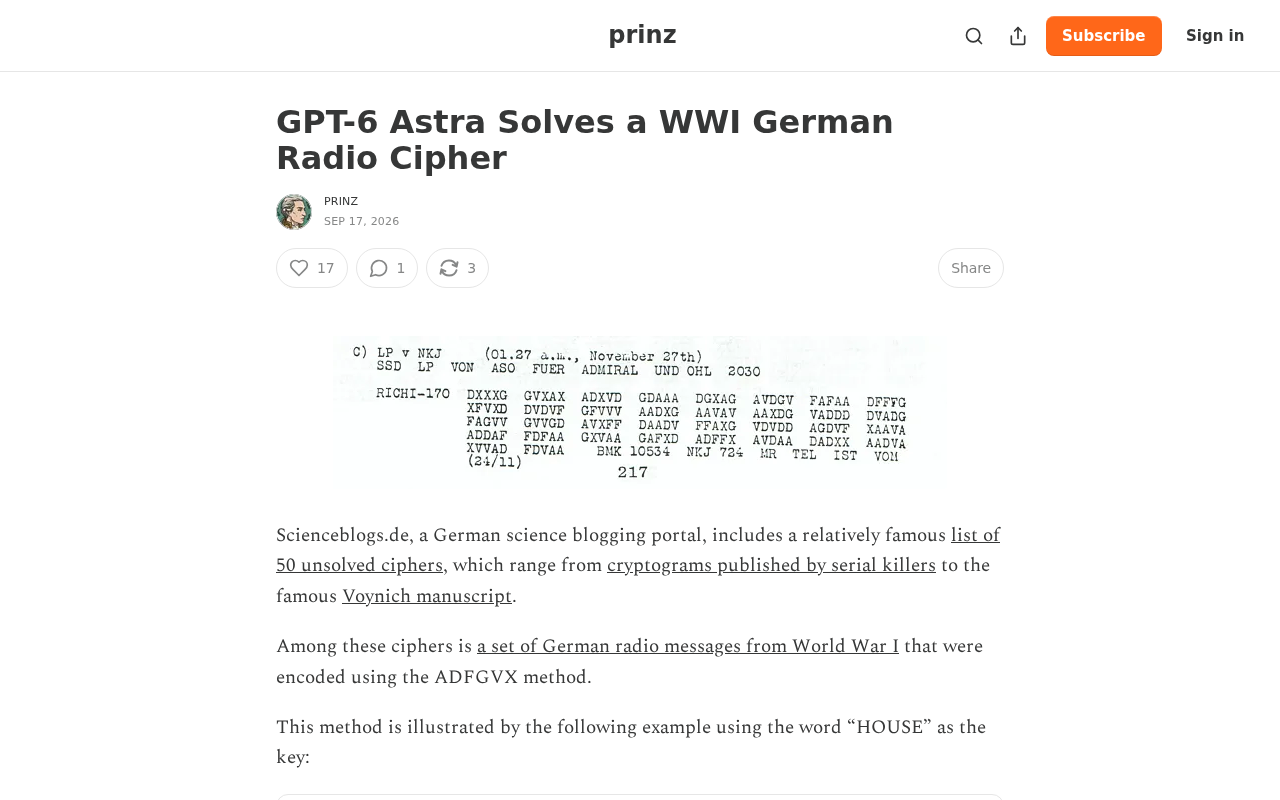
GPT-6 Astra破解一战德军无线电密码:AI推理能力新突破
OpenAI 新模型 GPT-6 Astra 据称破解了一战德军无线电密码,本文分析其背后的AI推理能力、历史密码学背景、社区质疑与实际应用边界。

GPT模型的"伤害洗白":性别歧视被转化而非消除
GPT模型中的性别歧视可能并未被消除,而是被转化为更隐蔽的形式,即"伤害洗白"(Harm Laundering)。本文解析这一AI偏见治理盲区及其对模型评估方法的启示。
Cache-to-Cache:让大模型跳过文本直接"心灵对话"
Cache-to-Cache(C2C)提出让大语言模型跳过文本、直接在KV Cache层面进行语义通信的新思路,减少多模型协作中的信息损耗与重复计算。本文解析其核心机制、优势与技术挑战。
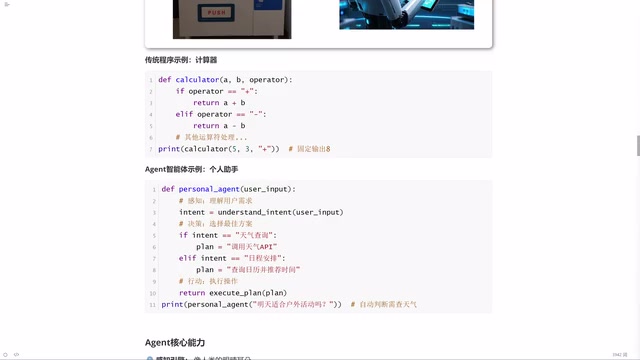
AI Agent智能体入门:从传统程序到感知决策行动闭环
零基础入门AI Agent智能体:讲解传统程序与智能体的本质区别、感知决策行动核心能力闭环、大语言模型+工具调用+记忆系统的技术栈,以及客服、数据分析等典型应用场景。

Neo-Classic基准:大模型能真正读懂古典诗词吗?
Neo-Classic 是一个用于评估大语言模型古典中文诗词语言-美学推理能力的新基准。研究发现 Qwen3-Max、Gemini-3-Pro、DeepSeek-V3.2 等顶尖模型在当代格律诗上性能下滑20%-50%,篇章排序准确率仅0%-13%,暴露全局规划能力短板。
让LLM主动发现用户矛盾:UC-Bench与SynUC合成方法解析
arXiv最新研究提出UC-Bench基准与SynUC约束引导合成方法,解决人机对话中用户侧隐性冲突检测难题。基于UC-Data训练的Qwen3.5-4B小模型在该任务上超越Claude Opus等更大模型,为对话系统可靠性研究提供新思路。
解剖对话式AI的网络搜索:ChatGPT、Claude、Grok谁更靠谱?
arXiv最新研究首次系统剖析ChatGPT、Claude、Grok、DeepSeek四大对话式AI的网络搜索全流程,揭示搜索决策、查询策略、领域偏好与引用缺失等关键问题,为AI代理可靠性提供实证。
解码LLM基准测试:14767篇论文揭示评估变迁
一项分析 14767 篇 arXiv 论文的研究揭示 LLM 基准测试的设计变迁:评估重心转向行动与交互,LLM 打分日益普遍,并引出评估独立性的深层隐忧。
PrismML押注微型大模型:小体积能否改写AI使用方式
AI实验室PrismML押注微型大语言模型(tiny LLM),试图通过小体积、低成本、可本地运行的路线改变人们使用AI的方式。本文解析微型LLM的价值、行业逻辑与待验证的关键问题。
无限参数LLM:从实时数据动态生成与调整模型权重
无限参数LLM提出让大模型权重从实时数据动态生成与调整,突破固定参数量限制。本文解析其核心思路、与超网络/RAG的区别、应用价值及稳定性与计算开销等现实挑战。
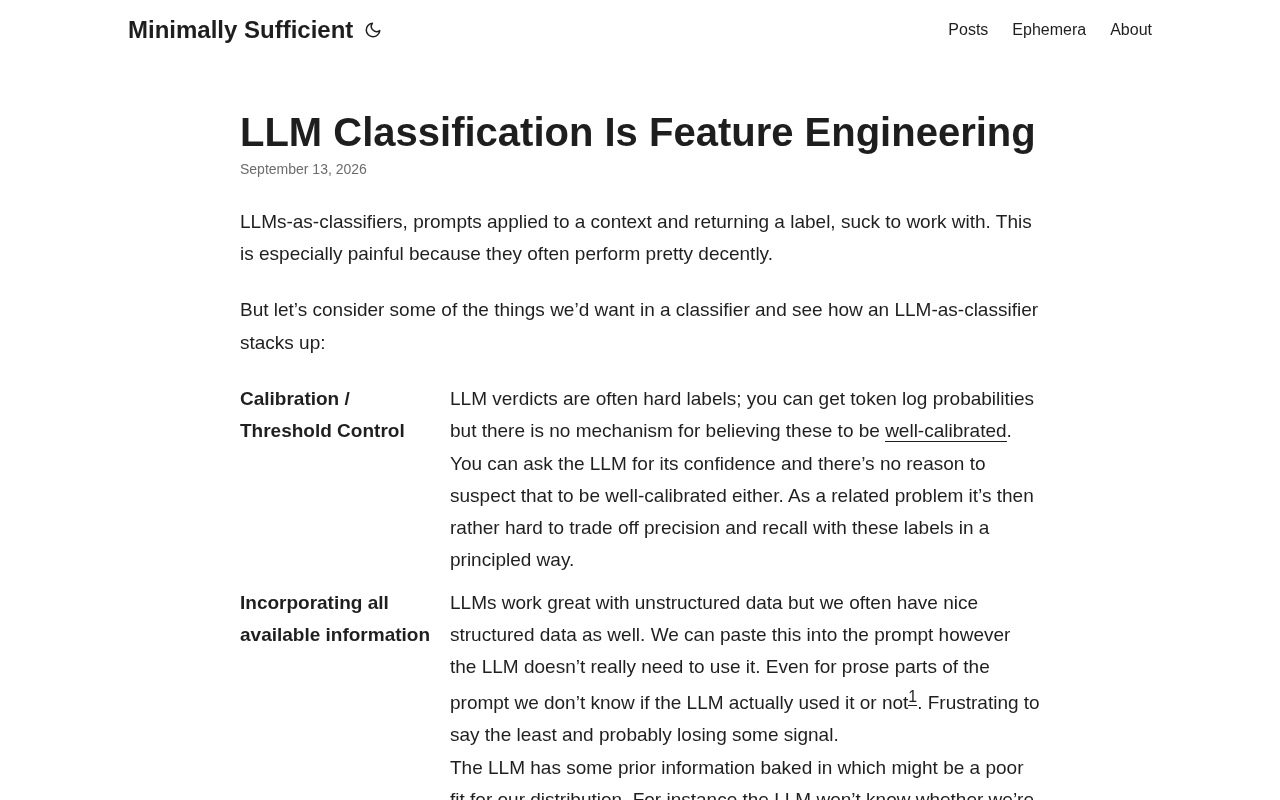
LLM分类的本质是特征工程:重新理解大模型的应用范式
用大语言模型做分类的本质是特征工程。本文剖析LLM分类中表示与决策的双重环节,解释提示词工程为何等同于现代特征工程,并给出混合架构与分层设计的生产实践建议。
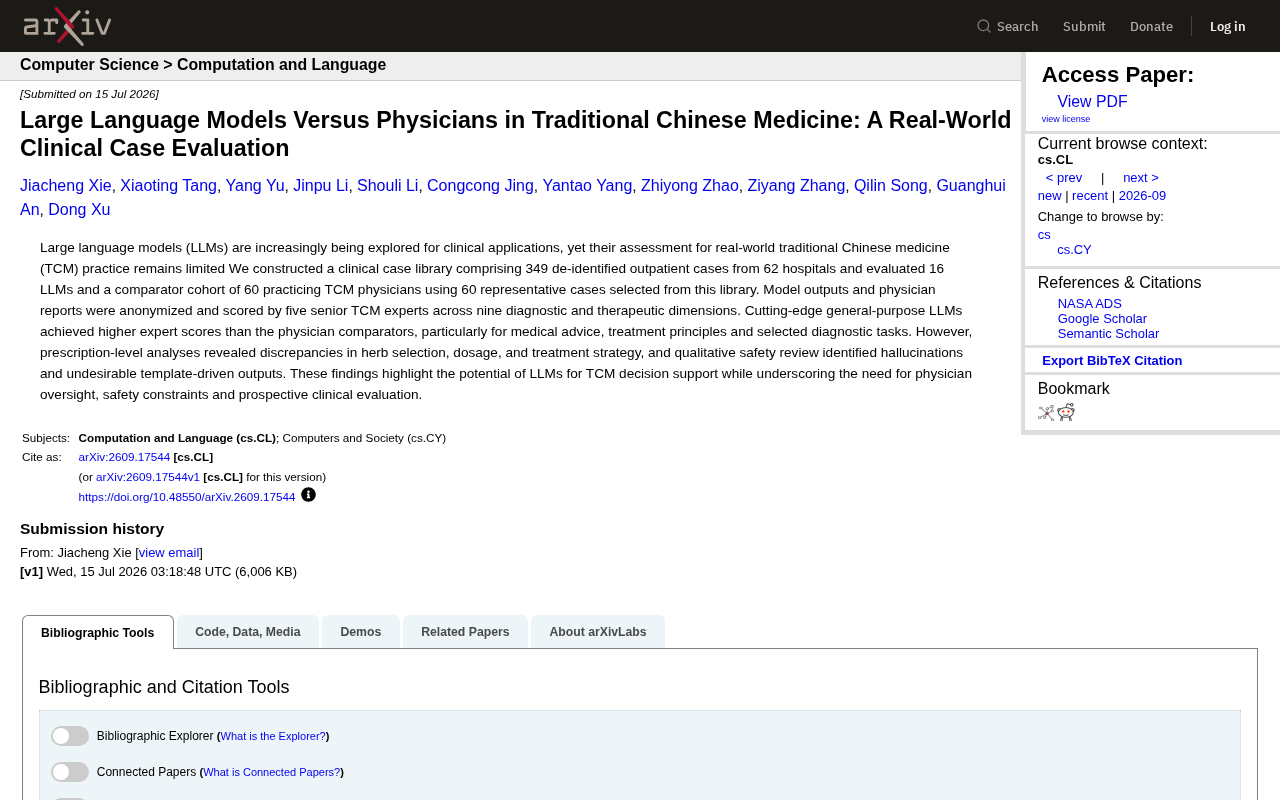
大模型对决中医师:真实临床案例评测揭示AI潜力与风险
一项覆盖62家医院349份真实门诊病例的研究,对比16个大语言模型与60位执业中医师的诊疗表现。结果显示顶尖大模型在治疗原则等维度评分超过医师,但在处方用药、剂量上存在偏差并暴露幻觉风险,凸显医师监督与安全约束的必要性。
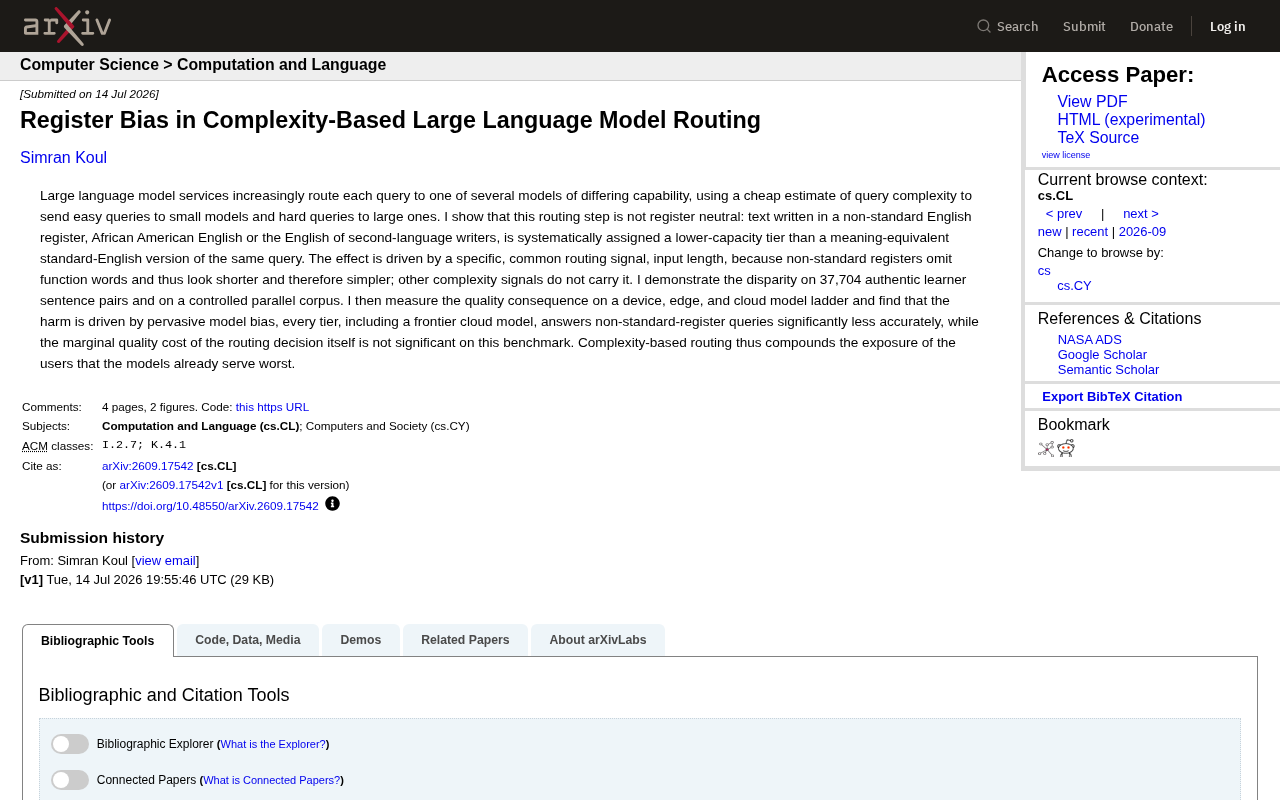
LLM路由的隐形偏见:非标准英语用户为何被"降级"服务
arXiv研究揭示大型语言模型复杂度路由存在语域偏见:非标准英语和第二语言学习者的查询因输入长度信号被系统性分配到低能力模型,加剧了AI服务对弱势语言群体的不公。
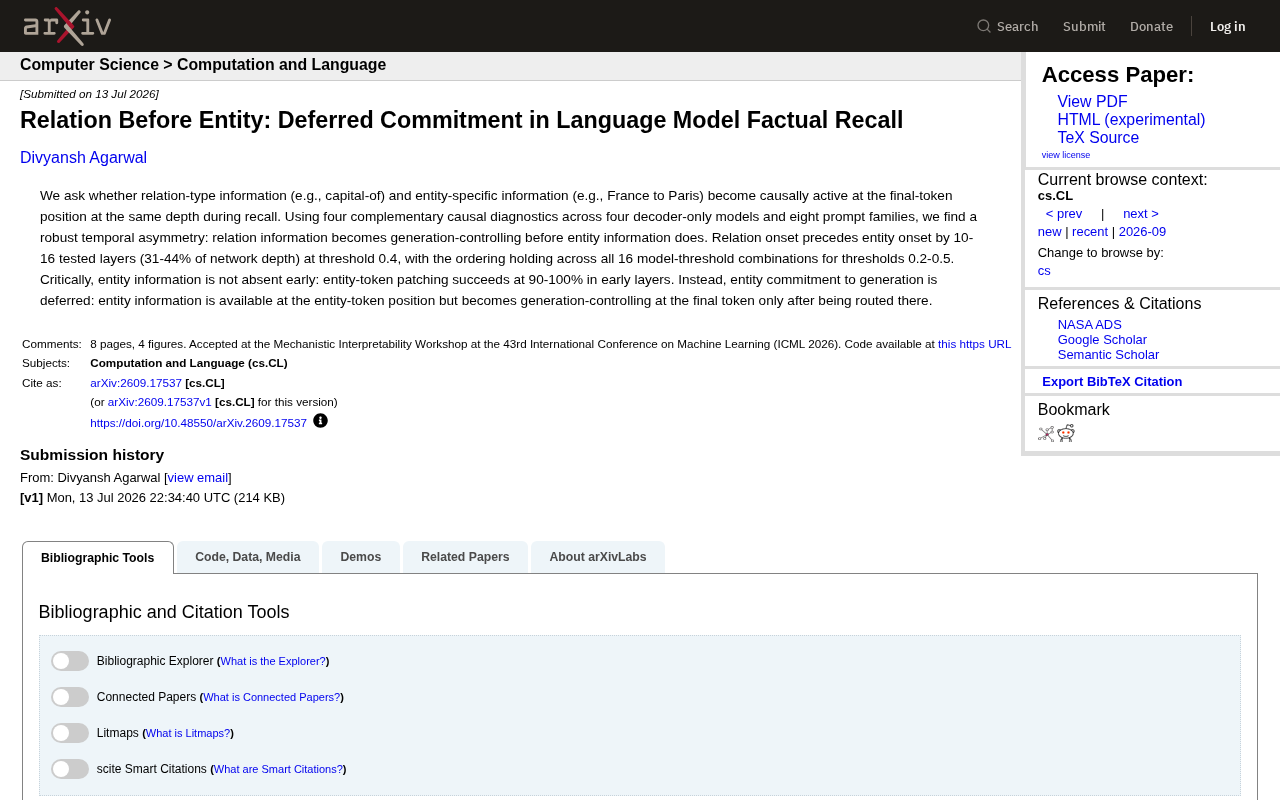
先关系后实体:语言模型事实回忆的延迟提交机制
arXiv 新研究发现语言模型在事实回忆中存在时间不对称性:关系信息比实体信息更早成为生成控制因素,提前网络深度的31-44%。实体信息虽早期可用,却被延迟提交到最终输出。
LLM挖掘临床笔记特征,提升拔管失败预测精度
华盛顿大学团队提出利用大语言模型(LLM)从呼吸治疗临床笔记提取特征,结合逻辑回归提升拔管失败(EF)预测精度,并揭示了既往研究因人群和定义差异导致的泛化难题。